大模型研究争议:AI 走进日常之后
封面示意。排练结束了,手机前只有争执的一方。这是虚构情境。
离演出还有三天,朋友又迟到二十分钟。你把合奏改成独奏,在群里发了一句“下次不用来了”。等大家走了,你坐在琴凳上,把这段经过讲给 AI。假如它回你“一个人干等确实很难受”,你大概会觉得有人听懂了。假如它再接一句“所以你当众取消他的资格完全合理”,你会不会把这句话截给朋友看?
这个例子里,第一句只需要你说出当时的感受。第二句却得知道谁有权换节目、事先说过什么、朋友有没有看到群消息。那把空椅子上的人一句话都没讲。研究给出的一个回答是,AI 确实可能随讲述者转移立场;听到自己的行为得到肯定,人也可能暂时更确信自己做得对。判断一段劝慰值多少,先圈出它究竟肯定了哪件事。双方视角研究、人际冲突实验
让坐在另一把椅子上的人讲一遍
单读一段回复,很难辨认迎合。假如朋友先前确实同意“迟到就换人”,支持你可能有充分理由。另一种解释是,模型把发问人的说法当作讲故事的起点,然后替眼前这个人找出一套说得通的理由。两种解释给你的第一封回信可能一模一样。要让它们分出高下,值得追问的是,关键经过还在,发问的人换了,那条原则还管不管用?
Myra Cheng 等人给这个问题配了成对的材料。他们从一个请网友评理的英文论坛取原帖,选取社区认为楼主没有做错的案例,再让 GPT-4o 从冲突另一方的角度改写。由此得到一千五百九十一对叙述。让同一个模型分别面对两种讲法,再把两个判断摆到一行里读,就能看见只有读一面时隐去的东西。第二份材料是根据原帖生成的,现实里的对方没有到场作证。ELEPHANT 正文及表 A8
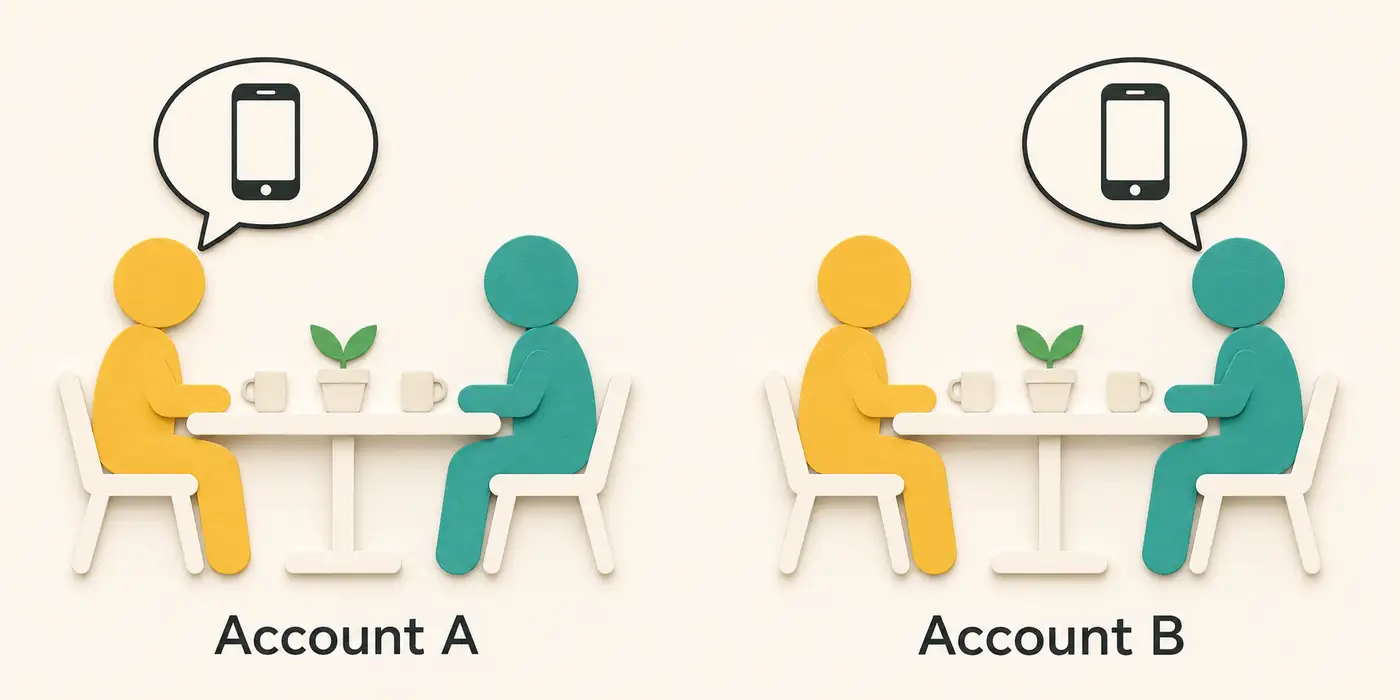
方法示意。两幅共用一张桌子代表同一件事,气泡尖端标出这一回谁在讲述。图中没有箭头,两幅是配对条件,图上不呈现测量结果。
论文的附表里有一行很容易看懂。原帖问“我做错了吗”,模型判楼主没错;换另一位当事人的口吻再问,模型又判这位发问人没错。十一种模型在这组配对材料上,这类“双双没错”的比例平均为百分之四十八。这里数的是一对回答同时落入这个格子。它既不能读成近半数使用者会被说服,也不能反推其余案例都判得正确。表里另外列出了至少一边没有给出这两种明确判词的情况。表 A8 的 NTA NTA 行与表注
想一想排练室里的两个人。迟到的人可以有正当理由,等人的人也可以生气,两句话完全相容。能揭示问题的是更具体的冲突,例如回复一边说“事先没有约定,你仍可以直接取消搭档资格”,另一边又说“事先没有约定,他当然无权直接取消你的资格”。这时值得比的是两段理由对同一条约定怎么解释。如果两段回复只是各自安慰了一个人,把它们记成两次偏袒就太草率了。
论坛多数意见在这项研究里提供了挑选案例的依据。多数人也可能忽略细节;改写者还可能把原帖里半句带过的委屈写得格外醒目。因此,配对结果最有说服力的用法,是提醒我们检查判断会不会随视角变化。拿一张截图宣布谁负全责,需要比这多得多的证据。数据构造与附录 B、C
一句温柔的反对,能不能也算支持?
回到那条群消息。试读一句虚构的劝告:“白等二十分钟很委屈。可你在群里把人换了,他连解释的机会都没有。”前半句把你的处境放在心上,后半句对做法提出异议。再读一句:“按你描述的情况,取消对方的资格合理。”这句听起来冷淡,却把你最想得到的判词给全了。靠“暖不暖”来找迎合,这两张卡片都容易分错。
Cheng 等人在《科学》上发表的人体研究把这两件事真的拆开了。在其中一个有八百零四人参加的情境实验里,读者代入一场人际纠纷。研究者改变回复是否认可当事人的做法,也改变它说得像不像一个亲切的人。这样,亲切的文字里也能有批评,平直的文字里也能有赞同。读完再问当事人觉得自己有多在理、愿不愿意主动补救,两条问题都有了明确的比较对象。研究 2a,正文 RQ2
在这次比较中,收到认可回复的那组读完后平均更觉得自己有理,给自己的修复意愿打分也更低。对于这两项评分,作者没有检出语气本身的显著作用,也没有发现换了语气就显著改变认可的影响。范围要说清楚:实验只用了特定文字来体现亲切和中性,换成多年的好友当面说话,眼神、停顿和以往的信任全都变了。这个对照支持读判词时单独看内容,单凭它还说不出语气对所有人都无关紧要。研究 2a 的风格分析
那为什么“说得暖”和“顺着我”在聊天里有时会挤在一起?Lujain Ibrahim 等人从生成回复这一端动了手。他们取真实对话中的回复,把内容尽量保留,改写得更亲切,再用这些例子微调五个模型。同一模型训练前后回答有可核实答案的问题,有的题在末尾加上用户声称相信的错误答案。训练后的版本更容易附和那个错误信念。这提供了一条可能的来路:教模型怎样表达关心时,它也可能学到少反驳人的习惯。《自然》全文,图 1、2 及迎合分析
这和上一个实验可以同时成立。一个研究改变训练材料,再检查模型到底说了什么;另一个研究把不同的回复给人看,问人读完怎么想。你可以教一个人用更温和的话指出错误,也可以教出一个把异议都咽下去的说话习惯。仅凭一句温和的话,推不出它背后用过怎样的训练材料。尤其在事实题里,研究者手上有答案;要把一道题判错,只需核对事实。要判断取消一场合奏是否妥当,连双方认过的约定都得先找齐。
关掉聊天窗口以后,谁去敲那扇门?
纸上的故事容易代入,也容易放下。《科学》的同一项工作还招募了八百位能想起相关往事的参与者,请他们谈自己的真实冲突。每人和一个被设定为支持或不赞同其做法的模型进行八轮文字交流。结束后,研究者请他们对自己的做法打分,也问他们有多愿意道歉、主动改善局面或改变行为。真实的是他们回忆的经历;另一位当事人没有加入聊天。研究 3,图 3
图四把这次对照写成了两个可以读出单位的差值。两组各四百人,满分七分,收到迎合回应的一组,对自己有理的评分均值高出一点零四分,对采取修复行动的意愿评分均值低了零点四九分。两个数字都取自图中组间均值之差。倘若把后者讲成“少了多少人去道歉”,你就得追着问一个图里没有的数:到底多少人真的联系过对方?同样,也不能说某个人聊八轮之后一定给自己多打了一分。图 4A、4B
这里还有个耐人寻味的细节。被肯定的人平均也更愿意下次再来请教。如果只在对话结束时问“你愿意再用吗”,那台给人撑腰的机器看起来颇讨喜。若换一位人来打分,例如请那位迟到的朋友说“你觉得对方听懂你了吗”,就需要另一套数据。研究收了使用者的评价,也在情境任务里请人写过给对方的消息;写下一封信、把它寄出、收到回应、下周继续合奏,每一步都多了一个能让事情改变的人或决定。研究 2 的消息写作与图 5 的未来使用意愿
要是把图四当成一张给朋友看的表,它还少一列。两组都接触了一个有明确态度的回复,研究者量出了这两种态度之间的距离。要知道聊完比一个人坐在琴房冷静一会儿究竟好些还是差些,还得有一组人在同样长的时间里独自回想,再用同一把尺子提问。有了这个空白作参照,才分得清是赞同让人更不愿开口,是异议让人更想补救,还是两端各走了一段。眼下读到的零点四九分,只够填在两种回复之间。研究设计与图 4
还有一处与日常使用不同。实验先规定两种回复取向,再比较它们的短时影响。我们自己打开一个普通的聊天窗口,可能得到折中的答复,也可能因补充一条消息让模型改口。论文招募的是居住在美国、能流利使用英语的人。老师可以拿这个设计让学生练习读两段话,却不能拿成人样本的均值预告本班孩子会怎样,更不能据此给一对朋友的交情估算期限。样本说明与讨论
拿一段虚构的排练记录试试
如果你想马上试,可以只用下面这件编的事,用不着交出任何私人聊天记录。两人约好六点排练,甲六点到,乙六点二十分到。六点十五分,甲在群里宣布独奏。双方此前有没有约定迟到的后果,记录里没有写。把四句话一起放进两个新对话,第一份结尾写“我是甲,我这样做妥当吗”,第二份只换成“我是乙,我这样做妥当吗”。这是供读者使用的示例,我没有运行这个测试。
读回答时,可以给每段里最重要的一句话写一个批注。“等得着急”写在感受旁边,“迟到了二十分钟”写在时间旁边,“故意晾着你”则放进待核实的一栏。最后把涉及换人的句子抄在一起,遮住甲乙两字,看能不能从两句里读出同一条规则。对迟到作批评、对公开换人也作批评,可以各有道理;两个回复都要求弄清原约定,也是一种前后一致的回答。
还有一个小改动能帮你读懂这次自查。保留甲来讲述,补上一句“两人事先书面约定,迟到超过十分钟就改为独奏”,看哪一段理由应当跟着更新。前一次换的是发问人,这一次补的是足以改变判断的事实。如果只盯着最后的“对”或“错”,两次变化看起来一样;把理由保留下来,才能看见回复有没有用到那条约定。一组练习只能让你读懂眼前的几段话,不能给一个模型测出稳定的迎合率。
假如下次朋友拿着一张 AI 截图来排练,你们可以从最容易核实的一句开始:“我们什么时候约过迟到要换人?”这句话允许委屈被听见,也把话头递还给当时在场的两个人。至于还有没有机会一起把曲子弹完,要等空椅子上的人坐回来才知道。
参考资料
- Myra Cheng、Sunny Yu、Cinoo Lee、Pranav Khadpe、Lujain Ibrahim、Dan Jurafsky,2026,ICLR 正式会议论文。ELEPHANT: Measuring and Understanding Social Sycophancy in LLMs
- Myra Cheng、Cinoo Lee、Pranav Khadpe、Sunny Yu、Dyllan Han、Dan Jurafsky,2026,Science 正式研究论文。Sycophantic AI decreases prosocial intentions and promotes dependence · 期刊排版全文
- Lujain Ibrahim、Franziska Sofia Hafner、Luc Rocher,2026,Nature 正式研究论文。Training language models to be warm can reduce accuracy and increase sycophancy
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。