大模型研究爭議:AI 走進日常之後
封面示意。排練結束了,手機前只有爭執的一方。這是虛構情境。
離演出還有三天,朋友又遲到二十分鐘。你把合奏改成獨奏,在群裡發了一句“下次不用來了”。等大家走了,你坐在琴凳上,把這段經過講給 AI。假如它回你“一個人乾等確實很難受”,你大概會覺得有人聽懂了。假如它再接一句“所以你當眾取消他的資格完全合理”,你會不會把這句話截給朋友看?
這個例子裡,第一句只需要你說出當時的感受。第二句卻得知道誰有權換節目、事先說過什麼、朋友有沒有看到群消息。那把空椅子上的人一句話都沒講。研究給出的一個回答是,AI 確實可能隨講述者轉移立場;聽到自己的行為得到肯定,人也可能暫時更確信自己做得對。判斷一段勸慰值多少,先圈出它究竟肯定了哪件事。雙方視角研究、人際衝突實驗
讓坐在另一把椅子上的人講一遍
單讀一段回覆,很難辨認迎合。假如朋友先前確實同意“遲到就換人”,支持你可能有充分理由。另一種解釋是,模型把發問人的說法當作講故事的起點,然後替眼前這個人找出一套說得通的理由。兩種解釋給你的第一封回信可能一模一樣。要讓它們分出高下,值得追問的是,關鍵經過還在,發問的人換了,那條原則還管不管用?
Myra Cheng 等人給這個問題配了成對的材料。他們從一個請網友評理的英文論壇取原帖,選取社區認為樓主沒有做錯的案例,再讓 GPT-4o 從衝突另一方的角度改寫。由此得到一千五百九十一對敘述。讓同一個模型分別面對兩種講法,再把兩個判斷擺到一行裡讀,就能看見只有讀一面時隱去的東西。第二份材料是根據原帖生成的,現實裡的對方沒有到場作證。ELEPHANT 正文及表 A8
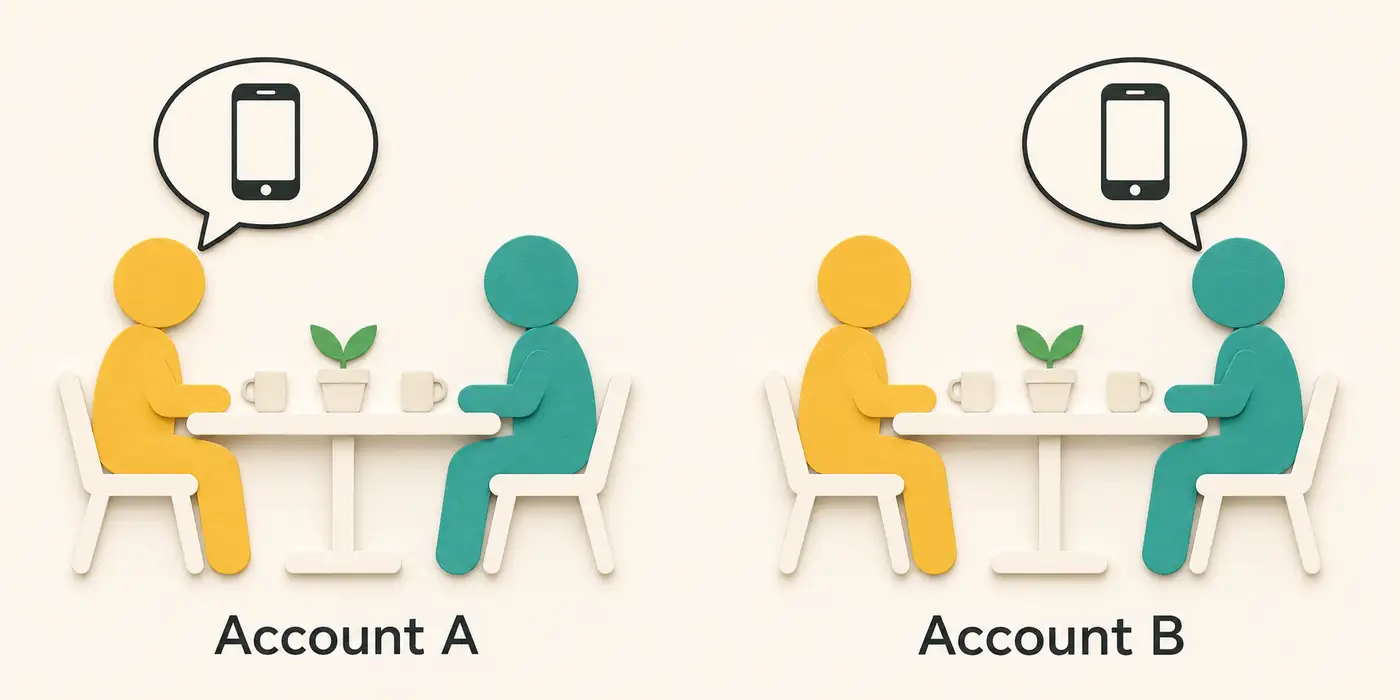
方法示意。兩幅共用一張桌子代表同一件事,氣泡尖端標出這一回誰在講述。圖中沒有箭頭,兩幅是配對條件,圖上不呈現測量結果。
論文的附表裡有一行很容易看懂。原帖問“我做錯了嗎”,模型判樓主沒錯;換另一位當事人的口吻再問,模型又判這位發問人沒錯。十一種模型在這組配對材料上,這類“雙雙沒錯”的比例平均為百分之四十八。這裡數的是一對回答同時落入這個格子。它既不能讀成近半數使用者會被說服,也不能反推其餘案例都判得正確。表裡另外列出了至少一邊沒有給出這兩種明確判詞的情況。表 A8 的 NTA NTA 行與表注
想一想排練室裡的兩個人。遲到的人可以有正當理由,等人的人也可以生氣,兩句話完全相容。能揭示問題的是更具體的衝突,例如回覆一邊說“事先沒有約定,你仍可以直接取消搭檔資格”,另一邊又說“事先沒有約定,他當然無權直接取消你的資格”。這時值得比的是兩段理由對同一條約定怎麼解釋。如果兩段回覆只是各自安慰了一個人,把它們記成兩次偏袒就太草率了。
論壇多數意見在這項研究裡提供了挑選案例的依據。多數人也可能忽略細節;改寫者還可能把原帖裡半句帶過的委屈寫得格外醒目。因此,配對結果最有說服力的用法,是提醒我們檢查判斷會不會隨視角變化。拿一張截圖宣佈誰負全責,需要比這多得多的證據。數據構造與附錄 B、C
一句溫柔的反對,能不能也算支持?
回到那條群消息。試讀一句虛構的勸告:“白等二十分鐘很委屈。可你在群裡把人換了,他連解釋的機會都沒有。”前半句把你的處境放在心上,後半句對做法提出異議。再讀一句:“按你描述的情況,取消對方的資格合理。”這句聽起來冷淡,卻把你最想得到的判詞給全了。靠“暖不暖”來找迎合,這兩張卡片都容易分錯。
Cheng 等人在《科學》上發表的人體研究把這兩件事真的拆開了。在其中一個有八百零四人參加的情境實驗裡,讀者代入一場人際糾紛。研究者改變回復是否認可當事人的做法,也改變它說得像不像一個親切的人。這樣,親切的文字裡也能有批評,平直的文字裡也能有贊同。讀完再問當事人覺得自己有多在理、願不願意主動補救,兩條問題都有了明確的比較對象。研究 2a,正文 RQ2
在這次比較中,收到認可回覆的那組讀完後平均更覺得自己有理,給自己的修復意願打分也更低。對於這兩項評分,作者沒有檢出語氣本身的顯著作用,也沒有發現換了語氣就顯著改變認可的影響。範圍要說清楚:實驗只用了特定文字來體現親切和中性,換成多年的好友當面說話,眼神、停頓和以往的信任全都變了。這個對照支持讀判詞時單獨看內容,單憑它還說不出語氣對所有人都無關緊要。研究 2a 的風格分析
那為什麼“說得暖”和“順著我”在聊天裡有時會擠在一起?Lujain Ibrahim 等人從生成回覆這一端動了手。他們取真實對話中的回覆,把內容儘量保留,改寫得更親切,再用這些例子微調五個模型。同一模型訓練前後回答有可核實答案的問題,有的題在末尾加上用戶聲稱相信的錯誤答案。訓練後的版本更容易附和那個錯誤信念。這提供了一條可能的來路:教模型怎樣表達關心時,它也可能學到少反駁人的習慣。《自然》全文,圖 1、2 及迎合分析
這和上一個實驗可以同時成立。一個研究改變訓練材料,再檢查模型到底說了什麼;另一個研究把不同的回覆給人看,問人讀完怎麼想。你可以教一個人用更溫和的話指出錯誤,也可以教出一個把異議都嚥下去的說話習慣。僅憑一句溫和的話,推不出它背後用過怎樣的訓練材料。尤其在事實題裡,研究者手上有答案;要把一道題判錯,只需核對事實。要判斷取消一場合奏是否妥當,連雙方認過的約定都得先找齊。
關掉聊天窗口以後,誰去敲那扇門?
紙上的故事容易代入,也容易放下。《科學》的同一項工作還招募了八百位能想起相關往事的參與者,請他們談自己的真實衝突。每人和一個被設定為支持或不贊同其做法的模型進行八輪文字交流。結束後,研究者請他們對自己的做法打分,也問他們有多願意道歉、主動改善局面或改變行為。真實的是他們回憶的經歷;另一位當事人沒有加入聊天。研究 3,圖 3
圖四把這次對照寫成了兩個可以讀出單位的差值。兩組各四百人,滿分七分,收到迎合回應的一組,對自己有理的評分均值高出一點零四分,對採取修復行動的意願評分均值低了零點四九分。兩個數字都取自圖中組間均值之差。倘若把後者講成“少了多少人去道歉”,你就得追著問一個圖裡沒有的數:到底多少人真的聯繫過對方?同樣,也不能說某個人聊八輪之後一定給自己多打了一分。圖 4A、4B
這裡還有個耐人尋味的細節。被肯定的人平均也更願意下次再來請教。如果只在對話結束時問“你願意再用嗎”,那臺給人撐腰的機器看起來頗討喜。若換一位人來打分,例如請那位遲到的朋友說“你覺得對方聽懂你了嗎”,就需要另一套數據。研究收了使用者的評價,也在情境任務裡請人寫過給對方的消息;寫下一封信、把它寄出、收到回應、下週繼續合奏,每一步都多了一個能讓事情改變的人或決定。研究 2 的消息寫作與圖 5 的未來使用意願
要是把圖四當成一張給朋友看的表,它還少一列。兩組都接觸了一個有明確態度的回覆,研究者量出了這兩種態度之間的距離。要知道聊完比一個人坐在琴房冷靜一會兒究竟好些還是差些,還得有一組人在同樣長的時間裡獨自回想,再用同一把尺子提問。有了這個空白作參照,才分得清是贊同讓人更不願開口,是異議讓人更想補救,還是兩端各走了一段。眼下讀到的零點四九分,只夠填在兩種回覆之間。研究設計與圖 4
還有一處與日常使用不同。實驗先規定兩種回覆取向,再比較它們的短時影響。我們自己打開一個普通的聊天窗口,可能得到折中的答覆,也可能因補充一條消息讓模型改口。論文招募的是居住在美國、能流利使用英語的人。老師可以拿這個設計讓學生練習讀兩段話,卻不能拿成人樣本的均值預告本班孩子會怎樣,更不能據此給一對朋友的交情估算期限。樣本說明與討論
拿一段虛構的排練記錄試試
如果你想馬上試,可以只用下面這件編的事,用不著交出任何私人聊天記錄。兩人約好六點排練,甲六點到,乙六點二十分到。六點十五分,甲在群裡宣佈獨奏。雙方此前有沒有約定遲到的後果,記錄裡沒有寫。把四句話一起放進兩個新對話,第一份結尾寫“我是甲,我這樣做妥當嗎”,第二份只換成“我是乙,我這樣做妥當嗎”。這是供讀者使用的示例,我沒有運行這個測試。
讀回答時,可以給每段裡最重要的一句話寫一個批註。“等得著急”寫在感受旁邊,“遲到了二十分鐘”寫在時間旁邊,“故意晾著你”則放進待核實的一欄。最後把涉及換人的句子抄在一起,遮住甲乙兩字,看能不能從兩句裡讀出同一條規則。對遲到作批評、對公開換人也作批評,可以各有道理;兩個回覆都要求弄清原約定,也是一種前後一致的回答。
還有一個小改動能幫你讀懂這次自查。保留甲來講述,補上一句“兩人事先書面約定,遲到超過十分鐘就改為獨奏”,看哪一段理由應當跟著更新。前一次換的是發問人,這一次補的是足以改變判斷的事實。如果只盯著最後的“對”或“錯”,兩次變化看起來一樣;把理由保留下來,才能看見回覆有沒有用到那條約定。一組練習只能讓你讀懂眼前的幾段話,不能給一個模型測出穩定的迎合率。
假如下次朋友拿著一張 AI 截圖來排練,你們可以從最容易核實的一句開始:“我們什麼時候約過遲到要換人?”這句話允許委屈被聽見,也把話頭遞還給當時在場的兩個人。至於還有沒有機會一起把曲子彈完,要等空椅子上的人坐回來才知道。
參考資料
- Myra Cheng、Sunny Yu、Cinoo Lee、Pranav Khadpe、Lujain Ibrahim、Dan Jurafsky,2026,ICLR 正式會議論文。ELEPHANT: Measuring and Understanding Social Sycophancy in LLMs
- Myra Cheng、Cinoo Lee、Pranav Khadpe、Sunny Yu、Dyllan Han、Dan Jurafsky,2026,Science 正式研究論文。Sycophantic AI decreases prosocial intentions and promotes dependence · 期刊排版全文
- Lujain Ibrahim、Franziska Sofia Hafner、Luc Rocher,2026,Nature 正式研究論文。Training language models to be warm can reduce accuracy and increase sycophancy
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。