- 日期:2026-10-08
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-08;重点检索近12个月,并保留争议起点的2025年研究。本文为证据深读,未运行模型训练或复现实验,不声称全面覆盖。
摘要:答对更多,不只对应一种解释
强化学习之后,一个模型第一次回答就能解出更多题,我们能否说它获得了新推理能力?关键不在于承认或否认进步,而在于弄清楚进步发生在哪里:原本偶尔答对的题变得稳定,原本未能解出的题开始可解,还是输出格式更符合评分器?这些变化都有价值,却需要不同证据。
本文对照四项研究。**目前较稳妥的判断是:提高采样效率与扩大有限预算内的可解题范围都可能发生,效果取决于起点、任务和训练方式;它们都不足以单独证明某种内部推理机制从无到有。**这不是给正反观点各留一半空间,而是把不同强度的结论放回各自能够支持的实验条件。Yue等、ProRL、MATH-Beyond和课程强化学习提供了四个不同切口。
先把“会做”拆成三个问题
可验证奖励强化学习,简称RLVR,是让模型生成候选解,再根据答案核对或程序测试等反馈更新参数。奖励告诉模型哪些输出更值得保留,却不一定提供完整解法。本文把接受这次强化学习之前的检查点称为“起点模型”;它可能已经经过指令微调或推理蒸馏,不能见到论文里的base一词就认定它是原始预训练模型。
第一种“会做”是单次可靠性:随机尝试一次时多大概率正确。第二种是预算内可达性:允许尝试多次,能否至少得到一个正确答案。第三种是可迁移的解题机制:面对新结构、被干预的条件或更高难度,是否仍能运用某种方法。这三种说法逐渐增强,后一种不能由前一种自动推出。
常见的pass@k衡量前次采样中至少一次成功的情况,再在题目上汇总。它与“从候选中实际选出正确答案”的能力不同:评测器知道哪些答案通过验证,真实使用者未必知道。单题的一个直观概率模型是:
这里是固定题目,是固定模型、提示和解码协议下的单次成功概率,是独立同分布采样次数。公式只是解释指标,不是本次测量;有自适应搜索或相互依赖的候选时,不能直接套用。不同题目的也不同,不能先把准确率平均,再代入公式冒充整个数据集的pass@k。指标定义见Yue等§2.2。
由此出现一个容易忽略的事实:**即使只提高原本极小的成功概率,高采样预算下的覆盖率也可能上升。**反过来,连续失败只能说明在当前协议下没观察到成功,不能把判成严格的零。本文所说“边界扩大”,首先指可观察的预算内边界,而不是数学上证明原模型永远不可能生成该答案。
论文的分歧,哪些来自设置不同?
起点较强时,奖励可能主要让答案更集中
Yue等在数学、代码和视觉推理上比较训练前后的pass@k。论文报告了小时RL模型较好、较大时起点模型追上甚至超过的现象。数学实验以预训练模型为起点,代码与视觉部分则不全是这一设置。§4.1还按同一道题区分训练前后是否解出,而非只比较平均分。原文§3–4.1
这支持“在所测配方中,强化学习常把已有成功变得容易采到”的解释。**本篇的限定是:有限模型与有限预算的观察,不能升级成所有强化学习算法的能力上限定理。**尤其不能把“训练后可解题集合接近训练前的子集”,改写成每一条推理过程都已被逐条证明存在。
延长训练后的收益,也并非处处一致
ProRL加入稳定训练和维持探索的设计,包括约束策略分布偏移的KL项、重置参考策略,以及多领域任务训练。它从DeepSeek-R1-Distill-Qwen-1.5B起步,§4把结果分为覆盖下降、较早平台和持续增长三类,并在训练未见的boxnet任务上报告改善。原文§2、§4.2–4.3
因此,不应断言RL总是只改善低预算表现,但也不能把改善全部归因于训练时长:任务混合、探索控制和起点都与前一项研究不同。已经蒸馏过的起点意味着,实验回答的是“此检查点还能通过RL进步多少”,不是“没有先前推理监督也能从零学会多少”。跨任务迁移是有用证据,仍不是内部算法新生的直接观察,也未排除极低概率解法被放大的可能。
要找边界,题目本身也要留出空间
MATH-Beyond从数学题库中筛出指定模型在1024次尝试下仍未解出的题,并提供模型专属子集、并集和交集。它把“新解出的题”与“原来能解、后来失去的题”分开定义;对部分RL模型的评估显示扩展有限。原文§2–4;ICLR 2026正式版
它更适合诊断难例可达性,却不是未经筛选的日常数学题分布。某模型专属集合上的扩展率,与另一模型另一集合上的扩展率,分母已经不同,不能直接排成能力榜。本篇还建议用新的采样批次重测起点模型:筛选时零成功的题,复测时可能出现稀有成功;这会影响“新增”的归属,而不必意味着任何一方造假。
教师引导有效,不等于纯奖励独自发现
2026年的课程强化学习预印本先探测当前可达边界,再用少量教师推理轨迹做监督微调,最后通过RL巩固。作者在数学评测上报告了pass@256改善。论文也指出:采用组内相对奖励时,如果一组候选全部失败,奖励驱动的优势项可能全部为零。原文§3–4
这给出了明确的学习信号问题,但改进来自包含教师信息的组合过程。若要回答“RL自身贡献了什么”,还需控制教师内容和预算,比较仅教师微调、仅RL以及组合训练。全失败组没有该项信号,也不意味着整个模型绝不会进步:其他题目的参数更新、正则项及迁移仍可能改变它。
| 研究切口 | 关键条件 | 观察或主张 | 不能据此证明 |
|---|---|---|---|
| Yue等 | 多种起点与现有RL配方 | 小预算改善可伴随覆盖收缩 | RL永远无法扩展 |
| ProRL | 蒸馏起点、多任务、延长训练 | 收缩、平台和增长并存 | 时长是唯一原因 |
| MATH-Beyond | 按模型失败筛出的难题 | 隔离预算内新增成功 | 普遍任务上的总体能力 |
| 课程RL | 教师微调与RL交替 | 组合流程扩大观察覆盖 | 无外部信息的新能力创造 |
表中各行对应上述原文,不能横向比较提升幅度。前三项已有正式会议记录;课程RL在本次核验中只确认到arXiv预印本。
真正需要对齐的是一次完整测量
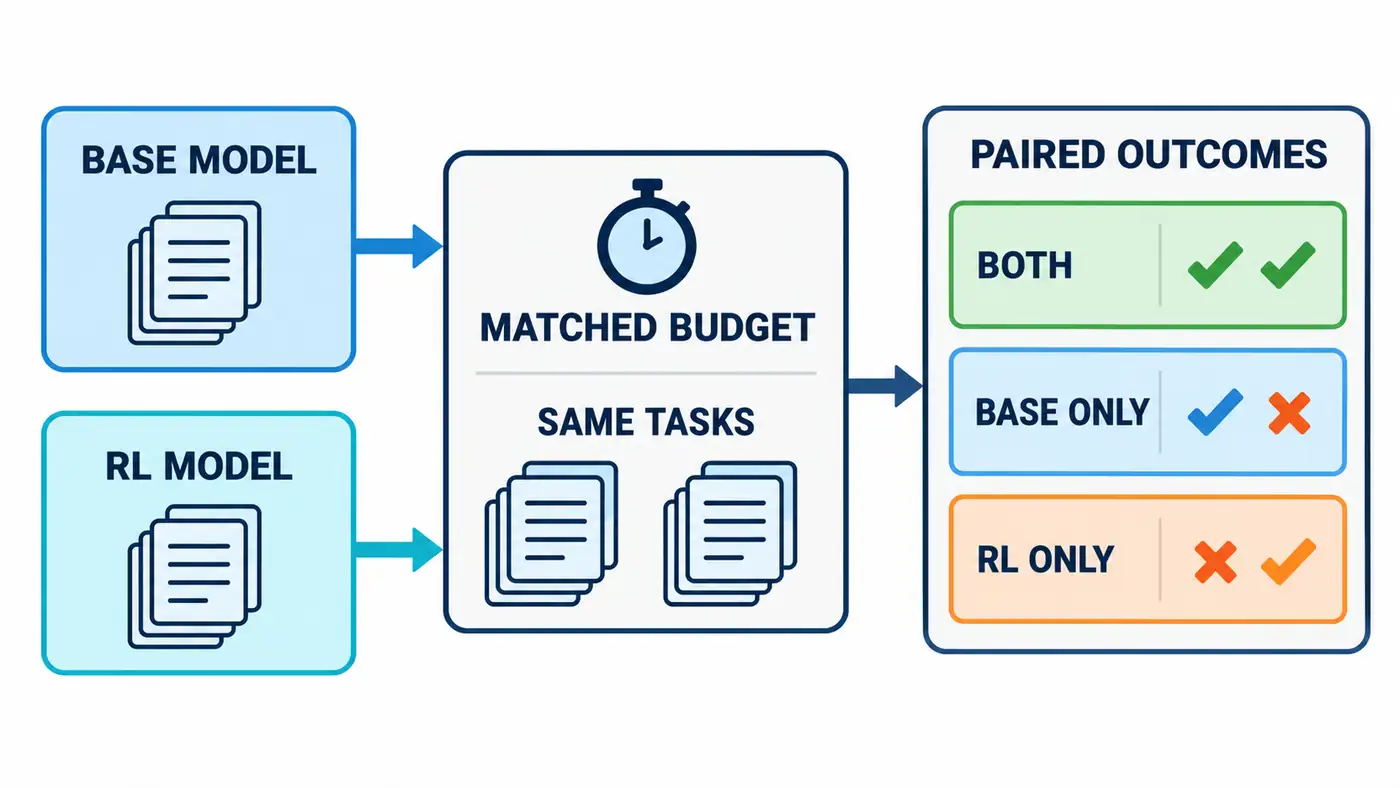
图示为本文建议的评测流程,不是论文数据或已证实的因果机制。勾叉左侧代表起点模型,右侧代表RL模型;仅画出至少一方成功的三类,双方均失败的第四类也必须记录。RL ONLY表示当前预算内仅训练后成功,不自动代表全新推理机制。
同样的采样次数不保证同样的计算成本。Yue等的通用评测上限为16384个token,ProRL的评测设置为32k;两者即使都画pass@k,也不是跨论文的严格等预算对照。Yue等§3、ProRL§3.4。训练数据、教师生成和试验配方选择消耗的预算,还应与测试时生成成本分开报告。
提示模板、温度和答案提取器也应冻结。否则,某模型可能只是更熟悉输出格式,或得到更适合自己的解码参数。共同协议便于解释因果,分别调优的协议便于比较各自最佳表现;两种实验都能做,但调优预算和目标必须写清,不能把它们混成同一个结论。
可比性还包括数据身份。要区分训练题、配方选择用的验证题和最终测试题,检查题目及近重复解法是否交叉。ProRL说明曾用来自评测基准的混合验证集监控训练;本篇因此不把所有报告收益都称为完全独立的确认结果。原文§3.3。这是一项解释限制,不等于已经证明数据泄漏。
最后,答案正确与推理正确仍有距离。数学题可能猜中末尾数字,程序也可能只通过不充分的测试。MATH-Beyond还展示了答案解析规则造成的误判。原文§3.1。若主张新增解题方法,就需要检查关键步骤、补充测试或受控变式;仅凭流畅的文字解释不足以完成这一步。
下一项实验,怎样让两种解释给出不同预测?
下面是后续研究设计,尚未执行。先固定一个起点检查点和一组独立题目,保存完整候选、判分记录及生成成本。对训练前后模型使用共同的采样预算网格,并另做相同总生成token预算的比较,分别报告可靠性、新增覆盖和失去覆盖,避免只挑一个对自己有利的。
**检验一:收益是否主要来自重新分配概率?**如果低预算差距明显,高预算差距逐渐消失,而且新增题在独立重采样后也被起点模型解出,就更支持这种解释。若高预算差距持续存在,证据更支持实用可达范围扩大;但仍不能仅凭有限失败断言原概率为零。
**检验二:扩展依赖什么训练信息?**设置只做RL、只用教师轨迹微调、两者组合的条件。保持教师题目与轨迹一致,记录教师调用、训练token和更新次数。若组合优于仅教师条件,才更能支持RL对巩固或迁移有额外作用;若只在教师覆盖过的模板上提升,结论就应收窄。
**检验三:新增成功是否能迁移到解法结构?**从新解出的题型制作预先确定的变式,改变表面措辞、无关线索及组合结构,并用独立验证方式判分。若提升跨变式保持,且关键步骤有效,才更接近“学到可复用方法”的主张。解释文本不同本身不是机制证据,也不应由生成文章的助手冒充人工语义金标。
实验前还应约定预算上限和停止规则,完整保留正负结果。如果预算用完仍无法区分两种解释,结论就是当前测量分辨率不足;不追加采样直到出现期待的答案,也不把仍然开放的问题写成算法已经无效。
总结:把“新能力”写成可检验的主张
对读者最有用的立场是分层报告:单次正确率提高,说明更可靠;同题同预算下新增成功增多,说明观察到的可达范围变化;控制训练信息后仍有跨结构迁移,才进一步支持可复用方法的学习。每前进一步,都需要新的证据。
因此,读到“RL创造能力”或“RL只会采样”时,先补上四个限定:相对于哪个起点、在哪类任务、用了多少预算、用什么验证。争议的价值不在于选一句口号,而在于把下一次实验设计得足够具体,让竞争解释有机会被区分。
参考资料
- Yang Yue、Zhiqi Chen、Rui Lu、Andrew Zhao、Zhaokai Wang、Yang Yue、Shiji Song、Gao Huang. Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? 2025,NeurIPS 2025。正式论文;本文主要定位版本:arXiv v5。两位Yang Yue为不同作者。
- Mingjie Liu、Shizhe Diao、Ximing Lu、Jian Hu、Xin Dong、Yejin Choi、Jan Kautz、Yi Dong. ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models. 2025,NeurIPS 2025。会议页;正式论文;arXiv v1。本文讨论初代ProRL,不混用后续版本数字。
- Prasanna Mayilvahanan、Ricardo Dominguez-Olmedo、Thaddäus Wiedemer、Wieland Brendel. MATH-Beyond: A Benchmark for RL to Expand Beyond the Base Model. 2025预印本,ICLR 2026。会议页;正式论文;arXiv v1。
- Pengxiang Cai、Tianchen Fang、Xiaohan Li、Qingyuan Zeng、Guocong Li、Jintai Chen. Curriculum Reinforcement Learning Can Incentivize Reasoning Capacity in LLMs Beyond the Base Model. 2026,arXiv预印本v1,首次提交2026-06-21。原文;版本记录。截至检索日未核实到正式会议录用信息。