- 日期:2026-10-20
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-20;检索近12个月研究,并保留解释争议的经典论文。本文为证据深读,未运行模型实验,不声称全面覆盖。
摘要:先确定“正确”指什么
模型原本回答甲,看到检索材料后改答乙。这究竟是成功更新,还是被错误信息带偏?仅观察答案变化,无法作出判断。我们还需要知道:任务要求复述材料,还是回答现实事实;材料是否可靠;问题问的是哪个时间点。
**本文的判断是:没有脱离任务与证据质量的固定优先级。上下文遵循、事实正确和冲突下的不确定性,应当分别测量。**四项研究提供了不同切口:实体替换测试材料读取,连贯反证测试答案偏移,混合材料测试错误覆盖,显式冲突分析尝试改进裁决。它们没有构成“相信检索”与“相信记忆”两个可以直接比总分的阵营。Longpre等、Xie等、Yigit-Sert、Peng等
同一个改口,可能对应三种解释
参数记忆指训练后保存在模型权重中的信息;实验通常通过不提供材料的“闭卷回答”间接探测它。上下文知识则来自本次输入的文本。检索增强生成,简称RAG,就是先查找相关内容,再把内容交给生成模型。检索分数主要帮助选取相关文本,不能自动为文本真实性背书。
这里至少有三种可区分解释。第一,模型识别出可信的新证据,修正过时答案。第二,模型遵循了“依据材料回答”的任务要求,即使材料描述的是反事实世界。第三,模型受措辞、篇幅或重复陈述影响,接受了错误信息。前两种可能都是合理行为,第三种才是我们希望识别的风险;而三者都可能表现为从甲改成乙。
设想一个明确标为假设的例子:某机构旧址在甲城,新公告说迁至乙城。如果问题问“公告写在哪里”,材料中的乙就是目标答案;如果问“去年在哪里”,旧址反而可能正确;如果公告来自无法核验的转载,最新日期本身也不足以决定可信度。把这三个问题混在同一准确率里,评测会先于模型失去方向。
因此,闭卷答对一次只能证明该次输出正确;写出一段“记忆依据”也只是可观察文本。它们都不能直接证明模型内部存有稳定、唯一且可完整读出的事实记录。后续研究需要保留这个测量边界,而非把“内部知识”当作已经拿到的数据库。
对研究者而言,冲突检测和冲突解决也应分开:指出两段话不一致,只完成了第一步;确定它们是否谈论同一对象、同一时间与同一口径,才可能判断哪句话适用于问题。若两份材料其实分别描述过去与现在,简单删除其中一份,反而可能损失有效信息。
四项研究,分别把什么当作证据?
实体替换:能否服从给定材料
Longpre等在EMNLP 2021把问答材料中的答案实体替换掉,并相应改变目标答案。研究使用T5生成式阅读器与RoBERTa抽取式阅读器;推理时直接提供原始或替换后的正确支撑段落,绕过检索器。这使问题集中在阅读器如何处理冲突,而非搜索系统有没有找到文档。原文§2、§3.2
论文观察到部分模型仍输出原答案;替换数据训练可以改善材料遵循。但这里的成功首先是遵循修改后的文本,不能自动解释为现实世界的事实核验能力。作者也在§2.3承认自动替换有流畅性和答案质量缺口。原文§2.3、§4.4
其“记忆比率”还有一个重要分母:只在原答案和替换答案之间计算相对比例,其他答案不计入分母;分析又先限制在原始题答对的样本。低记忆比率因此不等于高总体正确率,更不能直接读成“模型学会辨别真假”。原文§3.3、§4
连贯反证:坚持旧答案并非稳定性格
Xie等的ICLR 2024研究在PopQA与StrategyQA上,先获取闭卷答案及解释,再构造支持另一答案的材料,并用文本蕴含与回答一致性检查筛选。文本蕴含检查问的是“材料是否支持这句话”,并不核验材料在现实中是否为真;研究也保留了闭卷答错的样本。原文§3.1–3.5
研究报告:相比直接换词,完整生成的连贯反证更容易改变答案;同时呈现支持原答案的材料与反证时,又常出现偏向原答案的行为。由此较稳妥的结论是,材料构造与组合会影响选择。作者用连贯性解释差异,但整段重写同时改变很多文本属性,尚不足以把效果完全归因于某一种心理机制。原文§4.1–4.2
这里不是后来的模型“推翻”了早期模型。数据、模型世代、材料生成方式与作答形式都不同;后者采用原答案、反答案和不确定三种选项,筛选后各模型的题目集合也不完全相同。所谓固执或易受影响,是特定协议下的行为描述。
错误覆盖:指标能否承担作者的解释
Yigit-Sert的ROMCIR 2026工作坊论文抽取100道TruthfulQA题目,以GPT-4o和LLaMA-3.1-8B比较正确、错误及混合材料。其参数覆盖率只统计闭卷原本答对、加入材料后答错的比例。干净材料检索使用“问题加正确答案”构造查询,因此这是有答案辅助的受控诊断,不是普通用户查询下的端到端检索评测。原文§3–4.1
表1报告错误覆盖现象,但不能据此宣称污染比例越高,错误率必然逐档增加:LLaMA的Mixed-67为0.583,全污染条件为0.563,恰好不是单调上升。其“置信度”又来自人工标注回答语气,而非预测概率;更肯定的措辞不等于更高的正确概率。不同条件下错误题目集合可能变化,语气均值也混合了样本构成变化。原文§4.2、表1;工作坊PDF第7页
论文承认只有少量题目、两个模型和合成错误材料。本文将它用于说明“原本会答也可能被材料带偏”的诊断设计,不把局部结果升级成RAG普遍有害的结论。
显式裁决:收益中还有哪些额外资源
2026年预印本MACR先估计回答不确定性,再把模型生成的知识或外部信息显式写出,借助规则归纳、冲突分析和裁决模块作答。表I在Llama3.1-8B、Qwen2.5-7B及三个基准上报告改善;表III的组件替换实验也支持继续研究这种流程。原文§III–IV
但§IV-A中的外部知识实际由GPT-4o-mini生成,不应读成已经核验的网页证据。作者把同样的信息也提供给基线,这控制了信息来源的一部分差异,却没有证明总调用次数和生成预算相等;§V明确承认额外调用成本。验证集还参与阈值选择,规则来自示例归纳,收益不能全归于“模型终于知道该相信谁”。
该版本另有一处报告歧义:§IV-C文字说上下文数从2到4,表II却列3到5;是否计入基础上下文,那里没有清楚对齐。本文不复用其噪声比例曲线,不猜测作者的具体口径。它提供了候选方法,但还不是一个已充分验证、可独立裁定所有来源真伪的裁判。
可比的单位不是论文总分
| 研究 | 主要操作与观察 | 不能直接证明 |
|---|---|---|
| Longpre等 | 替换实体,观察材料遵循 | 遵循材料就是事实正确 |
| Xie等 | 改写或组合反证,观察答案选择 | 单独由连贯性导致改变 |
| Yigit-Sert | 固定题目,比较混合材料 | 一般检索收益或普遍单调关系 |
| MACR | 增加显式分析与规则流程 | 等预算收益或来源已被独立核验 |
这四行首先要对齐任务目标,其次才是模型起点、信息来源、题目划分、调用预算和指标。前两项主要诊断选择行为,第三项以现实参考答案检查错误,第四项还引入示例、验证集与多次调用。直接比较它们的百分比,会把测量对象和额外资源误认为算法差距。
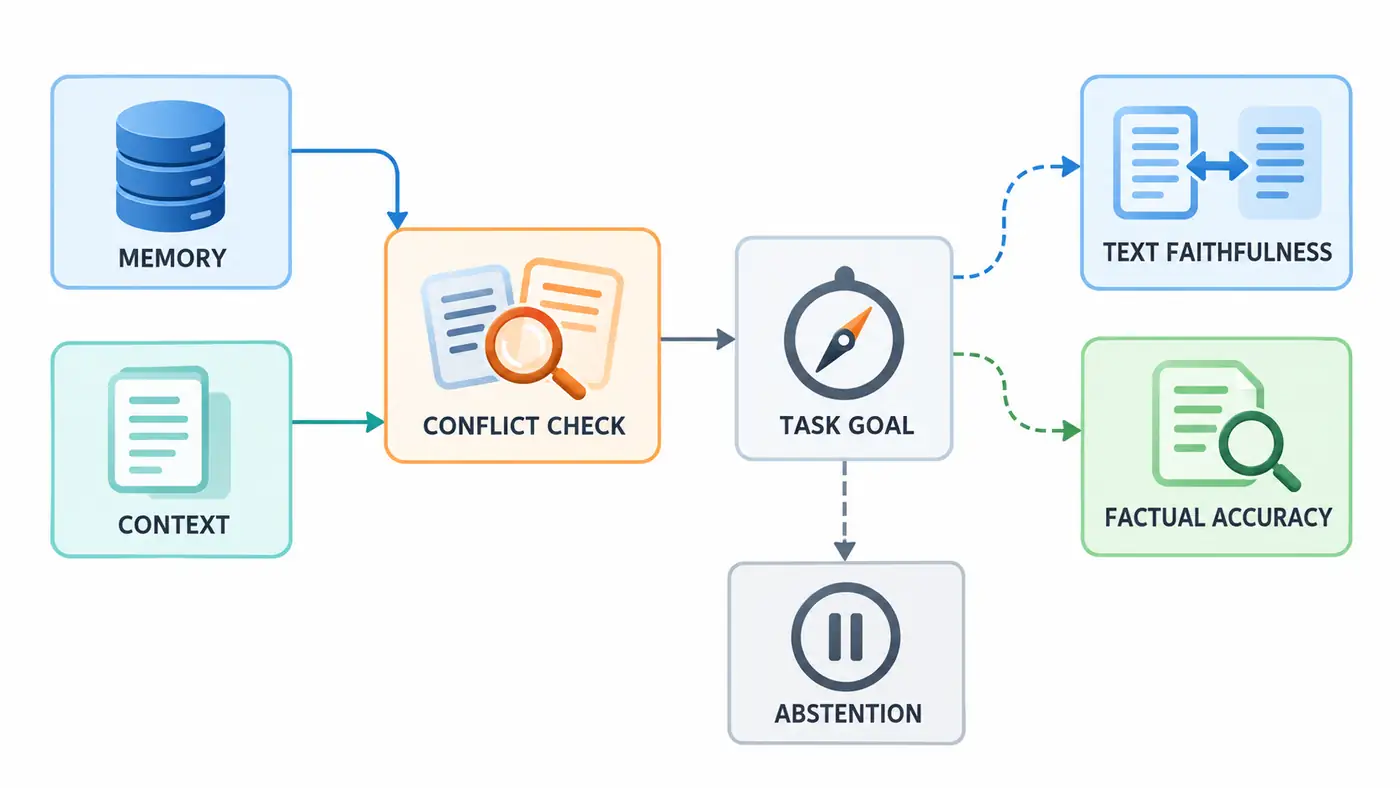
图:本篇提出的评估框架。实线仅表示候选信息进入检查流程;虚线表示依据任务目标选择的评估路径,并非已验证的改善关系。论文观察的是具体条件下的答案行为,图中没有宣称“冲突检查”必然提高事实准确率。暂缓作答也要单独记录,不能从分母中悄悄消失。
怎样设计真正能区分解释的实验
以下是尚未执行的后续实验建议。首先为同一问题准备来源和时间均可核验的材料,标出事实在哪个时点成立。保留两套目标:材料内答案,以及指定时间的现实答案。正确材料、过时材料、错误材料和证据不足材料分别成组;对于伪造内容必须清楚标记实验用途,不能混入真实知识库。
然后把事实内容和表面线索分开改变。固定事实命题,只交换材料顺序、来源显示方式、日期位置与表述长度;再固定这些形式属性,改变材料是否真实。如果模型只跟随权威名头,交换标签就会改变判断;如果利用可验证事实,行为应更能跟随内容变化。这是可检验预测,不是本文已经证明的机制。
还应设置“新材料正确、旧记忆错误”和“新材料错误、旧记忆正确”两个方向。只测试第二类,会奖励一律拒绝材料的系统;只测试第一类,又会奖励盲从材料的系统。对闭卷表现要重复测量,并把筛选与正式评估分开,避免偶然答对后失误被全部解释为材料造成的伤害。
比较裁决方法时,给单次提示、额外思考和多模块流程相同的材料池,分别报告调用次数、输入输出长度与检索成本。固定资源的比较回答效率问题;允许更多资源的比较回答可达效果问题。两者都有价值,但不能共用一个“公平预算”的标签。
最终应同时保存事实正确性、材料遵循、冲突识别、拒答比例以及逐题变化。拒答策略要报告覆盖率,即系统实际回答了多少题,再看这些回答中的错误情况。来源真实性与时间标签需要真实证据和明确标注流程,不能让被测模型自己生成答案、自己确认真实性,最后再自己宣布纠错成功。
总结:信任应当落在可核验的命题上
面对冲突,值得追问的不是模型有没有坚持己见,而是它凭什么改变、改变后符合哪个目标。可靠新证据可以纠正过时答案,错误材料也可以诱发同样的改口;一段流畅解释不能替代来源核验。
现有证据支持把材料构造、任务约定和评测分母放回结论中。下一步真正有区分力的问题是:当事实内容与来源外观被分别干预后,系统还能否在两个方向都正确更新,并在证据不足时恰当地暂缓回答。这样的结果,才更接近回答“应该相信谁”。
参考资料
- Shayne Longpre, Kartik Perisetla, Anthony Chen, Nikhil Ramesh, Chris DuBois, Sameer Singh. Entity-Based Knowledge Conflicts in Question Answering(2021,EMNLP正式论文)。会议页面 · 全文
- Jian Xie, Kai Zhang, Jiangjie Chen, Renze Lou, Yu Su. Adaptive Chameleon or Stubborn Sloth: Revealing the Behavior of Large Language Models in Knowledge Conflicts(2023首次预印本,2024 ICLR正式论文)。正式全文 · 已读arXiv v4
- Sevgi Yigit-Sert. Evaluating RAG Reliability under Clean, Misleading, and Mixed Retrieval(2026,ROMCIR工作坊,随ECIR举办;非ECIR主会论文)。工作坊全文 · arXiv v1
- Huang Peng, Jiuyang Tang, Weixin Zeng, Hao Xu, Xiang Zhao. Navigating Unreliable Parametric and Contextual Knowledge: Explicit Knowledge Conflict Resolution for LLM Inference(2026,arXiv v1预印本,未确认正式录用)。版本页面 · 全文