- 日期:2026-10-22
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-22;检索近12个月相关工作,并保留必要经典研究。本文为四篇论文的证据深读,未运行模型编辑实验,不声称全面覆盖。
摘要:改对一句话,还不等于修好一条知识
假设某研究所从甲城迁到乙城。模型终于能答对“研究所现在在哪里”,但换成简称又回答甲城;问它所属省份,也沿用旧地址。另一套系统已经更新文档,却因检索到旧副本而给出同样的错误。这是说明问题的假设场景,不是本文实验。
两个系统都可以宣称“更新成功”,却没有完成同一种纠错。本文的判断是:**外部记录通常更便于定位和替换修改对象,但答案是否随之可靠改变,仍取决于检索、适用范围与推理;参数编辑可以改变不附带文档时的回答,却不能仅凭目标问句成功就推断关联知识已经一致更新。**这个判断来自对下述论文设置的综合分析,并非某一榜单的冠军结论。
先给“纠错”划出边界
参数记忆,是知识通过训练影响模型权重,回答时不必显式取回原始记录。参数知识编辑则试图局部改变这些权重,使指定事实对应的输出发生变化。外部记忆把更新写在模型之外,回答时再调取记录。检索增强生成通常把文档送入模型;检索式编辑还可能训练专门的路由器与回答模块,两者不能直接画等号。
纠错至少包含三件事。有效性问原问题是否答对;泛化问改写、别名和关联问题是否一起改变;局部性问不应受影响的行为是否保留。这种划分在编辑研究中有明确依据,但各论文的测量方式不同。SERAC,§2、§4
边界还必须由任务决定。研究所迁址不意味着它的成立地点也改变。“现在在哪里”和“当年在哪里”应有不同答案;若只是新增一个合作机构,也不能顺手抹去原有合作方。实验开始前需要写清时间、关系是否允许多个取值、哪些后果是必然的。否则,传播得越广未必越正确,保持得越多也未必越可靠。
改变权重与改变读取路径,各自解释了什么
ROME(NeurIPS 2022)把特定前馈模块视作可编辑的关联映射,通过秩一更新修改权重。它在 GPT-2 XL、GPT-J 的 CounterFact 实验中,同时考察目标改写、换问法和邻近主体,展示了局部编辑的可行性。这里的“秩一”指更新矩阵具有受限结构,不是“只改了一个神经元”。论文的主指标比较新旧目标的概率,因此也不是任意开放问题的生成正确率(§3.1、§3.3、表4)。
这支持一种解释:新答案可以通过模型内部的变化变得更容易输出。本篇进一步指出,编辑能奏效,并不自动证明所有相关知识位于同一个可独立更换的“事实格子”;局部测试也不能覆盖所有可能后果。把修改算子叫作知识编辑,与证明模型形成了完整一致的新世界,是不同强度的主张。
SERAC(ICML 2022)提供另一条路径:保存编辑记录,由范围分类器判断当前问题是否受编辑影响;范围内交给条件于记录的反事实回答模型,范围外沿用基础模型。两个辅助模块都需要训练,所以“基础权重不变”不等于没有学习成本。原文 QA-hard 在 T5-large 上同时施加十条编辑;结果与组件误差分析表明,复杂问法的范围判别仍是重要瓶颈(§3—5、表3—4)。
这支持另一种解释:改善来自更准确地识别“何时应用这条更正”,不必是基础模型本身重新记住了事实。对研究者而言,可检查的记录让调试更直接,但路由错误仍可能把正确更正送给错误问题。若只演示一次成功检索,就没有检验容易混淆的近邻问题。
两种解释可以同时成立。参数编辑解决的是一部分内部关联修改,外部记录改变的是获取更新的通道;二者共同面对“更新应影响哪些输入”的难题。不能把一个用任务训练过的辅助系统,与一个只收到单条编辑的权重更新器相比,再把所有差异归因于知识的存放位置。
真正拉开证据边界的是关联问题
RippleEdits(TACL 2024)把评测扩展到关系推论、组合问题、别名及应保留的事实。所测编辑方法未能一致处理这些后果;直接把新事实放入上下文的 ICE 基线总体较强。但 ICE 直接获得对应编辑,并不是从混杂文档中自行找到它;评测还筛选目标编辑成功、所需旧知识已能答对的情况,并以生成文本命中目标别名计分(§5.1—5.2)。
因此,它提供的是有条件的关联更新诊断,不能证明完整检索系统在真实资料库中更可靠。不同模型和方法留下的可评样本也可能不同,不能把筛选后的均分当作同一总体的成功率。
这里需要防止另一种误读:关联问题失败,不必然等于“更新根本没写进去”。可能是新事实没有推广到反向问法,也可能是模型不知道另一跳知识,或者知道两条事实却没有组合起来。反过来,回答出关联答案,也可能是读懂了当前提示。只有分别改变这些条件,才能区分解释。
新基准扩大了问题,也改变了分数含义
近12个月检索纳入的 UniEdit(NeurIPS 2025,数据集与基准赛道)用知识图谱构造更广的领域与关系组合。表2中,IKE、SERAC 的泛化表现较强,但局部性较低;GRACE 保持性强,泛化则接近未编辑起点。最关键的阅读细节在附录 D.1:泛化和局部性检查目标词元是否进入前五候选,判断题用第一候选;多跳任务会临时补入模型不知道的非编辑跳。IKE 还使用训练样例作为上下文,SERAC 使用训练后的辅助模块。
所以,这组结果可以说明该协议下的取舍,不能翻译成自然语言问答成功率,更不能直接与 RippleEdits 排名拼接。其数据主要围绕英语、知识图谱关系与生成问句,本篇也不将结论外推到中文开放文档。论文能揭示旧指标遗漏什么,但新增的评测支架必须算进解释里。
| 证据 | 核心条件 | 观察支持什么 | 不能据此证明什么 |
|---|---|---|---|
| ROME | 特定模型、局部权重修改、概率指标 | 关联可被定向修改 | 任意推论都已更新 |
| SERAC | 训练辅助模块、显式编辑缓存 | 可分开处理范围与回答 | 外部记录天然不会误用 |
| RippleEdits | 直接提供编辑、筛选可评样本 | 关联一致性值得单测 | 完整检索链路的优劣 |
| UniEdit | 候选排序及中间知识补入 | 泛化与保持性存在取舍 | 无支架自由生成的成绩 |
表中结论对应前文所引原文。它们没有形成整齐的正反阵营:共同指向的是,单一目标问句不足以验收纠错;分歧更多来自任务范围、辅助信息和计分方式。
把“更容易纠错”变成可区分的实验
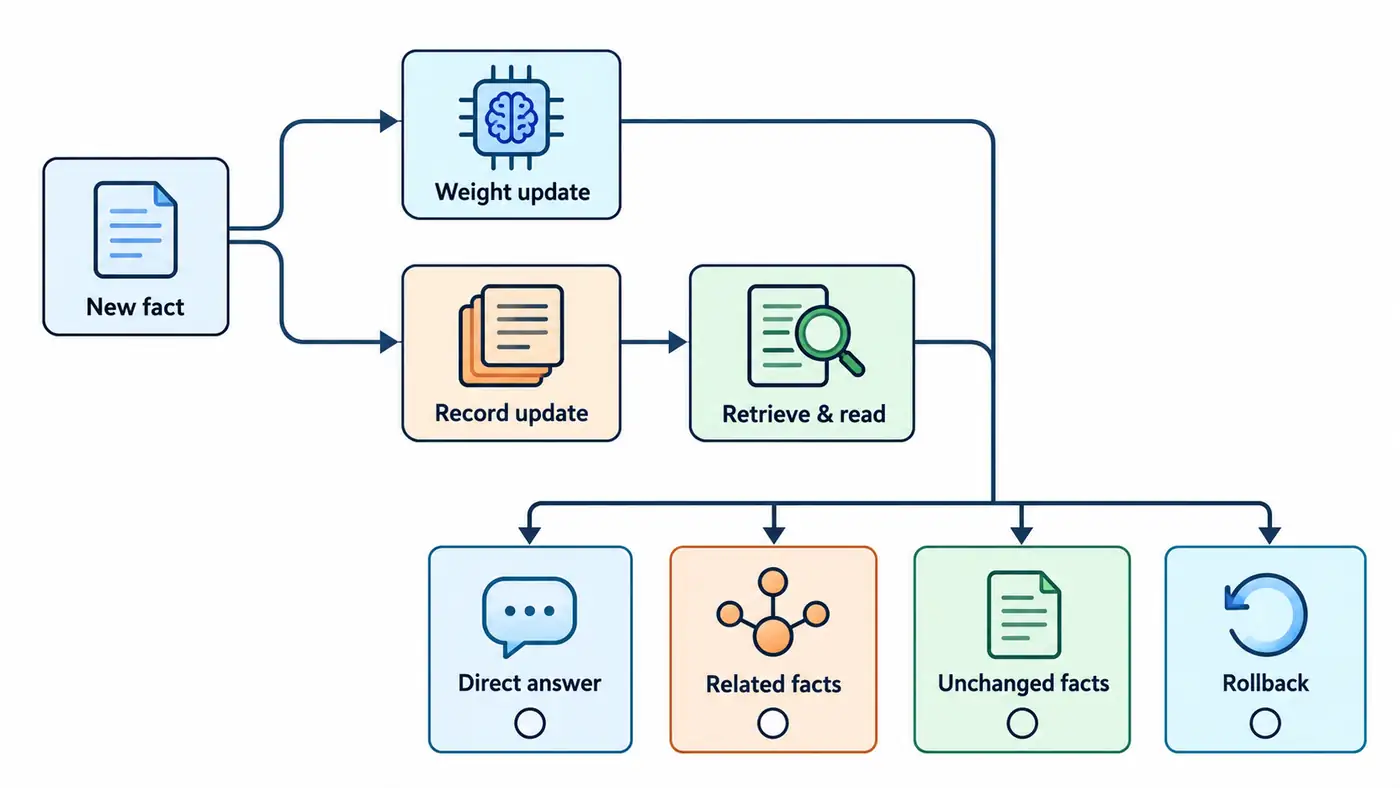
图:本篇提出的干预与评测流程。两条路径接受同一更正,再分别检查直接回答、关联事实、无关事实与撤销恢复。箭头表示流程,空圆表示待测项目,不表示论文已证明成功,也不是知识存储机制图。
下面是尚未执行的研究设计。固定一个开放模型、同一组更正和同一批问题;把事实分成真实时效更新与明确标注的反事实更新,分别报告,避免把遵循假设误算成掌握现实。
设置四个条件:原始闭卷模型、参数编辑、直接提供正确记录、真实检索后提供记录。后三者使用同一更正文案;直接提供记录是诊断参照,不算检索方法的实际成绩。如果真实检索失败而直接提供成功,优先检查召回和排序;如果两者都失败,应继续排查阅读、范围判断或组合推理,不能把责任统统推给存储形式。
每条更正提前配齐原问句、未见改写、别名、反向关系、多跳问题,以及措辞很像却不应改变的负例。测试问句和关系组合不能参与调参。需要语义裁定的项目,应由真实标注者按冻结规则确认;不能让同一模型生成答案、裁定答案,再宣称获得独立证据。
所有方法先报告完整样本上的端到端结果,再单列“目标编辑成功且其余跳已知”的条件结果。遇到原本不知道的中间事实,分别保留“不补入”和“补入”两种评测,不把后者悄悄并入主成绩。若只在补入后拉开差距,更合理的结论是特定信息条件下的利用能力不同。
资源也不能藏起来。参数编辑报告优化与保存成本,外部路径报告索引更新、辅助模块训练、检索次数和上下文长度;同时记录推理耗时。固定输入与生成预算是第一层控制,有训练过的编辑器时,还要另列其训练数据与费用。无法完全对齐时,应明确这是系统比较,不能声称隔离了存储位置的因果效应。
最后做撤销测试:恢复编辑前权重,或撤下更正并恢复旧记录及索引状态,检查输出是否回到预期。全量恢复检查点,与从连续多次参数编辑中单独撤回一条,并不是同样的操作;外部系统也要纳入重复文档、缓存与派生摘要。记录删除成功只验证了存储动作,答案不再受旧更正影响才验证了行为恢复。这是本篇提出的检验要求,不是四篇论文已完成的结论。
如果某方法只提升原问句,应称为局部纠正;若关联问题改善但近邻负例恶化,则应报告影响范围过宽。真正有说服力的结果,是在预先约定的范围内同时说明改对了什么、保住了什么,以及撤销时恢复了什么,而不是寻找一个能掩盖取舍的平均分。
总结:容易修改与可靠生效,是两项证据
知识放在外部,往往更方便指出“这次改了哪份记录”;知识写入参数,则可能让更新后的回答不依赖每次附带资料。但可追溯的记录仍需被正确使用,局部成功的参数编辑仍需通过关联与保持性检查。
对科研新人,更值得追问的是:**这篇论文究竟验证了修改对象、更新范围,还是最终行为?**先把三者分开,才能讨论哪种路径在什么条件下更容易纠错,也才能提出下一步真正能推翻某种解释的实验。
参考资料
- Kevin Meng、David Bau、Alex Andonian、Yonatan Belinkov. Locating and Editing Factual Associations in GPT. NeurIPS 2022。正式论文
- Eric Mitchell、Charles Lin、Antoine Bosselut、Christopher D. Manning、Chelsea Finn. Memory-Based Model Editing at Scale. ICML 2022。会议页面 · 正式论文
- Roi Cohen、Eden Biran、Ori Yoran、Amir Globerson、Mor Geva. Evaluating the Ripple Effects of Knowledge Editing in Language Models. TACL 2024(预印本始于2023)。期刊页面 · 正式论文
- Qizhou Chen、Dakan Wang、Taolin Zhang、Zaoming Yan、Chengsong You、Chengyu Wang、Xiaofeng He. UNIEDIT: A Unified Knowledge Editing Benchmark for Large Language Models. NeurIPS 2025,Datasets and Benchmarks Track。正式论文