- 日期:2026-10-19
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-19;实际检索近12个月工作,并保留解释问题所需的经典研究。本文为证据深读,未执行模型训练或复现实验,不声称全面覆盖。
摘要:谁在写教材,谁在决定对错?
一个模型出题、作答,再把自己的答案用于训练,这个闭环看起来已经不需要老师。但生成训练材料与决定哪些材料值得学习,是两项不同的工作。老师可能不再逐题写解法,却仍以标准答案、评分规范、程序执行结果或开发集的形式参与。
本文的判断是:自我改进可以减少持续人工标注,也可能改善可迁移的结构能力;是否依赖外部反馈,必须说明所指的是哪一阶段、哪一种信息。“自生成数据”“自评分”“从随机初始化开始”并不是同一强度的主张。STaR、自奖励模型、Absolute Zero和近期零数据预训练研究,展示了不同的闭环,并未构成“能自学”与“不能自学”两个直接对立的阵营。STaR;Self-Rewarding;AZR;Self-Play Pretraining。
先画出反馈进入系统的位置
这里的“自我改进”指模型生成或筛选经验,再通过参数更新改变后续能力;单次对话里重写答案属于另一类问题。验证器是给候选答案判断信号的机制,可以是模型,也可以是规则或执行环境。课程是训练任务的分布与难度安排,并不特指人工编写的教材。
不妨把外部依赖拆成四层。起点层包括预训练权重与种子示范;训练层包括每轮答案、奖励和环境观察;开发层包括选择超参数、提示词与停止时机的依据;评测层负责判断最后是否进步。一个系统可以在训练层不再请求人类标签,同时继续依赖另外几层。把这四层合并成一句“零外部信息”,会使论文最有价值的贡献反而难以辨认。
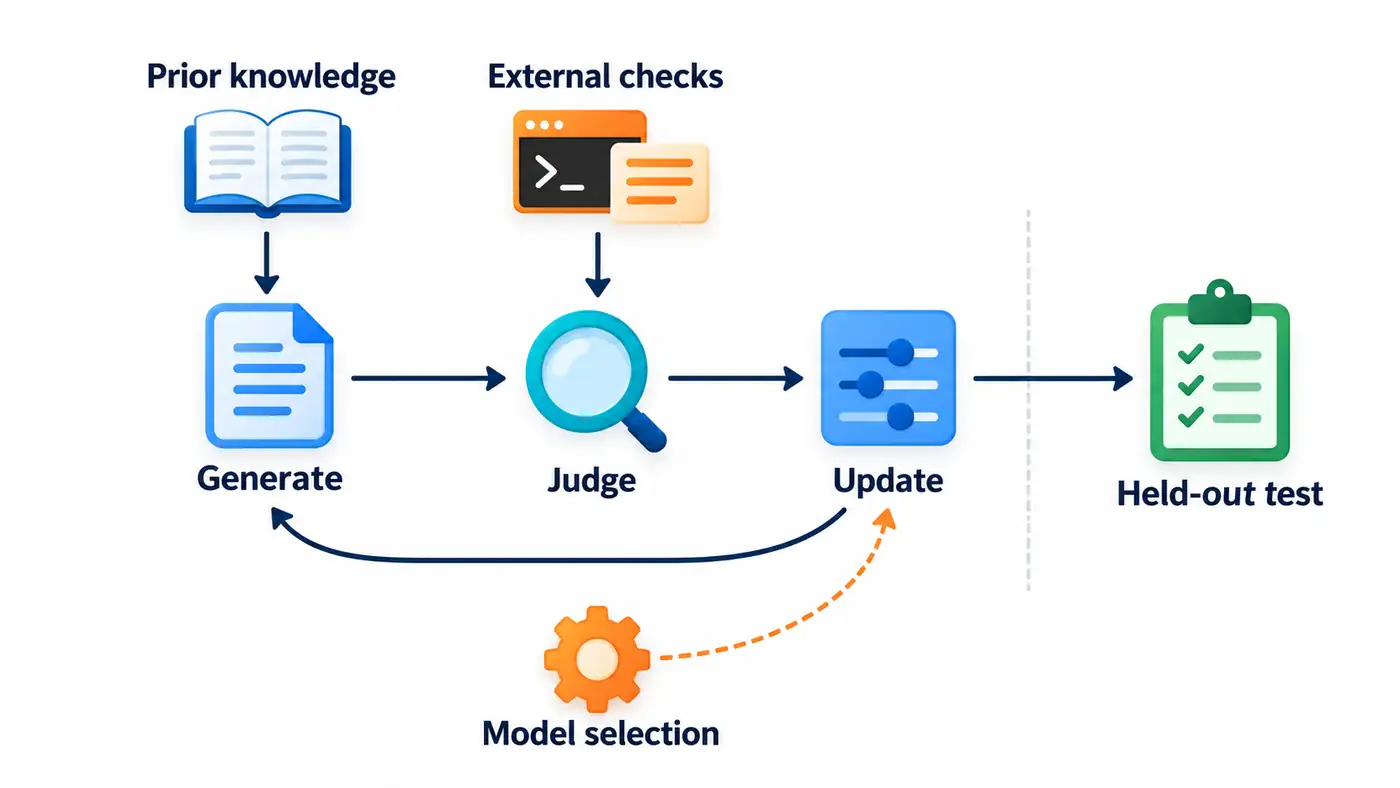
图:这是本文的阅读框架,不是任何单篇论文的实测因果图。实线表示需要追踪的训练信息路径,橙色虚线表示可能存在的开发选择反馈;各方法不一定使用所有入口。右侧留出测试应只接收模型、不反向调参,这是后续实验的设计要求,不能据此宣称所读论文均已满足。
由此可以提出三种可区分的解释。第一,重新组织已有能力:模型偶尔能给出好答案,筛选与训练让它稳定复用。第二,借助可执行规则探索新经验:没有人逐题给答案,但环境能区分候选后果。第三,适应自己的裁判或开发指标:内部评分变好,独立任务未必同步改善。三者可以并存;后续实验的目的,是辨认各自贡献,而不是仅凭“self”这个前缀选边。
四种闭环,四种证据边界
STaR:自己写过程,答案仍由数据集提供
STaR从预训练GPT-J及少量推理示范起步。模型生成解题过程,最终答案匹配标准答案才进入训练集;答错时,还会给出正确答案作为提示,让它重新生成过程,训练时再去掉提示。每轮使用新材料微调原始模型,并非始终在上一轮权重上续训。原文§3、算法1。
论文在算术、常识问答和数学应用题上报告改善;其主要贡献是降低逐步推理标注需求。它没有取消结果监督:只看“过程由模型生成”,会漏掉筛选和答案提示这两个入口。最终答案正确也不能保证每一步正确;论文的失败案例保留了这一点。§4、§4.4失败案例。
这说明,审核一篇自训练论文时,应把“需要多少人工过程”与“需要多少已知答案”分别记账。过程监督减少,是实质进步;将它写成无监督发现,则改变了被实验检验的问题。
自奖励模型:裁判可以一起进步,但没有凭空出现
Self-Rewarding以Llama 2 70B为起点,用Open Assistant的人类示范和排序构造种子训练。随后,同一模型生成候选回答并按规范评分,用偏好对进行直接偏好优化,即DPO。评价示范是主配方的一部分,论文也检验了不加它的变体,因此不能说它是所有自奖励方法的必要条件。§2—3.1、附录A.3。
其指令评测与留出人类偏好一致性有所提升,但仅考察一个模型设置下的三轮;部分奖励评测指标并非逐轮上升,回答长度也增长。作者明确讨论了模型裁判及奖励投机的限制。主实验的题目生成器还是预先固定的,不能把每个环节都描述为共同演化。§2.2脚注、表4、§6。
更直接的开发层依赖是:训练检查点的早停选择使用Claude 2评估验证样本;主实验题目由固定的Llama 2-Chat生成。因此,“自奖励”准确描述了候选回答的训练评分来源,不能扩大为全流程只依靠一个模型。§3.1.3。
本文据此认为,“同一个模型当裁判”不自动使反馈无效:作答与比较候选本来就可能有不同难度。真正缺少的保证是,裁判变得更自信时是否仍校准于目标任务。也不能从三轮改进外推无限递归增长。
Absolute Zero:去掉题库之后,执行环境仍在
AZR让预训练模型同时出题和解题,围绕程序、输入、输出构造任务,由Python执行验证并产生奖励。课程会偏向模型尚未完全掌握、又有机会成功的任务。这里省去的是人工整理的后训练题库,预训练能力和可执行语义并未消失。§2—3、算法1。
论文报告了数学和代码评测改善,但起点模型不同,收益也不同,个别测试项下降;表中其他方法的数据和起点并不统一。它支持特定环境中的自举训练,不证明所有任务都能自造可靠答案。程序筛选也有近似:用有限重复执行检查一致,不能证明对所有输入都确定。§3.3.3、§4、表1。
从参数模型的边界看,执行器提供了外部反馈;从包含执行器的整个系统看,它又是内部组件。这不是文字游戏:前者追问模型能否独自判断,后者追问系统能否摆脱逐题人工监督。两种研究目标都合理,但证据不能混用。
零数据预训练:没有自然数据梯度,仍有开发选择
2026年的Self-Play Pretraining让生成器与学习器都从随机初始化开始:前者生成可执行程序,后者预测程序输出的字节。生成器奖励依据学习器梯度与历史参数变化的关系,而不是自然语言正确答案。论文报告自然数据上的预测损失改善;固定程序先验和专门语法生成基线表现各异,自博弈并非所有领域最佳。§2—3。
关键限定藏在§3.1:超参数选择使用DCLM文本与DNA验证损失,作者明确披露了这一有限信息泄漏。自然数据没有参与梯度更新,却参与了配方选择。报告的计算前沿还跨模型大小、检查点和集成数量;它不是单个模型沿一条轨迹永远进步的证明。§3.1 Scaling recipe。
因此,这项预印本提供了程序结构迁移的有力切口,但预测下一字节与掌握世界事实是不同目标。其讨论也保留了这个边界:具体世界的事实仍须通过与该世界的接触获得。§6。
哪些比较可以做,哪些不能做?
| 研究 | 起点与任务 | 可支持的观察 | 不能据此推出 |
|---|---|---|---|
| STaR | 预训练模型、有答案的题目 | 自生成过程可用于改进 | 不需要标准答案 |
| Self-Rewarding | 预训练及人类种子、指令偏好 | 有限轮次的自评分训练有效 | 自评与事实正确永远一致 |
| AZR | 预训练模型、代码环境 | 自出题可形成有效后训练经验 | 无预训练、无环境也成立 |
| Self-Play Pretraining | 随机初始化、程序字节预测 | 合成结构可迁移到预测任务 | 整个开发过程没接触自然数据 |
这张表归纳前述证据,不能拿来排名。四项研究的指标分别涉及答题准确率、偏好、代码与数学测试以及字节预测损失;训练样本、执行调用、生成长度和集成成本也没有共同预算。即使全部曲线都上升,也不是四次测量同一种“智能增长”。
对读者更有用的是区分两个问题:该配方有没有用,与收益是否由声称的机制造成。前者需要独立测试;后者还需要匹配起点、训练量及推理预算,干预某个反馈来源。若去掉验证器后样本数骤减,性能下降不能全归因于标签质量;若只冻结裁判却增加候选数,也无法隔离裁判更新的作用。
一个能区分解释的后续实验
以下是研究设计建议,尚未执行。可以先选择有独立执行判据的小规模任务,在相同起点上固定一份候选池,比较随机筛选、冻结模型裁判、随轮更新裁判和执行判据筛选。尽量匹配保留样本数、难度与训练token;若不能完全匹配,就分别报告,并增加子集对照。
第一阶段使用固定候选池,测试筛选信息的价值;第二阶段再允许出题器更新,比较自适应课程与从同一历史题池重采样。这样可以避免把“好裁判”“更多数据”和“更好的课程”混成一个变化。候选池本身也应记录生成成本,不能只给学习器计算账单。
评测同时保留原任务、组合方式改变的新任务和容易让裁判误判的反例。每轮分别记录实际执行正确性、自评分和覆盖范围,再分析它们何时分离。若只有自评分上升,适应裁判的解释更可信;若固定候选下独立正确性改善,则筛选已有成功的解释得到支持;若新增课程进一步改善未见组合,才有理由追查探索贡献。这些结果仍不能单独证明某种内部机制诞生。
超参数与停止规则先在开发任务确定,再冻结到未用于选择的测试任务。尤其要把“更新权重没有使用测试样本”和“研究者没有通过反复试验使用测试反馈”分开记录。若实际预算不足以完成这一步,应收窄迁移结论,而不是把开发集改名为测试集。
总结:自学的边界在反馈账本里
模型能承担越来越多教材生成、候选筛选和课程安排工作;这些是可检验的技术进步。更强的说法则需要更强的证据:不新增人工标签,不等于不依赖先前人类信息;没有人工题库,不等于没有环境判据;没有自然数据梯度,不等于没有自然数据驱动的开发选择。
读下一篇“模型自己教自己”的论文时,先沿着生成、判断、更新和评测追踪信息来源,再问收益究竟落在哪种能力上。争议最值得验证的地方,是哪些反馈可以被替代、哪些依赖仍然决定边界,而不是把整个系统压缩成一句“有没有老师”。
参考资料
- Eric Zelikman、Yuhuai Wu、Jesse Mu、Noah D. Goodman(2022)。STaR: Bootstrapping Reasoning With Reasoning。NeurIPS 2022正式全文。
- Weizhe Yuan等(2024)。Self-Rewarding Language Models。ICML 2024;方法与限制核验使用arXiv v3,2025-03-28,不将其冒充会议原版。
- Andrew Zhao等(2025)。Absolute Zero: Reinforced Self-play Reasoning with Zero Data。NeurIPS 2025;方法核验使用arXiv v3,2025-10-16。正式页面与arXiv作者列表存在差异,分别保存在来源记录。
- Aditya Cowsik、Kfir Dolev、Michael Y. Li、G. Bruno De Luca、Nourya Cohen、Noah D. Goodman、Yoav Levine(2026)。Self-Play Pretraining with Zero Data。arXiv v1,2026-09-24;本次未核实正式录用,按预印本引用。