摘要
一道数学题交给模型,它写下证明,Lean 在声明旁标出双勾。这时可以放心使用什么?如果题目已经准确写成形式命题,证明完整,所用公理也在许可范围内,那么别人可以拿走这份证明,交给同一环境重新检查。即使模型明天忘了怎么做,这份数学成果仍然成立。反过来,若把题目中的一个条件删掉,再问模型原证明在哪里失效,这对勾给不了答案。前一个问题考查交付的证明,后一个问题考查生成者能否认出证明对条件的依赖。
本文把“理解”收窄成一个能出题检验的问题:模型能否辨认关键前提,在等价改写后复用论证,并在前提失效时给出反例?以下三篇论文分别让我们看清,题意在哪一步确定,验证器给搜索提供了什么,以及别的证明能否继续使用生成的定理。它们给出的证据可以拼起来读,分数却不能拼成一张能力排行榜。
先看检查器收到的是哪道题
想象一位出题人写下:“任意两个正整数的和大于其中每一个数。”翻译者把“正整数”写成了“整数”,证明者随即发现其中一个加数可以为零,严格不等式不再成立。如果翻译者反过来只允许两个数都大于十,证明就容易通过,但所有涉及一到十的合法情形都被悄悄移出了题目。这是说明性例子。两种错译的共同点在于,检查器收到的已经是另一份题面;无论它多么严格,都无法仅靠检查这份证明找回被改掉的范围。
Lean 是证明助手。数学对象、假设和目标用形式语言写清楚后,可以调用已经证明的引理,也可以写“策略”,即让程序代为构造某一步证明的指令。最终要检查的是一份能在当前环境中推出目标的证明。Lean 手册对双勾的说明
读报告时要问清,提交者是否只补全题面以下的证明,是否可以重写题面,以及是否排除了用占位符留下未证结论。后两项设置会改变“文件编译成功”的含义。一个模型能在固定题面下得到完整证明,本身就是有用且可核查的成就。固定题面的证明生成,图 1
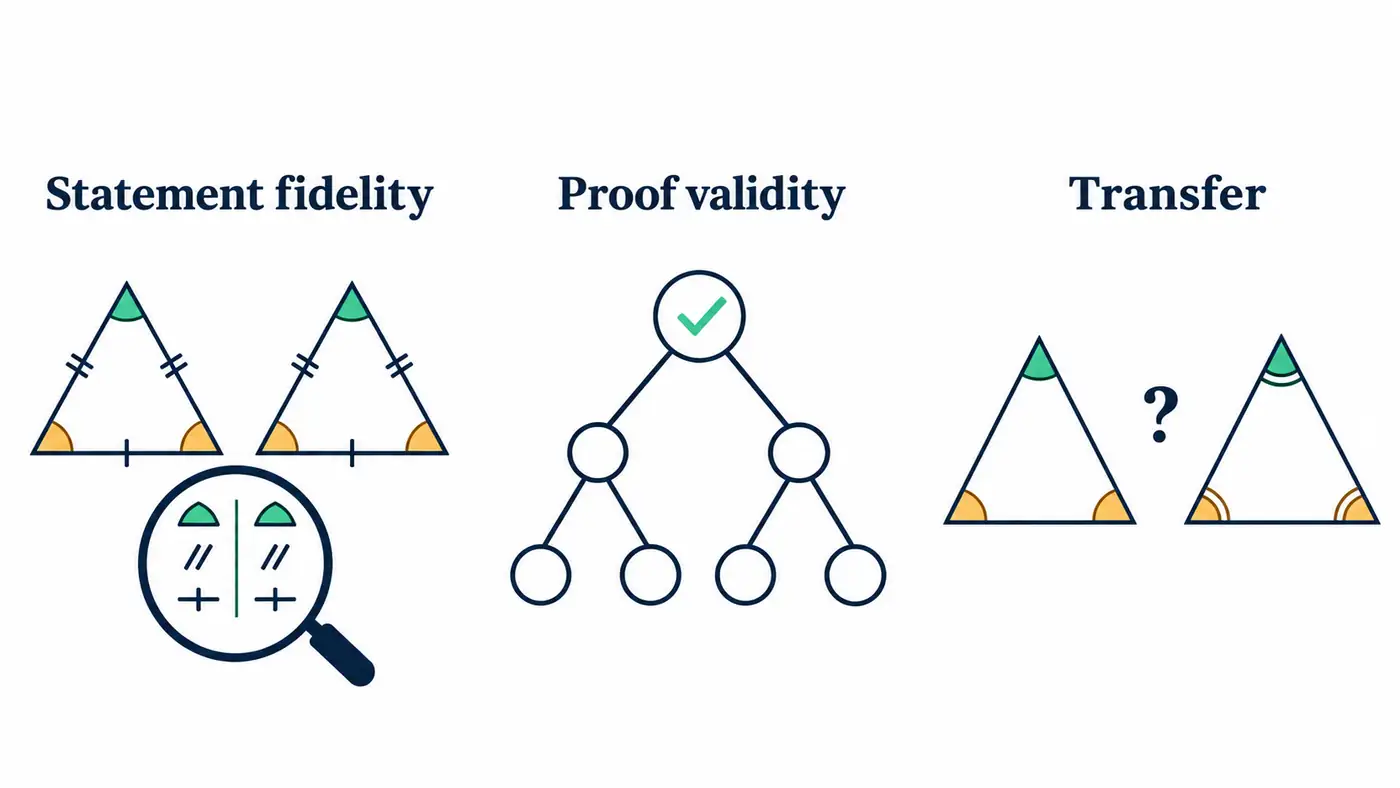
左栏比较原题和形式陈述,中栏表示给定命题的证明已获接受,右栏提出换条件后的迁移问题。三个图标标出需要分别收集的证据,右侧问号表示尚待测试。
第一处落差发生在写证明之前
Poiroux 等人研究的是“陈述自动形式化”,也就是把自然语言命题翻成 Lean。这里就算留着证明不写,也可以评价翻译质量。他们把候选陈述和参考陈述放在一起,用称为 BEq+ 的程序尝试从一个推出另一个,再调换方向。比起核对单词,这给了等价改写被承认的机会。例如把一个假设从句首移到蕴含式的左侧,文本看起来变了,但证明者可以在两个写法之间来回搬运同一项条件。论文第 3 节及附录 A
在带有人工标注的 ProofNetVerif 上,表 1 给出的精确率为 98.0%,召回率为 48.3%。前一个分母是被程序判为等价的候选,后一个分母是标注认可的候选。站在阅卷人的位置看,这意味着拿到肯定判定的候选大多能对上人工判断,但只把这些候选当作全部正确译文,会漏掉相当一部分。另一个有意思的结果是,在修订过的 ProofNet# 上,按模型与方法汇总后,自动分数与人工准确率的排序相当一致。表 2 比较的是一组方法的排序,读者不能把这个结果转交给任意一道题,保证该题的译文可靠。表 1、表 2
连“双向可推”也有边界。作者在附录讨论过一种误收:如果一边本身就把结论当成前提,证明搜索可能轻易闭合目标。文中以整数整除关系为例,原题关心的是从高斯整数中的整除过渡到普通整数中的整除,候选却已经假定了普通整数中的整除。读者丢掉了这道题最想问的那一步。作者也记载了针对这类问题的修补。这个例子的价值在于说明需要检查等价判定究竟用了什么,而不能据此推断现行实现对该样例仍会误判。附录 A.6
同一份证明,可能经历过很不一样的搜索
把翻译问题拿开,给所有系统同一个形式命题。DeepSeek-Prover-V1.5 提供了一个很干净的读表机会。作者允许系统一次生成整份证明,也允许它利用 Lean 返回的中间状态从有效前缀继续探索。后者可以在某一步出错时保留此前走通的部分,再尝试不同的续写。验证器除了在终点验收,还能在途中告诉系统“这里还剩什么目标”。部署这套搜索系统的人可以合理地把它算作解题工具的一部分。图 1 及第 4 节
先只看表 1 中同一个强化学习版本、整份生成、同一 miniF2F 测试集的行。每题采样预算从 128 增至 3200 时,报告的平均解题率从 51.6% 升到 54.9%,相应标准差为 0.5 和 0.7 个百分点。这里的计分单位是题:预算内只要出现一份合格证明,该题就算解决。于是,即便模型权重相同,多次尝试也能改变读者在表中看到的“能力”。两个平均数没有告诉我们某一道题是靠关键引理、常见模板,还是靠若干失败后的偶然组合解开的。第 5.1 节表 1
这给出了两个可以同时成立的解释。模型可能掌握了如何把结论分解成适当的子目标,只是有时写错了库里的名称;它也可能对某类题反复尝试熟悉策略,直到有一条分支恰好适用。两者都能留下完全正确的证明,连最终文本也可能一样。只保存胜出的轨迹,便看不到这些轨迹在所有尝试中占了多少,更看不到换条件后能否再次选对分支。反过来,尝试过许多分支也不能作为缺乏理解的证据,知道应当使用哪个定理与第一次就写出正确参数之间还有距离。
把生成的定理放回原处,会发生什么?
Kim 等人换了一种考法。从真实 Lean 项目里拿走一项声明,让模型根据上下文补回,再把补好的内容放回仓库。这里生成者可以决定声明的形式。作者分别检查候选本身能否编译、依赖它的后续定理能否全部编译。后一项称为测试准确率。设想库里原本有条适用于所有正整数的引理,替换品却额外要求输入为偶数:证明替换品本身可能毫无困难,但某个对奇数调用旧引理的证明会立即遇到一个无法满足的前提。任务示例及第 5.2 节
在完整测试集、同时提供自然语言证明与后续定理上下文的设置下,同一个 Claude-Sonnet-4.5 的独立编译率是 80.3%,通过全部依赖测试的是 38.9%。两列都以整组题目为分母。它们之间的距离表明,有些能独立成立的提交放回特定项目后无法承担原来的用途。后续定理已经作为生成提示的一部分,所以这个结果也有明确的适用范围;若要问模型能否预见全新的用途,需要另留一批调用情景。表 2、表 3
还要留意失败和成功各自能说明多少。下游调用失败,可以定位一个真实不兼容之处;一个在数学上等价、但参数顺序不同的接口,也可能让原有调用出错。相反,假如所有下游调用恰好只用偶数,那个缩小范围的替换品或许就能蒙混过关。作者在局限部分也指出,依赖稀少时覆盖不足,尚无后继定理的独立结果无法这样评估。此外,这批题的自然语言说明由模型生成,可能与原作者的题意有出入。本文据此把该指标读成“在已有调用中可替换”的证据,把题意忠实度留给独立核对。第 8 节
怎样设计一道能区分解释的追问
三项研究各自固定的东西不同。第一项给定参照译文,测评判程序与标注的一致性;第二项给定形式题面,测特定生成与搜索预算下解出的题;第三项给定仓库环境,检查生成物能否接回依赖链。三者的模型起点、数据集、是否提供后续调用、每题允许的尝试均不同,也没有共享的训练对照。把精确率、解题率和测试准确率按数值大小排列,会把三个不同的分母误写成同一批学生的三次考试。它们真正能共同约束的是结论的措辞:可以说哪件作品通过了哪种检查,再另问换题后的行为。
一个可实施的后续实验可以从上述正整数例子起步。为每道母题事先写好三份题面:原题、保持含义但交换表述顺序的题,以及仅放宽一个关键条件的题。由出题者提前给等价题准备可检查的证明,为放宽后失真的命题准备可检查的反例。例如允许零作加数时,只要给出一个正整数和零,和就等于原数。这样既能测出系统会不会修证明,也给“这题已经不能证明了”留出了答对的途径。题面应预先固定;让同一个生成器同时改题、答题和评价反例,会重新引入翻译误差。
将每道变体独立送入同一模型,隐藏同族题的答案。先要求在调用工具前选出可能失效的步骤,再允许它提交证明或反例。固定可用引理、模型版本与提示,给完整重采样和可读中间状态的搜索设相同的总生成量上限,另记检查器调用次数与耗时。只对齐尝试次数仍可能失衡,因为重写整份证明和续写最后一步的成本不同。超时、工具错误、主动作答为假和交出失败证明应分开保存,尤其不能把搜索用尽当作命题为假的证据。
解读时以母题为单位保留配对结果。如果系统在原题与等价题上都能成证,还能在删前提时预先点出断裂处并交出反例,那么“只复用原题固定答案”这项解释就遇到了困难。如果优势只在放开搜索后出现,或系统能说出漂亮理由却总给不出合法反例,结论就应收窄到预算内找到证明或生成解释的能力。即使整组通过,也只能为这类前提变化上的迁移提供证据。换到另一数学领域、另一套库或者更复杂的量词结构,都需要新的题族。以上是实验设计,本篇未执行模型实验。
总结
下一次看到“已由 Lean 验证”,先找出被验证的那行定理声明,看看哪些条件写进了它;再看生成者得到多少次尝试,以及别的证明要怎样调用它。这样做既能放心接过一份可复查的证明,也能给“理解了”这句话配上一道真正有辨别力的追问:把决定成败的那个条件改掉,它还能指出原因并做对吗?
参考资料
Poiroux 等(2025),Reliable Evaluation and Benchmarks for Statement Autoformalization,EMNLP。
Xin 等(2025),DeepSeek-Prover-V1.5: Harnessing Proof Assistant Feedback for Reinforcement Learning and Monte-Carlo Tree Search,ICLR。
Kim、Han、Hwang(2026),Benchmarking Testing in Automated Theorem Proving,ACL Industry Track。
Lean Language Reference,Validating a Lean Proof,官方在线手册,2026 年 11 月查阅。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。