日期:2026-11-07
摘要:看拟合图之前,先找没有参加拟合的那个点
假设你要为下一次语言模型训练选预算。桌上有两份报告:一份用全部训练结果画出一条贴合得很好的曲线;另一份先遮住最贵的几次训练,只用便宜的实验做预测,再揭开答案。你要决定的是下一笔算力怎么花,第二份报告更接近你的问题。可如果下一次还要换语料,第二份报告也只回答了一半:它检验了跨预算,却未必检验过跨语料。
扩展定律(Scaling Law)把训练资源和某个可观测结果之间的关系写成经验公式。**“能预测多远”没有脱离指标和训练条件的统一倍数。证据的边界,是拟合时没有用过、后来确实拿来检验过的配置,以及这些配置上实际出现的误差。**下面三篇研究各揭开一张不同的底牌:哪种模型大小最划算,同样数量的数据是否等价,以及较小模型能否预测较大模型的答题分数。本文只核对原论文,不报告新的训练实验。
先认清曲线两端的量
预训练损失衡量模型给真实下一个词元的概率分配得好不好。词元是分词器切出的文本单位;即使模型没有把正确词元排到第一,给它更多概率也能降低损失。答题准确率的记账方式不同:一道题从犹豫地答错变成几乎答对,只要最后仍选错,分数就不动。还有第三种量:给定算力,哪个参数规模的模型损失最低?它问的是谷底在哪里,并非谷底有多深。同一句“我们预测了表现”,在这三种情况下需要三份不同的验收答案。
在已有最大和最小预算之间估一个中间点,叫插值;越过已见预算去预测更大的训练,才是沿预算轴外推。测试文本没有出现在训练语料里,并不意味着模型规模也没有参加过曲线拟合。反过来,留出了最大规模,也不代表测试了新领域。读论文时不妨在页边写下两行:模型训练时没见过什么?研究者选择公式、估计系数时没见过什么?两行写的是不同对象,不能只凭一个“留出”就互相代替。
第一张底牌:小模型真的花了同样多的算力吗?
Porian 等,图 1 和第 2 节把问题还原为一个选择:在同一笔训练算力下,做大一些、少读一些,还是做小一些、多读一些?他们训练一组从小到大的解码式语言模型,沿相同计算预算比较损失,在每一档预算估计谷底的位置,最后才把这些位置连成规律。这里的起点是同一类训练配方下不同大小的模型,并不是给一个现成模型不断加参数。
关键藏在账本里。把最后一层表示变成整个词表上的分数,也需要计算。在小模型上,这笔费用相对其他层更显眼。漏记它,看似相同的横坐标就未必代表相同花费。另一个容易忽略的设置是预热,即训练开头把学习率逐渐提高。给所有模型安排同样长的预热,某些低预算实验在达到比较点时还没走出这个阶段。此时把小模型的损失当作它正常训练后的水平,会把训练日程的差异写进规模规律。图 1a–c、图 2
作者逐项改变这些设置,再按规模调整优化器,在其训练条件下得到的最优规模趋势更接近 Hoffmann 等的结论。一个很有分量的细节是:针对每档预算安排学习率衰减,并没有同样明显地改变最优规模的趋势;这与衰减能降低损失并不矛盾。整排候选模型的损失可以一起下降,而最省算力的选择仍在附近。图 1c–e 及第 1 节的补充分析 因此,这项工作支持的是一种可检验的差异解释。它没有证明今后换架构、词表或优化器,都该照抄同一条参数分配曲线。
第二张底牌:相同的词元数,喂给模型的是什么?
Subramanyam 等,第 5 节把数据质量变成可以拨动的旋钮。他们从平行语料抽取英德翻译样本,从英文网页语料抽取下一词元预测样本,分别改变数据量和受扰动样本的比例。翻译任务用填充符遮去被选中样本的一部分词元;语言建模则从词表取其他词元替换。实验者知道哪些样本被动过手脚,因而可以在规模相同时比较不同污染程度。这里的“质量”有一个可重复的操作定义,无需让人凭印象给文章打分。
在所测范围内,增加数据量、提高未被扰动的样本比例,都伴随测试损失下降。作者用带质量项的公式描述这种变化,并列出在未见数据上估得的系数。请留意图 1 与表 3的分工:图画的是控制条件下的损失,表比较的是不同数据上估计的参数。系数呈相近规律,与“把旧系数锁死就能报准新语料的绝对损失”,不是同一强度的主张。后者需要交出未经重新校准的预测和误差。
为什么这个区别对读者有用?如果一份训练计划把“新增一批专业文档”按“多读一些同分布文本”计入预算,它已经做了研究设计之外的假设。随机替换词元会破坏局部语言线索;引入另一领域的干净文章则可能保留语法,却改变术语与主题的分布。原论文的操纵不足以给这两件事标上同一个折扣率。对一批新语料,先说清相对于哪种测试文本、哪种任务所谓“质量更高”,比给它套一个看似精确的系数更有用。
第三张底牌:把较贵的训练遮住,能猜中答题分数吗?
Krajewski 等,第 3 节、式 2–3提供了较贴近这道题的证据。在每个参数对应二十个训练词元的设置中,他们直接用训练算力预测各任务的分数:拟合的是准确率取负对数后的量,每项基准有自己的系数。对于选择题,瞎猜本来就可能得分,作者还估计随机基线并据此归一化。这个处理决定了曲线底端的含义;不能拿一个接近猜测水平的小模型原始分数,直接塞进针对校正后分数拟合的公式。
作者用低于 次浮点运算的训练来估系数,把其余训练留作验证。表 1给出跨指标平均的绝对误差:拟合部分为 0.0086,留出部分为 0.0195。这里比较的是同一预测方法在两组训练配置上的误差;后一个数不是每个任务的误差上限,也不是模型答错题目的比例。它的价值在于预测经受了比随机混分大小模型更接近真实用法的考验,而不是小数点后有几位。
若把每个参数读多少词元也放开,作者改用同时包含参数量和数据量的公式,并另外划出高预算或高词元参数比的配置。第 3.3 节、表 2 对研究者而言,这处改动比照抄某个平均数有用:原先沿固定配比走得再远,也没有走出那条配比线。要预测线外的点,必须说明多出来的方向如何进入模型,并拿那个方向上的观测检验它。两张表的留出条件和拟合式都变了,不宜把它们的误差差值解读成改公式带来的净收益。
看残差:是规律延续,还是小范围内恰好长得像?
残差是实际值减预测值,保留正负号。两条曲线可以在便宜的几个点上几乎重合,到更大预算时,一条开始变平,另一条继续上升。如果只看全部点的平均绝对误差,既看不出高预算端是否总被低估,也看不出哪项任务拖了后腿。检查时最好把最大的几档按预算顺序排开,对每项任务分别问:误差是否一直同号,误差大小是否已经大到会改变资源选择?一次偏差既可能来自模型形式,也可能来自有限题目的抽样波动,别急着把一个点命名为“转折”。
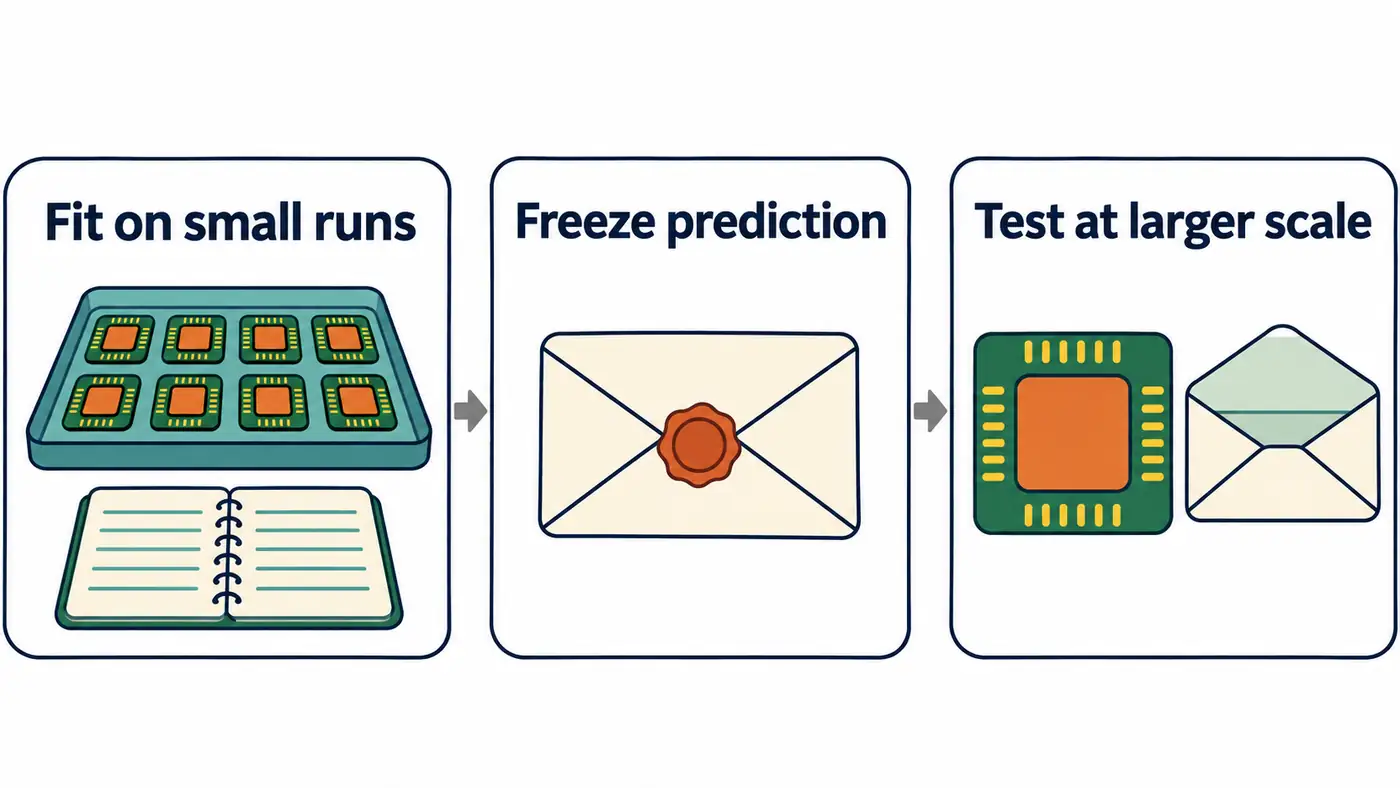
图:为后续研究建议的检验顺序。箭头表示先后,不表示论文发现了因果机制;图中没有测量数据。
可以用一个不必从头训练大模型的设计区分两种解释:一是同一训练配方确实允许小预算预测大预算;二是不同趋势在已见区间内难以分辨。选用公开、配方可追溯的同一家族训练记录,先定一个目标任务、一种判分方式和最大的若干预算档。将这些档位下的整次训练及其检查点一起隔离,不能把大模型训练早期的成绩留在拟合表里又称没见过这次训练。同一批题、同样的推理采样预算用于所有模型,免得训练规模变了,考试机会也跟着变。
只用其余记录比较两个事先写定的方案:照搬最后一个小预算的实测成绩,或者用小预算拟合一条规模曲线。冻结数据筛选规则、函数和预测之后,再揭开保留记录,逐档公布带符号误差和绝对误差。事先用任务能够接受的分数偏差设容差;若曲线在最大档超出容差,或整体不比照搬成绩更准,就停止向更大预算推荐该公式。两种预测若在测量误差内分不开,结论是现有预算无法分辨,不必硬选赢家。若公开数据早已被用来挑公式,应把这一步称为回顾性检验,把真正的盲预测留给下一批训练。
还可以再留一批预算相当但语料配比不同的记录,作为另一次检验:同配方预测准确、换语料后偏差持续同向,说明原来可用的规则需要重新校准,但尚不能指定究竟是哪类文本所致。若规模和语料总是一起变,现有记录就不能拆开这两个解释;诚实的停止点是报告缺少交叉配置。这个设计没有在本文执行,也没有借用其他实验的未公开测试集。
总结:给预测写上有效条件
三篇论文可以连起来读,但不能排成一张成绩榜。第一篇估最优模型大小,提醒我们算力怎么记会改变最优解;第二篇在可控污染中解释损失,提醒我们一个词元并不天然代表等量信息;第三篇才直接以较大预算下的答题分数检验预测。下次看到一条漂亮的扩展曲线,可以要求作者补完一句话:我用哪些小训练,预测了哪个未参与拟合的大训练,在什么指标上偏了多少? 能补完,就有一段可引用的外推距离;超出那段,仍是一个值得下注、也可能猜错的假设。
参考资料
- Porian 等(NeurIPS 2024),Resolving Discrepancies in Compute-Optimal Scaling of Language Models。
- Subramanyam、Chen、Grossman(ICLR 2026),Scaling Laws Revisited: Modeling the Role of Data Quality in Language Model Pretraining。
- Krajewski 等(ICLR 2026),Revisiting the Scaling Properties of Downstream Metrics in Large Language Model Training。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。