- 日期:2026-10-10
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-10;检索近12个月工作,同时保留争议起点。本文为四篇一手研究的证据深读,未运行模型实验,不声称全面覆盖。
摘要:多想的价值,要在同一道题上判断
模型第一次给出了正确答案,随后又检查、换解法,最后改成错误答案。这与“想了很久才终于做对”都可能出现在长推理里。只看生成长度,无法知道额外计算属于哪一种情况。
本文的判断是:**延长推理可以帮助特定模型解决特定问题,但没有证据支持长度越长、答案就越可靠;同样,缩短回答也不自动等于找到了正确的停止时机。**预算干预、轨迹诊断和在线早停研究回答的是不同问题,不能用一条平均曲线相互推翻。s1、轨迹诊断研究、REFRAIN提供了这些不同层次的证据。
这里新增的问题不是推理方法有哪些,而是:**怎样区分有用的追加计算、无用的重复,以及会丢失正确答案的继续生成?**更进一步,研究者事后知道何时该停,是否意味着模型当时也能知道?
“更长”与“过度”,先分清测量对象
思维链是模型在最终答案之前生成的中间推理文本;token是模型处理文本的基本单位。本文讨论可见推理长度,不把文字数量当成全部内部计算,也不把篇幅长直接判为过度思考。
至少要区分三种长度。预算上限是允许生成多少,实际长度是模型最终用了多少,首次正确前缀长度则是在已有轨迹的若干截断位置中,最早能诱导出正确答案的位置。前缀就是从开头保留到某一步的文本。最后一种量需要额外提问、答案抽取和正确性核对,通常属于事后诊断。前缀协议见Caldarella等§3.1、附录C.1
“长回答更容易错”至少有三种解释。第一,难题既需要更多尝试,也更难答对,难度同时影响长度和正确率。第二,模型重复检查已解决的问题,增加成本却不改变结果。第三,继续生成引入了新的错误。三者可以并存;把不同题目的长短回答分组,无法单独辨认第三种解释。
一个假设例子有助于理解:模型短答做对了简单题,长答做错了难题,不代表把难题的回答剪短就能做对。相反,如果同一前缀立即作答正确,继续生成却作答错误,证据就更接近“这次继续生成不利”。它仍然只涉及给定前缀、续写方式和答案判定,不能直接解释内部机制。这个例子是概念说明,不是本次测量。
四项证据,放回各自的实验条件
延长预算能有收益,但延长方式也在起作用
s1以经过指令训练的Qwen2.5-32B为起点,再用筛选的推理轨迹进行监督微调。它用budget forcing控制预算:到上限就结束思考,想延长时则阻止结束,并可插入“Wait”。论文在所测数学与科学问答上报告预算扩展收益,也报告继续扩展后趋于平台、重复循环和上下文限制。正式版§2–4、§6.2及Limitations
**本篇推断:**这说明某种“模型加解码干预”的组合能够受益于追加计算,并非证明任意长文本都有帮助。插入提示同时改变了后续内容;若要把收益归因于纯粹的长度,还要控制提示与续写策略。平均分提高也不保证每一道题都获益。
冗余可以被压缩,但训练短解法不是现场判断早停
Chen等把一次回答拆成包含明确答案的多轮解法,考察首次正确解法与后续策略重复。其分析涉及QwQ-32B-Preview和DeepSeek-R1,压缩训练则以QwQ为平台。研究从自生成的正确候选中构造较短示例,再做后训练;保留首次正确解法与适量反思是其中一种方案。arXiv v2 §2–3
这里的“首次正确”使用了正确性筛选,不能移植成测试时免费可用的停止信号。正文表4也显示不同压缩方案存在准确率取舍。**本篇据此区分两件事:训练后更善于简洁作答,与冻结模型在一道新题上知道何时停止,并不是同一个能力。**另外,解法切分与策略聚类借助模型,冗余判断受标注协议影响,不能当作内部计算被逐步证明无用。
答案曾经可恢复,不等于当时已被稳定掌握
Caldarella等的2026年预印本对完整轨迹逐个前缀施加结束提示,让模型作答,再用抽取器核对。他们在视觉语言任务为主、并补充纯语言任务的设置中,区分“曾正确且最终仍正确”与“曾正确但最终错误”,报告后一类确实存在。§2、§3及附录C
论文的Optimal Length借助标准答案选择首次正确位置,是一种oracle诊断,即拥有运行时不可得信息的理想选择器。**它测量的是特定协议下的可挽回空间,不是已经实现的早停增益。**一次强制作答命中,还不足以证明模型已形成稳定解法;多次前缀探测也可能增加碰到正确答案的机会。论文附录D明确承认标准答案依赖和探测成本,本文进一步建议检查重复续写的稳定性。
在线信号有实际价值,仍不能替代正确性证明
REFRAIN是一种无需再训练模型的停止方法:已有暂定答案、出现反思信号且新步骤与历史足够相似时,触发停止;控制器根据答案似然与长度惩罚调整相似度阈值。似然是模型给输出分配的概率信号,并不等于答案真实正确。正式版§3
表1中,Qwen3-8B在MATH-500上的准确率由91.40%降至91.20%,整套题的总生成量由2.64M降至1.61M token;其他设置也有收益与退步。论文证明的是所测协议中的效率—准确率折中,不能改写为所有任务零损失。其局限还包括需要读取并干预中间轨迹。表1、§4.3及Limitations
看似相反的结果,为什么不必相互否定
| 证据 | 改变了什么 | 主要观察对象 | 不能直接证明什么 |
|---|---|---|---|
| s1 | 固定训练后模型的预算与续写干预 | 不同预算下的最终正确率 | 每道题越长越好 |
| Chen等 | 正确候选筛选、压缩与后训练 | 生成量、最终表现、解法冗余 | 冻结模型能在线认出正确停止点 |
| Caldarella等 | 前缀强制作答与事后正确性选择 | 正确性沿轨迹的变化 | 无标准答案也能获得oracle收益 |
| REFRAIN | 冻结模型上的在线停止控制 | 最终正确率与总生成量 | 高似然或语义重复就是正确 |
这张表比较问题定义,不排列跨论文分数。模型起点不同,教师轨迹与后训练预算不同,测试题和答案抽取协议不同;“解法轮数”“按换行切分的步骤”“token”也不是同一个单位。即使两个研究都写MATH,版本、子集与生成限制仍须核对。以上条件分别来自四篇原文的方法与评测章节。
尤其不能把“减少冗余”和“减少最终错误”混成一个指标。Caldarella等表2中的早停基线按连续若干步答案不变而停止,缩短了轨迹,却未改善其有害过度思考指标。这与REFRAIN的正面折中结果不构成直接冲突:两者的停止信号、模型和评测均不同,前者也没有在同一协议下检验后者。§3.2及表2
**本篇的综合结论是:额外计算的边际价值可能随题目和当前状态改变,但实际停止器必须承担判断错误的代价。**停止太晚会浪费或改错,停止太早可能截断纠错。准确率相同的两种策略,也可能在不同题目上互有得失。
更有区分力的下一步实验
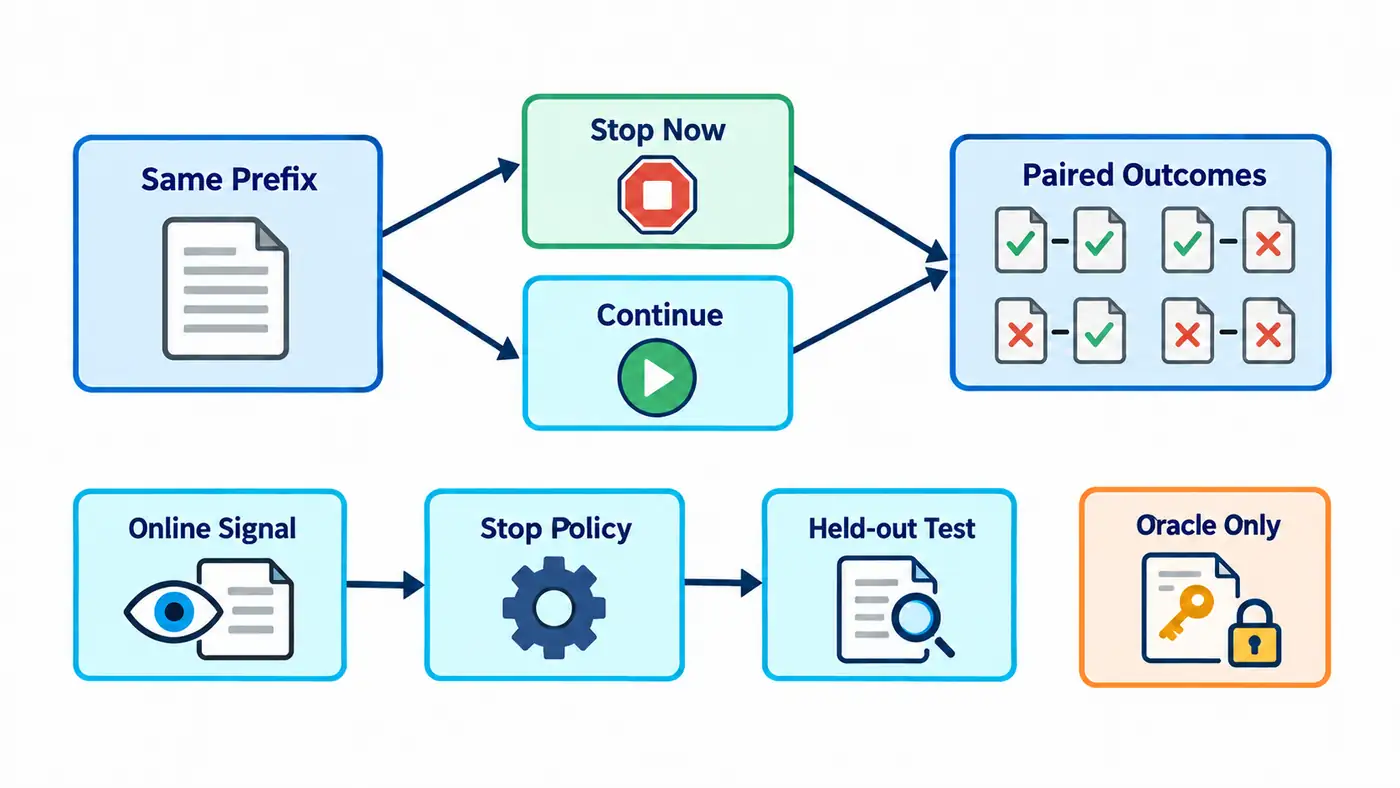
图为本文提出的实验框架,不是论文数据或已证实的因果机制。上排从同一前缀比较“立即作答”和“继续生成”;每对符号左边代表前者、右边代表后者。四种组合仅表示可能结果,无频率含义。下排检验在线信号能否形成可迁移策略;右侧oracle只用于事后参照,不向停止器提供测试答案。箭头表示实验流程,待检验的是策略对结果的作用。
以下设计均未执行,也不需要先开展大规模训练。首先固定模型、题目与公共前缀,在预先规定的位置分出两条续写路径,一条结束思考并作答,另一条追加相同预算再作答。对每个前缀重复采样,分别记录错转对、对转错以及不变,而不是只展示总准确率。若单次早答正确、重复时很不稳定,就应收窄“已经解决”的说法。
其次,停止器只能看实际可获得的前缀、输出概率或重复信号;标准答案留给评测器。候选信号、阈值与允许损失应在开发题上确定,然后冻结规则到另一个未用于选择的题集。若采用持续更新的在线控制器,则预先固定更新规则、无标签反馈和题目顺序,并重复不同顺序,不能看到测试分数后再挑最好的轨迹。这能区分“信号可以迁移”与“在选择集上调得很好”。
最后比较等总预算策略。既报生成token,也计入前缀探测、编码器、验证器与重复作答成本;节省下来的预算若用于额外采样,应作为另一种完整策略重新评估。按预先定义的任务类别或独立难度依据分组,避免直接用本次回答长度给难度命名,形成循环解释。
答案判定也要固定:换一种结束提示或抽取器时,所谓首次正确位置是否大幅变化?如果变化很大,测到的可能部分是诱导与抽取效果。若换一种任务后重复信号经常误停,则支持“信号依赖分布”的解释。模型生成得更短只是过程观察;在未参与选规则的题上,准确率、错误方向和完整成本共同改善,才是更强的策略证据。
总结:值得学习的是停止决策,而非短答案偏好
现有证据允许同时接受两点:追加推理能带来收益,追加推理也可能冗余或有害。真正未决的部分是,哪些在线可见信号能可靠地区分这几种情况,以及它们能跨多大范围的模型与任务迁移。
读下一篇“推理缩短但性能保持”的论文时,应追问它如何选出停止点、谁知道答案、成本算到哪里,以及平均分背后哪些题被救回、哪些题被过早放弃。这样才是在评估停止能力,而不是把长短本身当作能力。
参考资料
- Niklas Muennighoff等,2025,s1: Simple test-time scaling。EMNLP 2025正式论文;本文阅读正式版方法、结果与局限。会议页面|全文
- Xingyu Chen等,2025,Do NOT Think That Much for 2+3=? On the Overthinking of Long Reasoning Models。ICML 2025正式收录;本文实验细节据可访问的arXiv v2(2025-02-01)核验,其题名使用“o1-Like LLMs”,初稿为2024年。正式PDF访问失败,未将两个版本视为逐字一致。会议页面|所读v2全文
- Simone Caldarella等,2026,Thinking Past the Answer: Evaluating Harmful Overthinking in Large Reasoning Models。arXiv v1,2026-06-01;本次未确认正式录用,按预印本引用。版本页面|全文
- Renliang Sun等,2026,Stop When Enough: Adaptive Early-Stopping for Chain-of-Thought Reasoning。ACL 2026正式论文,方法名REFRAIN。会议页面|全文