- 日期:2026-10-27
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-27;检索近12个月工作并保留必要经典研究。本文是文献深读,未运行模型纠错实验,不声称全面覆盖。
摘要:第二次回答,凭什么更可信?
让模型“再检查一遍”,它常会写出一段反省,再换一个答案。读者容易把这个过程理解为:模型发现了错误,所以修正了错误。但同样的表象也可能来自重新采样、提示中的暗示,或者执行器提供的新信息。答案变了,只能证明发生了修改。
**本文的判断是:自我纠错需要同时考察错误识别、修改能力与保留正确答案的能力;不同反馈和训练条件下的结果,不能合并成一句“反思有效”或“反思无效”。**Self-Refine、Huang等、CRITIC与SCoRe的主要差别,首先在于任务与信息条件,而非各自属于哪个阵营。相关定义与设置:Huang等§2–3。
本篇追问的是一次作答之后怎样决定改不改,不讨论把自生成材料重新用于训练的完整闭环,也不重复多智能体分工的预算比较。
“自己改”至少包含三件事
内在自我纠错指推理时没有收到新的检索结果、工具反馈或正确性标签,由模型根据题目和已有输出再作判断。它不意味着模型从未接受人工数据或奖励训练。外部反馈则是此次修改新增的观察,例如执行报错、网页证据,或者“这个答案错了”的标签。
还要区分生成新候选与选择最终答案。即使第二份答案更可能正确,系统仍须决定是否替换第一份。反过来,即使候选中存在正确答案,系统也未必能认出来。一个知道标准答案、只让错题进入修改的评测器,已经替模型完成了部分判断;这种知道真值的设置通常叫oracle。
为避免把不同机制混在一起,可以提出三种竞争解释。第一,重新计算或改用另一条路径就足以带来收益,自评文字未必是必要原因。第二,模型确实利用了自己的批评定位错误,收益依赖批评内容。第三,新增的工具观察或正确性信号改变了可用信息。它们可能同时存在,需要分别干预,不能凭一条成功对话确定哪一种主导。
直观地说,把解题稿重新誊写一次、指出哪一步不成立、用计算器检查中间结果,是三个不同动作。最后都可能得到正确答案,但科研问题是:去掉其中哪个动作,改善就会消失?
看似对立的论文,究竟比较了什么?
Self-Refine:改善输出不等于普遍识别推理错误
Self-Refine让同一模型依次生成、反馈和修改,不额外更新权重;反馈提示包含任务示范。其任务覆盖对话、代码和约束生成,评价既有任务分数,也有偏好判断。正式论文表1中,GPT-4数学解题率由92.9变为93.1,与若干生成任务的大幅改善不是同一种证据。Madaan等,§2–3、表1。
因此,不能把跨任务的平均提升解释成“模型能可靠发现自己的逻辑错误”。另一方面,数学收益很小也不抹去改善表达或满足约束的价值。论文附录K.1还把使用正确性信息的数学结果单独列出,不能与普通自反馈混用。这里真正需要统一的是测量对象,而不是口号。
Huang等:停止规则会偷偷带入答案信息
Huang等对照了有oracle标签和无外部反馈的修改。前者答对就停止,后者必须自己决定。在其GPT-4的GSM8K子集上,标准提示为95.5%,oracle修改为97.5%;内在修改第一轮为91.5%。这些是论文当时的固定设置,GPT-4使用抽样的200题,不能当作今天模型的普遍上限。§3.1–3.2、表2–3。
这个对照揭示:不给模型完整答案,也可能泄漏足以保护正确解的信息。它并不证明重新检查在所有任务上必然有害。初始提示是否充分、修改提示是否暗示“一定有错”,也应成为实验条件,而不是藏在方法名称后面。
CRITIC:工具提供了新的观察,但没有接管全部判断
CRITIC把搜索、代码解释器等接入批评过程。问答实验中的无工具消融移除搜索接口,让模型自行生成证据;完整方法在相应设置中表现更好。需要注意,普通CRITIC与带星号、只修改错误样本的oracle版本是分开的。Gou等,§3–4.1、表1。
这支持外部观察具有价值,却不能证明收益全部来自模型的自省。搜索结果还需判断相关性,程序成功执行也不保证题意被正确建模。工具消融同时改变可见信息与交互成本;它不是在保持一切资源相同后,只切换一个抽象“反思能力”。论文附录A也保留了提示、延迟与任务泛化限制。
SCoRe:测试时独立修改,可以是训练后的能力
SCoRe采用两阶段强化学习:先让后续尝试学会改善,再用奖励塑形鼓励有效纠错、抑制把正确答案改错。训练奖励来自数学答案匹配或代码测试;测试修改提示不揭示首答是否正确。Kumar等,§3、§5–6。
正式论文表2中,Gemini 1.5 Flash起点模型两次作答为52.6%与41.4%,SCoRe训练后为60.0%与64.4%。这是MATH500留出评测;训练加入原MATH测试集中的另外4500题。不能拿这些数字直接与别处的完整原始测试集排名,也不能把训练前后首答和修改收益混为一项。§6、表2。
本文据此作出的有限推断是:“普通提示未稳定诱发”不等于“无法训练获得”。但训练后无需逐题反馈,与训练过程中没有外部监督,是不同主张。
| 路线 | 需要先固定的条件 | 观察主要支持什么 | 仍不能证明什么 |
|---|---|---|---|
| Self-Refine | 任务、提示、偏好或正确性指标 | 一些输出可通过反馈迭代改善 | 各类推理错误都能被识别 |
| Huang等对照 | 是否用真值决定停止 | 判断与停止会改变净收益 | 所有模型永远不能纠错 |
| CRITIC | 工具、示范、普通或oracle模式 | 外部观察可帮助修改 | 增益全部来自内在反思 |
| SCoRe | 训练奖励、起点和留出划分 | 专门训练后可获得修改收益 | 无监督自省或通用迁移 |
这些论文没有共享模型起点、训练数据与总预算。表格用于对照证据条件,不用于排列谁的准确率最高。
总分之外,要看哪些答案被改坏了
2026年9月,Tianzhu Zhang的预印本进一步区分“错改对”与“对改错”,并研究何时调用修改过程。本文采用其转移统计视角,但不把选择器收益当作已确立结论:作者承认部分历史结果尚未对应到冻结配置及互不重叠的样本ID,独立评测证据不完整。§2.3、§4.2、§6。
对同一批题目、固定解析器和二元正确性判定,准确率变化满足:
其中是全部题数,两个分别是两类转移的题数;这是计数恒等式,不是本次模型实验。它说明同一个净增益,可以来自保守地修好少量错误,也可以来自大量修复与大量破坏的抵消。
还应分别报告:初始错题中多少被修复,以及初始对题中多少被破坏。二者分母不同,不能把百分比直接相减;某类初始样本为空时,对应条件率应记为未定义。首答越可靠,潜在可修复的题越少,对正确答案的轻微扰动就越值得重视;这是基数变化带来的风险,而非高能力模型一定不适合修改。
这篇预印本也提示了另一层边界:缺失答案怎样计分、KEEP/CHANGE如何落实、推理是否被预算截断,都可能改变转移统计。§2.1–2.2。因此,“最终答案更好”仍需建立在相同题目与解析规则上;不能只留下可解析、改成功的样本。
一个能区分解释的后续实验
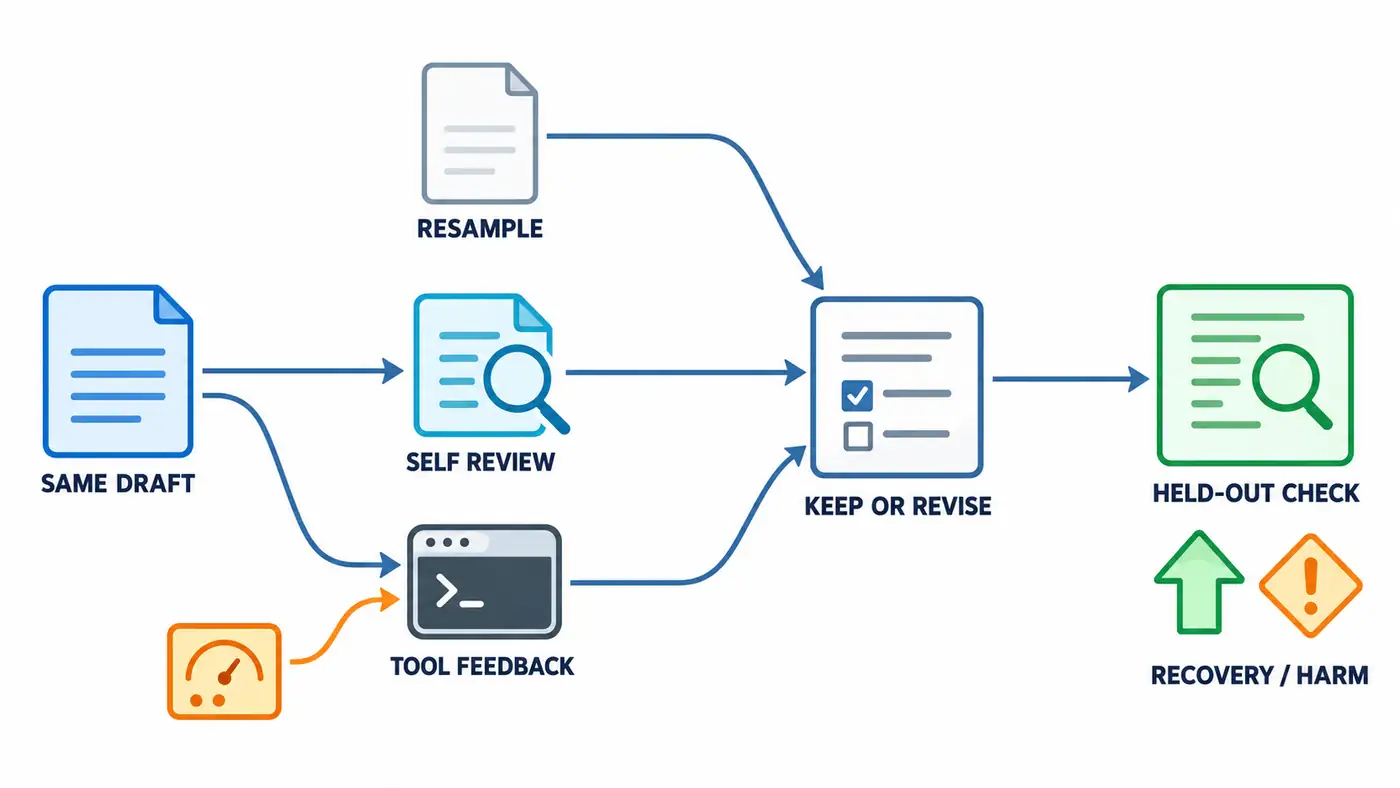
图:这是本文提出、尚未执行的实验框架。三条路线分别运行,不把候选合成一个更强系统;重采样不看旧稿,自评和工具路线接收同一份旧稿。橙色箭头表示新增外部观察,右侧只负责留出评价、不反馈真值;绿色与橙色符号代表修复和破坏两类结果,没有表示测量趋势。保留原答案的基线未单独画出。
研究生可以先选择一个有明确判分规则的小任务,固定模型版本和题目集合,保存每题首答,再做三个对照:不看旧稿重新作答;看旧稿、生成具体批评再修改;看同一旧稿并加入真实工具反馈。另保留不作修改的基线。所有路线使用同样完整的任务说明,避免第二轮才补充要求。
第一轮比较应固定修改次数与输出规则,默认接受各路线的新答案,先测生成阶段的变化。第二轮再引入“保留还是替换”的选择规则,分别与始终保留、始终替换比较。若一开始就用真值挑赢家,就无法判断模型究竟学会了什么。
预算也要分层记录。相同调用次数不代表相同token数:批评、历史上下文与工具返回都会消耗资源。可以同时报告固定总token上限下的结果和实际延迟,把外部调用费用另列;因预算截断而失败的样本必须保留。机制比较与效率比较可以是两个实验,不必假装一张表已经把二者都控制住。
要进一步检验批评是否有因果作用,可在开发阶段设计正确批评、来自其他题目的批评及不含诊断内容的等长文字对照,再冻结设计。若打乱批评仍有相近改善,至少会削弱“具体诊断内容导致修复”的解释;若只有真实工具反馈有效,则应继续检查新增信息是否足够、错误反馈会不会反向误导。任何结果都还需要跨题型验证。
最后,用互不重叠的数据开发选择规则和评价规则,保存每题转移、原始输出、解析失败与停止原因。评分所需的隐藏答案或测试只能用于最终评价。需要人工判断过程正确性时,应由真实标注完成,不能用模型自己的认可冒充语义金标。本篇没有执行这些实验,所述均是可检验设计。
总结:把“反思”拆成可测的动作
目前更稳妥的结论是:重写可能有用,工具反馈可能有用,专门训练也可能使修改更有效;它们并不自动证明同一种内在机制。阅读论文时,先确认谁提供信息、谁决定停止、谁选择最终答案,再检查修复与破坏是否都被计算。
下一步值得验证的不是模型会不会说“我错了”,而是:在预算和信息受控时,它能否找到值得修改的答案,并保住已经正确的答案。这会把一段动听的反省,转化成可以被支持或被推翻的研究主张。
参考资料
- Aman Madaan 等,2023,Self-Refine: Iterative Refinement with Self-Feedback。NeurIPS 2023正式论文。
- Jie Huang 等,2024,Large Language Models Cannot Self-Correct Reasoning Yet。ICLR 2024正式论文;初版预印本发表于2023年。
- Zhibin Gou 等,2024,CRITIC: Large Language Models Can Self-Correct with Tool-Interactive Critiquing。ICLR 2024正式论文。
- Aviral Kumar 等,2025,Training Language Models to Self-Correct via Reinforcement Learning。ICLR 2025正式论文;初版预印本发表于2024年。
- Tianzhu Zhang,2026,When Should LLMs Trust Their Own Revisions? A Risk-Aware Study of Intrinsic Self-Correction。arXiv:2609.35832v1,2026-09-23,预印本,未确认正式录用。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了一些日常小工具,欢迎了解:
- 日常收支小记:记录日常收支,安排预算与储蓄目标,让每一笔钱的去向更清楚。在 App Store 了解。
- 一事微光:按当下的时间和精力选择小行动,记录完成后的感受,为日常行动与复盘留下一点线索。在 App Store 了解。
更多技术文章与个人作品,欢迎访问我的网站:zffjzz.top。这些作品与本文所引论文没有背书关系。