- 日期:2026-11-01
- 读者:研究生、科研新人和工程型研究者
- 范围:三项诊断研究的证据深读;不报告本次模型实验。
摘要:答案正确,证据可能没有被用上
问一张香蕉照片“它是什么颜色”,回答黄色可能来自看图,也可能来自常识。把香蕉换成红色,错误才显露出来;但答错仍可能是没看清颜色、没理解问题,或没有把看到的属性用于回答。**总正确率不能独自区分这些解释。**封面中的红色香蕉只是概念插画,不是论文测试样本。
本文围绕三个诊断入口展开:VLind-Bench先检查基础能力,再评估反常识图像;Winoground固定词汇、改变组合关系;VisRes把视觉任务拆成感知和规则推断。它们不是“视觉有效”与“语言有害”两个阵营。本篇关心的是:什么观察足以支持模型依赖视觉证据,什么观察还不能定位失败原因。
“看图”至少包含三件不同的事
视觉语言模型,简称VLM,是同时处理图像与文本的模型。视觉问答则要求它依据图像回答问题。这里的语言先验,指从训练中学到的常见搭配、事实或答案倾向;它能帮助理解问题,也可能在图像与常识冲突时替代现场证据。
需要区分识别对象、绑定关系和使用证据。看见“杯子”和“碗”,不等于判断出谁在左边;正确说出红色,也不等于回答后续问题时没有回到“香蕉通常黄色”的默认答案。三个环节可能同时出问题,不能把所有失败都算作语言偏见。
以下是本篇用于阅读证据的三种竞争解释。第一,模型主要靠题目和常见答案,图像贡献很小。第二,模型确实接收视觉信息,但压缩、分辨率或属性识别限制了可用证据。第三,信息已经可以被单独识别,却没有稳定进入关系判断。它们对干预的预测不同:改问题措辞、提高分辨率和交换对象关系,不应只被当成三种“提分技巧”。
反常识答错,先检查它是否具备前提能力
VLind-Bench给出的关键方法是条件化诊断:检查常识知识、图中对象识别,以及有明确文字情境时能否接受反常识设定,再在满足前提的样本上测图像条件下的判断。每项要求正确处理真假两种陈述。论文表3显示,过滤后的流水线得分与全体样本准确率并不相同。Lee等,§3、§5.1与表3
这改变了我们能说的话。若模型连图中目标都认不出,继续批评它“明明看见却不相信”,证据不足;若提供文字情境后仍拒绝反常识回答,也不能只归因于视觉通道。作者的方法减少了混杂,但其局限节明确承认仍可能存在未考虑因素与提示敏感性。原文Limitations
**本篇推断:通过前提测试,不等于完全排除了感知问题。**对象存在性检查比细粒度属性、主体与客体绑定更容易。能认出一把剑,未必能稳定判断它被谁拿着;能接受文字描述,也可能只是文字把答案直接说清楚了。流水线更像诊断筛选器,而非对内部机制的完整证明。
还要留意分母。各模型通过前提的样本集合可能不同,因此较高的条件得分不自动意味着它在同一组难题上更强。比较时应同时给出进入末阶段的覆盖量、全体题目的任务表现,以及共同通过子集上的结果。只保留一个漂亮的末阶段百分比,会把“剩下的题较容易”与“利用视觉更好”混在一起。
词都认识,关系却可能没有配对成功
Winoground把两张图与两句使用相同词汇、不同排列的描述组成一组。这样,靠“出现了哪些词”难以完成匹配。它分别检查给图选句、给句选图,以及两种方向同时成立的组得分。原文表3中的受测模型在组指标上均低于其随机基线;这描述的是当时的模型与协议。Thrush等,§3–5、表3
它提供的不是又一个通用榜单,而是一种困难负例设计。负例与正例共享大量对象和词汇,错误集中在组合关系上。普通检索可能只要求从明显不同的候选中挑出相关图片;关系诊断则要求在“对象都对”的候选之间作区分。
**本篇推断:双向配对比单次命中更有说服力,但仍不能单独定位故障。**图像编码、文本词序处理和跨模态比较都参与匹配;失败可能发生在任一处。照片还可能含有歧义与背景差异,不能把两张真实照片直接视作只改变关系的完美因果干预。
因此,不能把该论文的历史结果改写为“今天所有多模态模型都不会看图”。把生成式模型改成回答选择题,也改变了评分接口。若复测时调整提示、候选位置或回答抽取规则,应先保证每个模型接受同一种协议,再讨论进步来自哪里。
视觉谜题失败,也可能是输入表征的问题
VisRes提供感知补全、单属性规则和多属性组合三个层级,并设置视觉上相近的干扰选项。它还单独测试属性识别、改变输入分辨率,并将规则题转写成文字。本文实验依据为2025年12月的arXiv v1;CVPR 2026发表身份由正式目录核对,不把未取得的会议全文当作已读版本。Törtei等,§3–5
该版本表7中,GPT-5的第二层级在输入从1024升至2048时,准确率由49.61降至48.99;所以“更高分辨率逐档提高所有层级”并不符合表格。文字化规则题也表现更好,但这不能唯一证明视觉编码器是瓶颈:文字已经完成属性提取,并改变了表示形式。原文§5.2、表7
**本篇推断:看清楚与推理正确之间,需要可干预的桥梁。**如果增加分辨率改善成绩,它支持输入细节或处理方式影响结果;但增加图像信息通常也改变视觉令牌与计算成本。若直接提供准确的属性表后表现改善,说明该表示对任务有帮助,却没有证明模型原本已经感知到同样的信息。
同理,困难负例会让测试更有区分度,也会改变测试分布。选项都很相似时,低分可能暴露精细视觉辨别不足;它不是“训练中所有视觉知识无效”的证据。研究者需要报告负例如何选择,以及结论在普通候选和相似候选下是否一致。
三项研究能拼出什么,不能拼出什么
| 诊断入口 | 观察对象 | 能支持的判断 | 不能直接证明 |
|---|---|---|---|
| 反常识前提筛选 | 基础测试通过后的图像判断 | 部分简单失败解释已被限制 | 剩余错误都由语言先验造成 |
| 同词汇双向配对 | 组合关系与匹配一致性 | 词汇共现不足以完成任务 | 故障一定发生在视觉端 |
| 感知与规则分层 | 属性、分辨率和表示改变 | 输入与任务结构影响表现 | 所有差距只有一个机制 |
上表是对三项协议的归纳,不是跨论文排名。它们的模型起点、数据来源、训练经历、推理预算和指标均不统一:有图文打分,也有真假判断和四选一;有条件分母,也有成组要求。公开模型与闭源接口的训练信息可见程度也不同,不能从这些论文拼出“同等训练预算下哪种架构更会看图”的结论。
当前证据更适合支持一个有限判断:**视觉任务高分与稳定依赖视觉证据之间,存在需要单独测量的距离。**语言知识可以提供概念与规则,视觉输入提供当前场景;真正的问题是冲突时能否依据任务要求调整,而不是彻底消除语言知识。这是本篇综合判断,不是某一篇论文证明的普遍定理。
下一步:让不同解释给出不同预测
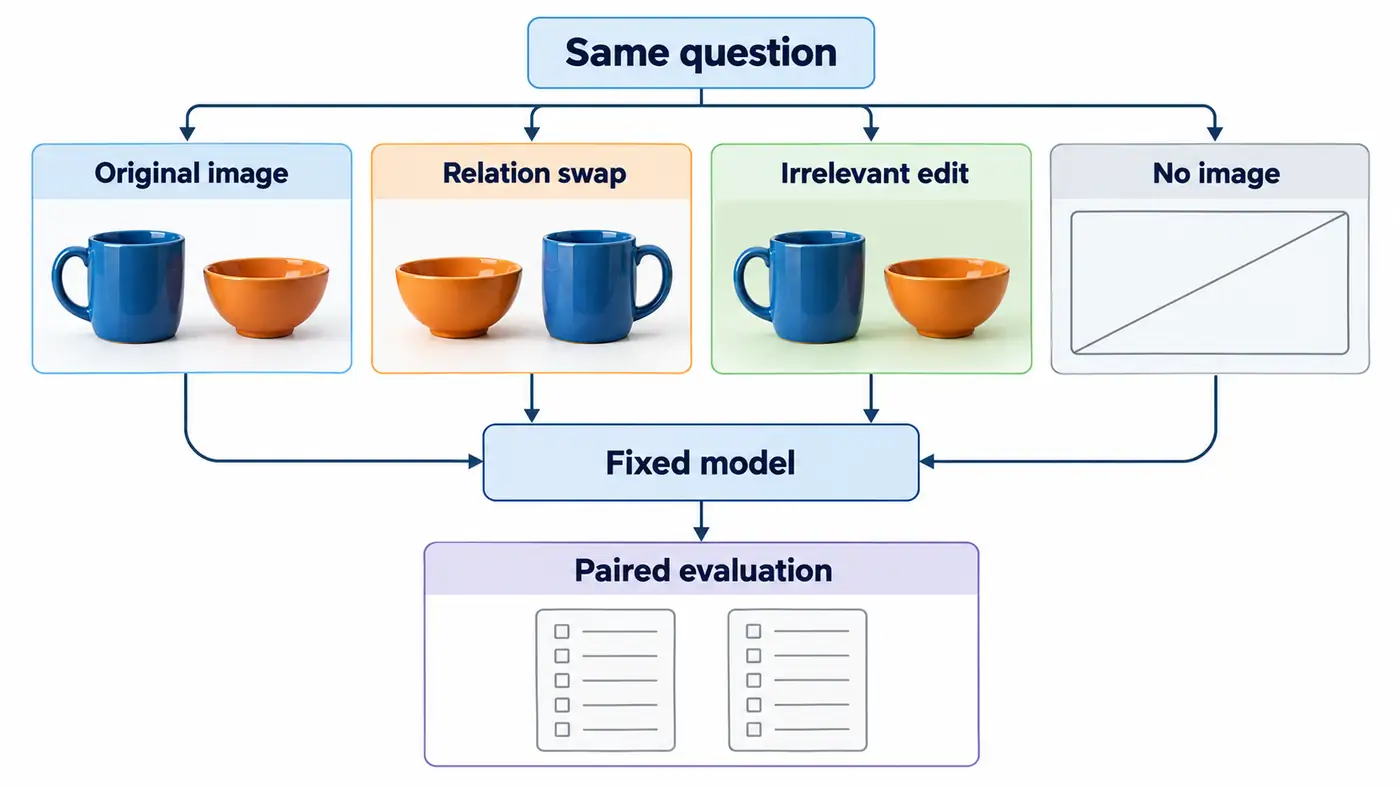
图:本篇提出的未执行实验。四种输入分别送入同一模型,箭头仅表示评测流程,不表示模型内部因果机制,也没有已观察的结果。关系交换图只是示意,实际测试须保持杯柄方向等非目标因素一致。
可从一组对象关系清楚、答案平衡的场景开始。固定问题,分别提供原图、改变目标关系的图、只改变无关背景的图,以及模型原生支持的无图输入。目标关系改变时,正确答案应改变;无关编辑时,正确答案应保持。测试的重点是这两类响应能否同时成立。
首先,把对象识别与关系判断分开提问,使用独立会话,避免前一个回答提示后一个答案。记录所有样本,再附上共同通过识别检查的子集。若只看通过子集,必须报告筛掉了多少、筛掉的是什么题;否则容易把模型最严重的感知失败从结论中删除。
其次,固定检查点、提示、候选顺序规则、解码参数和预算。提高分辨率的实验另行报告图像令牌与费用,文字属性表作为外部信息条件单列。无图输入若不受接口支持,就如实标记该控制不可实施;不要默认全黑图片等价于没有图像。
最后,观察配对正确性,而不仅是答案有没有变。错误答案之间来回切换也很敏感,却不是证据利用。若关系变化引起正确翻转、背景编辑保持正确,才较支持选择性使用相关信息;若所有编辑都扰动答案,更像输入脆弱性;若所有编辑都不改变回答,则还需区分任务无须看图与模型忽略图像。
实际执行前还需要独立判断编辑后的语义是否准确,并检查遮挡、视角和伪影。不能让同一个待评模型既生成图片又给出唯一金标。本文没有开展这项实验,也不声称已有人工标注;上述设计的价值,在于把下一步证据要求写清楚。
还应提前规定什么结果会改变判断。例如,若文字条件同样频繁混淆左右关系,就应降低对“纯视觉故障”的信心;若只有某种背景编辑导致退化,则先调查编辑痕迹和输入处理。保留不符合预期的样本,比在看到结果后重新定义“需要视觉的题”更能约束解释。
总结:把“看见了”变成可检验的问题
判断视觉推理,不必先选“真理解”或“只猜测”的立场。先问图像是否必要,再问相关变化能否引起正确变化,最后检查无关变化是否保持稳定。前提筛选、成组配对和表示干预分别补上一块证据,但任何一块都不足以独自证明内部理解。对科研新人,更有价值的结果是缩小失败解释的范围,并明确哪一次干预可能推翻当前判断。
参考资料
- Lee, Kang-il; Kim, Minbeom; Yoon, Seunghyun; Kim, Minsung; Lee, Dongryeol; Koh, Hyukhun; Jung, Kyomin. VLind-Bench: Measuring Language Priors in Large Vision-Language Models. Findings of NAACL, 2025。正式全文。
- Thrush, Tristan; Jiang, Ryan; Bartolo, Max; Singh, Amanpreet; Williams, Adina; Kiela, Douwe; Ross, Candace. Winoground: Probing Vision and Language Models for Visio-Linguistic Compositionality. CVPR, 2022。已读arXiv v2全文;正式发表页。
- Törtei, Brigitta Malagurski; Dahou, Yasser; Huynh, Ngoc Dung; Para, Wamiq Reyaz; Lê Khac, Phúc H.; Singh, Ankit; Chaybouti, Sofian; Narayan, Sanath. VisRes Bench: On Evaluating the Visual Reasoning Capabilities of VLMs. 2025预印本,CVPR 2026发表。已读arXiv v1全文;正式发表页。
检索与资料截止日期:2026-11-01。检索覆盖近十二个月相关工作,并保留经典诊断设计;不声称全面覆盖。CVF页面直开受限,发表信息使用其官方检索记录核对,实验细节以明确列出的已读版本为准。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了一些日常小工具,欢迎了解:
- 日常收支小记:记录日常收支,安排预算和储蓄目标,让每一笔钱的去向更清楚。在 App Store 了解。
- 一事微光:根据当下的时间、精力选择小行动,记录完成后的感受,给日常复盘留下一点线索。在 App Store 了解。
更多技术文章和个人作品,欢迎访问作者个人网站。这些作品与本文论文没有技术关联或机构背书。