大模型研究争议:从论文结论到证据边界
摘要:预测对了,还缺哪一种证据?
一个模型生成了逼真的多米诺骨牌视频,倒下的方向也合理。它可能学会了接触如何传播,也可能沿用了常见画面的续写方式,还可能先生成许多候选,再由另一个模型挑出较合理的一条。仅看最终成片,这些解释很难区分。
本文讨论一个较窄的问题:视频预测在什么条件下,能成为模型掌握可迁移动力学的证据?结论是,画面质量、给定条件下的预测准确度、干预后的稳定响应,需要分别测量。三项研究提供了不同层次的诊断,尚不足以把“世界模型”这个名称直接兑换成因果理解证明。这里的“理解”采用可检验的行为标准,不讨论意识,也不要求模型必须写出牛顿方程。
从续写画面到改变世界
视频预测是根据已有帧生成后续帧。动力学模型则描述状态怎样随时间、动作和环境参数变化。“世界模型”可以指这两类模型,也可以指只预测压缩表征的模型;使用同一个名称,并不意味着它们接受了同一种测试。
以小球为假设例子:模型看见小球向右运动,预测它继续向右,只说明这次续写正确。把球从蓝色改成红色、保持速度不变,预测应基本不变;把速度改大、保持颜色不变,位移应相应变化。前者检查对无关外观的稳定性,后者检查对相关变量的敏感性。两种测试缺一,都可能留下捷径解释。
“干预”是主动改变某个因素,并尽量保持其他条件一致;“反事实”进一步问,同一个事件若采用另一种干预会怎样。把提示词换成“更重的球”不自动构成严格反事实:模型可能连材质、背景与初始速度都改了。只有干预对象和共同初始状态可追踪,成对比较才有明确含义。
另一个容易忽略的条件是可观测性。一张静止照片未必包含速度,外观相同的球也可能有不同密度。输入缺失决定未来的信息时,唯一正确的续写可能根本不存在。此时应检验合理结果的分布,或允许模型请求更多观测,而不应把猜中唯一录像当作掌握规律。
三种解释,需要三种不同的压力测试
第一种解释是模型主要依赖外观与常见轨迹的统计匹配。这不等于逐帧复制训练集;插值、重组也能生成从未见过的视频。它的风险在于,无关外观变化可能改变动力学预测。
第二种解释是模型形成了某种可迁移的状态关系。它不必显式保存质量、速度的变量名,但应在一组事先声明的干预中保持一致,并能处理未见参数组合。通过测试会增强这一解释,却仍不能唯一确定内部实现。
第三种解释是系统有能力生成合理候选,但默认采样和筛选不够好。加入搜索后表现提高,可能说明可用候选原本存在,也可能包含外部奖励模型提供的信息。它与第二种解释并不互斥,且必须明确研究对象是单个生成器还是整个系统。
受控实验告诉我们,泛化必须拆开看
Kang等人的研究将视频生成放进受控二维物理环境,区分训练范围内、范围外以及已见对象的新组合。扩散模型从头训练,但视频压缩器使用固定预训练VAE;因此不能称整套系统完全没有预训练。研究报告范围内预测随规模改善,范围外仍存在明显误差,组合泛化则可以受益于扩展数据。1
这一设计的价值在于,物理参数和测试划分可以控制;其边界也同样清楚:它研究的是指定架构、数据范围与任务,不是证明所有视频模型永远无法外推。论文的“基于案例”解释来自行为诊断,不是直接读出了内部检索算法。1
本篇据此提出的判断是:先问测试样本到底新在哪里。“训练中没有这一条录像”,只排除了完全相同的样本;“已有对象的新组合”也不同于“速度超出训练范围”。若论文把三者混称为未见场景,泛化结论就会被放大。反过来,范围外失败也不能抹去范围内学到的有效关系。
真实录像更贴近世界,但评分仍是代理
Physics-IQ用真实物理场景检验后续视频,给单帧模型一帧,给支持多帧的模型一段上下文。它结合运动区域的空间、时间重合度与像素误差,并用两次真实拍摄间的差异进行归一化。论文指出,视觉逼真与这些物理预测指标并不等价。2
这个分数不是“理解了多少百分比物理学”,也不是逐条检查物理定律的通过率。作者明确承认指标是代理,镜头移动、切镜等也会受罚;视觉逼真评估还受作为裁判的多模态模型能力限制。单帧与多帧的信息量不同,所以不能将模型总分直接解释成架构的因果优势。2
这提示一种读论文的方法:把输入信息、输出目标和评分器一起读。若模型预测的位置合理但时间错位,空间指标可能不错;若模型擅自换镜头,像素对齐会失效。研究者需要拆解失败发生在状态估计、运动预测还是输出呈现,不能让一个综合分数承担全部解释。
推理时改善,究竟改变了谁?
2026年的WMReward使用V-JEPA 2的表征预测信号,为生成候选打分或引导去噪。Best-of-N指生成多个候选再挑选。其PhysicsIQ实验采用16个候选的搜索设置,报告加入该方法后若干条件下分数改善;生成器无需再训练,但系统增加了奖励模型与推理成本。3
论文也报告文生视频中物理一致性与文本符合度的权衡,并承认奖励模型对重量、摩擦等材料属性仍有限制。本文采用可访问的v2预印本,不把挑战赛成绩当会议录用,也不把文中的归一化分数当物理定律通过率。3
这里最有用的推论不是“物理知识已完全藏在生成器里”,而是默认输出无法完整代表系统经搜索后的可达表现。若选片器带来独立先验,改善应归于组合系统。只观察最后一条影片,无法区分生成器更懂物理、采样更多或裁判更会识别错误三种贡献。
| 证据来源 | 受控对象 | 支持的观察 | 尚不能证明 |
|---|---|---|---|
| PhyWorld研究[1] | 合成参数、训练分布 | 泛化类型影响结果 | 一切模型的外推上限 |
| Physics-IQ[2] | 真实录像续写与评分 | 逼真与预测表现需分开测 | 分数直接代表因果知识 |
| WMReward[3] | 奖励与推理策略 | 系统输出可因搜索改善 | 生成器独自掌握全部规律 |
三篇工作的模型起点、训练数据、推理预算和指标不同。受控速度误差不能与真实录像综合分数排在同一榜单;搜索系统也不能与单次采样混作等成本比较。它们是互补诊断,并非相互推翻的两派。
更能区分解释的下一步
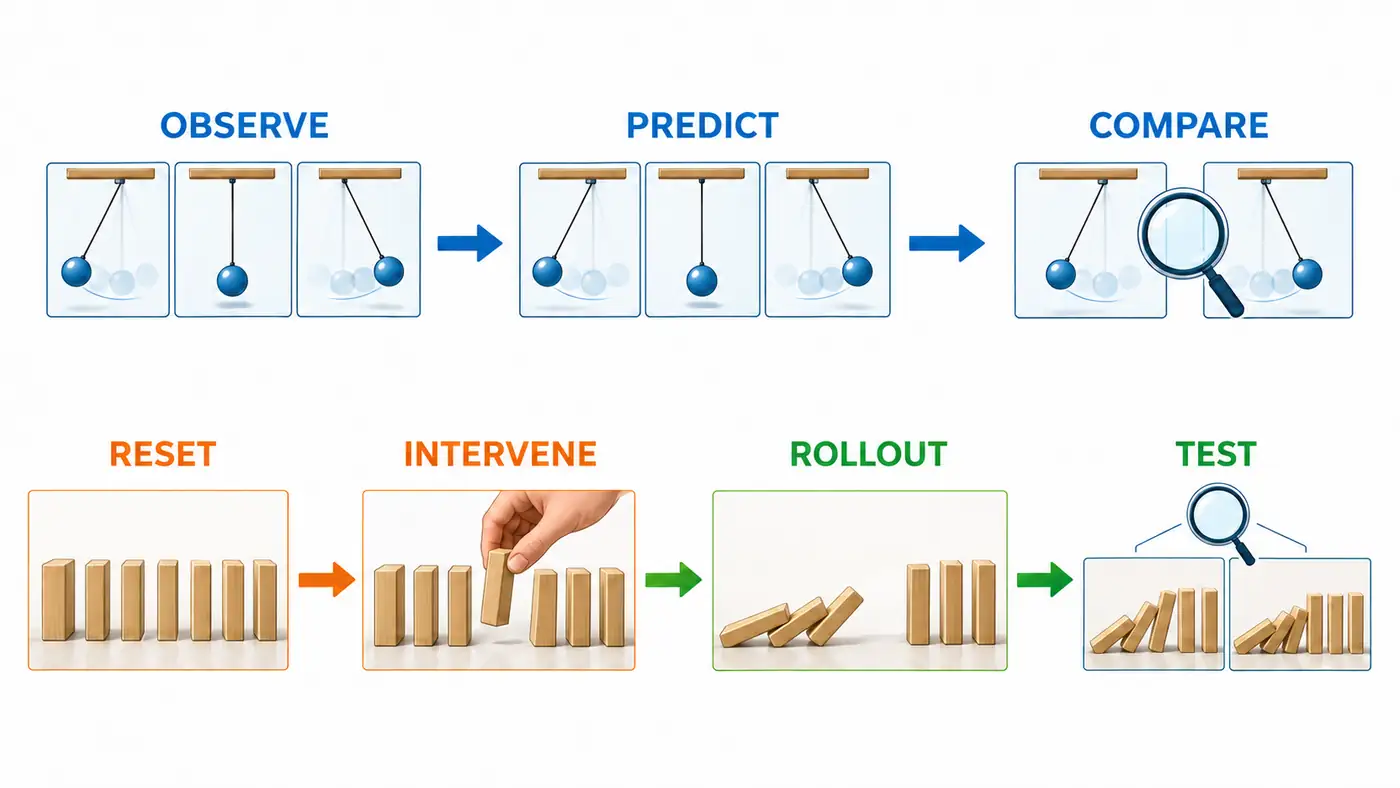
图:原创测试流程示意,上排检查观察后的预测,下排检查重置、干预后的响应。箭头只表示评测顺序;骨牌是概念图标,不是模拟数据。右下两幅表示待比较的候选结果,不宣称任何论文已经通过这些干预。
下面是尚未执行的研究设计。目标不是再做一个“看起来更好”的展示,而是在同一模型上制造竞争解释会给出不同预测的条件。
第一,建立成对干预集。用可记录状态的简单环境,同时保存图像和参数。把颜色、光照作为外观因素,把初速度、摩擦作为动力学因素,独立改变并交叉组合。训练与测试按参数区域及组合分开,防止同一轨迹仅换颜色便跨越划分。若换色带来大幅轨迹变化,而改变摩擦却几乎无响应,统计捷径解释会得到支持;若响应方向和幅度都合理,才能积累关系迁移的证据。
第二,固定候选池比较选择器。对相同初始条件保存全部随机种子和候选,分别用随机挑选、外部奖励与环境真值评分。真值选择只作为诊断上限,不能伪装成部署结果。若真值能挑到好候选而奖励模型不能,瓶颈更接近选择;若池中没有好候选,还需要扩大预算或改变生成器,不能仅凭有限失败断言其概率为零。
第三,做重置后的动作分叉。让系统从同一状态预测“移走阻挡物”和“保留阻挡物”的后续,再与环境实际执行比较。控制接口必须记录动作发生的时刻、作用对象与执行结果。只改变文字描述、无法确认环境是否执行的试验,回答不了动作因果问题。
这些试验还应预先约定误差口径、测试时长与失败处理:物体出画、解析失败、拒绝生成要单独计数,不能悄悄丢弃;图像到状态的解析器要先在真实或模拟真值视频上校准。多帧输入和单帧输入分别报告,采样次数与总计算预算一起保存,避免把测量误差、更多信息或更多计算误判成理解提升。
当前结论与仍然开放的问题
现有证据足以反对一种过强推断:生成逼真视频,就已经获得普遍的因果世界模型。证据也没有支持相反的绝对判断:视频预测只能记忆,规模与推理策略都不可能有用。更稳妥的结论是,把能力绑定到具体状态、干预范围、信息条件和预算上。
真正值得追问的不是名称是否配得上“世界”,而是失败在哪一层。能否识别状态,能否响应干预,能否保持长时一致,能否知道信息不足,是不同问题。把这些问题拆开,研究生才可能提出能被实验否定的解释,而不是在成功样例和失败剪辑之间选边。
总结
视频预测提供了学习动力学的训练信号,也提供了观察模型行为的窗口;它本身不自动完成因果验证。读一篇世界模型论文时,先确认它改变了什么、固定了什么、测量了什么,再判断证据支持的是合理画面、准确预测还是可迁移的干预响应。本文不声称全面覆盖截至检索日的研究,也未执行模型复现。
参考资料
资料检索及截止日期:2026-10-31。近12个月检索用于补充新证据,同时保留解释问题所需的早期研究。
- Bingyi Kang、Yang Yue、Rui Lu、Zhijie Lin、Yang Zhao、Kaixin Wang、Gao Huang、Jiashi Feng. How Far Is Video Generation from World Model: A Physical Law Perspective. ICML 2025;正式发表页,本文方法与结果核验采用arXiv v2全文(2025-06-22)。
- Saman Motamed、Laura Culp、Kevin Swersky、Priyank Jaini、Robert Geirhos. Do generative video models understand physical principles?. 2025,arXiv v3全文(2025-02-27)。检索发现WACV 2026正式页面线索,但页面与PDF访问受限,本文实验描述严格限于已读v3。
- Jianhao Yuan、Xiaofeng Zhang、Felix Friedrich、Nicolas Beltran-Velez、Melissa Hall、Reyhane Askari-Hemmat、Xiaochuang Han、Nicolas Ballas、Michal Drozdzal、Adriana Romero-Soriano. Inference-time Physics Alignment of Video Generative Models with Latent World Models. 2026,arXiv v2全文(2026-02-27),按预印本引用,未确认会议录用。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了两款日常小工具,欢迎按自己的需要了解:
- 日常收支小记:记录日常收支,安排预算和储蓄目标,让每笔账有迹可循。在 App Store 了解。
- 一事微光:根据当下的时间、精力选择小行动,记录完成后的感受,留下一份日常复盘。在 App Store 了解。
更多技术文章和个人作品,欢迎访问作者个人网站。这些作品与本文所述论文没有背书关系。