- 日期:2026-10-23
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-23。检索近十二个月相关工作,并保留必要的经典研究。本文为论文深读,未执行模型实验,不声称全面覆盖。
摘要:先问保住了什么
模型学习新任务以后,旧题仍然答得对,是不是就完成了持续学习?如果答案来自随时可查的笔记,我们该如何描述进步?反过来,旧题突然答错,是否一定意味着原有知识已经被抹掉?
本文的判断是:**减少遗忘是重要结果,但要和新任务学习、跨任务迁移、记忆访问条件一起报告,才能判断系统究竟学会了什么。**参数中的可调用能力与整个系统的有效能力都值得研究,只是两者不能互相代替。以下五项研究分别提供回放、行为恢复、隐状态记忆、充足样本存储和外部经验复用的证据。
上一篇关注知识存在哪里更容易纠错,本篇转向连续任务之后的能力变化:旧分数保住时,新规则是否也学会了,撤去特定历史支持后又会怎样?
“不忘”与“会学”是两个问题
持续学习指系统依次接收数据或任务,并利用过去经验适应后续任务。这里需要区分稳定性与可塑性:前者是旧任务表现能否保持,后者是新任务能否继续学好。把参数全部冻结,确实能阻止参数被新梯度改写,却不能单靠这一点证明系统会吸收新经验。
“记忆”也有不同位置。回放是在训练时重新使用旧样本,或使用模型生成的旧任务伪样本;检索是在回答时把存储内容送回模型;隐状态记忆则把历史压缩成向量,而非原样保存文字。它们可以组合,不能仅凭方法名称判断学习发生在何处。LAMOL与M+分别展示了前两种训练、存储关系。
一个假设例子可以说明问题:系统先学一种分类规则,再学另一种规则。旧题分数不变,可能因为旧规则被保留,也可能因为系统一直没学好旧规则,或者检索器逐题找到了现成示例。只有第一种解释接近我们想证明的保持;后两种仍需单独检查。这个例子不是论文测量结果。
因此,本文不把“真正学会”当成不可观察的心理状态,而把它拆成可检验要求:相同支持条件下能保持旧能力,能利用新增经验改善新任务,还能在预先规定的变化下迁移。允许查记忆时,要明确结论属于带记忆的系统。
回放能保住表现,但旧经验并非没有代价
LAMOL让同一个语言模型兼任解题者和样本生成器:进入新任务前生成旧任务伪样本,再与新数据混合训练。其GPT-2实验在多种语言任务及任务顺序上显示,生成回放优于直接顺序微调;任务专属生成标记用于缓解早期任务样本逐渐稀少的问题。原文§3、§4.2、表3
这里的“无需额外记忆”不应理解成“不再支付旧经验的成本”:生成和重训都需要计算,回放质量还依赖模型能否产生有用样本。它证明的是特定任务协议下的保持改善,不能据此保证无限长任务流。旧题表现稳定,也不能自动推出新组合能力出现。
ICLR 2026的《Forget Forgetting》把假设换成能保存较多旧样本、却无力反复全量重训。作者提出结合参数重置与权重平均的方法,并在TRACE连续指令任务等设置中评估;论文强调,旧数据充足后,新任务适应仍是问题。正式论文§4–5
这项工作里的记忆主要是供训练回放的样本库,不是作答时的检索工具。语言实验使用Llama-3.2-1B,成本指标包含按显存使用缩放的训练时间;它不能直接代表大型模型的墙钟时间或完整服务成本。作者也把可访问代表性旧数据、较清楚的任务边界列为适用前提。附录A.4、A.5、A.7
两篇并不互相否定:旧样本难保存时,生成回放有意义;旧样本可以保存时,就应把更强的真实回放纳入基线。资源前提变化,本来就会改变值得比较的方法。
答错了,也未必是知识完全消失
《Spurious Forgetting》研究“表面遗忘”:性能下降可能涉及任务对齐受损,即模型不再顺利调用已有知识。作者构造人物属性数据,在预训练知识与后续问答任务之间建立可控关系;模型学习新人物后,旧任务表现下降,但额外恢复训练可重新唤起相当多旧知识。正式论文§3.1–3.2
关键边界是:恢复并非无条件发生。该实验用一半旧任务问答数据训练,在另一半评测;图2还区分普通任务曲线的首词准确率与恢复曲线的完整答案匹配率。因此,不宜直接把两条曲线的差当作“隐藏知识百分比”,也不能写成“原封不动的模型其实一直会答”。
本篇据此推断,观察到失败后,应该区分当前可调用性与经干预后的可恢复性。恢复证据削弱“知识彻底消失”的解释,却不是对所有遗忘的一次性证明。论文也承认冻结底层的策略仍有局限,冻结过多可能妨碍新任务适应。原文图2、附录J.1
记忆留在外面,干扰还会发生吗?
M+把从短期池移出的隐状态放入长期存储,在生成时检索回来。其知识保持实验先写入含答案的材料,再插入干扰文本,最后问答;数据经过短答案和可回答性筛选。这是对历史信息访问的检验,不是学习一串新技能后再测试旧技能。原文§3.2、§4.3
作者报告保持能力改善,但跨代MemoryLLM比较还改变了模型起点和训练数据;阶段消融也包含追加训练。因此,相近GPU显存并不等于相同总存储、训练预算或访问代价,更不能把全部收益都归因于“加了一个记忆库”。原文§4.2、§4.5
更直接的反例来自2026年预印本《When Continual Learning Moves to Memory》。作者固定Qwen-Plus骨干,用BM25检索经历,在ALFWorld和BabyAI各研究一对顺序任务。即使权重不变,加入后续经验后,部分旧任务表现仍会下降;抽象经验与完整轨迹的效果也随任务方向变化。原文§2–4、附录A
作者把这种现象解释为检索与上下文中的干扰。证据支持“外部存储不保证行为永不退化”,但其范围只有两类环境、每类一对任务和每条件两次运行。每次取回约相同数量的经验,也不等于整回合等token或等调用预算;频繁检索尤其需要另算成本。这篇仍是预印本,不能把局部现象推广成所有记忆系统的必然规律。
五组证据不能排成一张总榜
| 证据 | 关键观察条件 | 可以支持 | 尚不能证明 |
|---|---|---|---|
| LAMOL | 伪样本参与后续训练 | 回放改善任务保持 | 无成本、无限期学习 |
| 表面遗忘研究 | 额外恢复训练后再测 | 部分知识可重新调用 | 未干预时能力完整可用 |
| M+ | 干扰文本后的材料问答 | 历史信息访问改善 | 新技能持续获得 |
| 充足记忆研究 | 旧样本保留并用于回放 | 存储假设改变方法比较 | 无旧数据时同样有效 |
| 外部经验研究 | 冻结骨干、顺序更新记忆 | 系统也会出现行为干扰 | 所有检索器都如此 |
表中概括的是上述各篇已核验设置。它们的起点、信息来源、任务长度和计分方式不同,保持率也不指向同一个对象。目前没有理由依据这五篇给出“参数更新或外部记忆谁全面更好”的排名。
尤其要警惕最终平均分:某项旧能力下降,可能被另一项新能力上升抵消;起点很低的任务几乎不下降,也可能只是缺少可丢失的能力。阅读论文时,最好同时看每个阶段、每个任务的结果,以及对应的单任务参考,而不是把“不下降”直接当作学得好。
怎样做一个能区分解释的后续实验
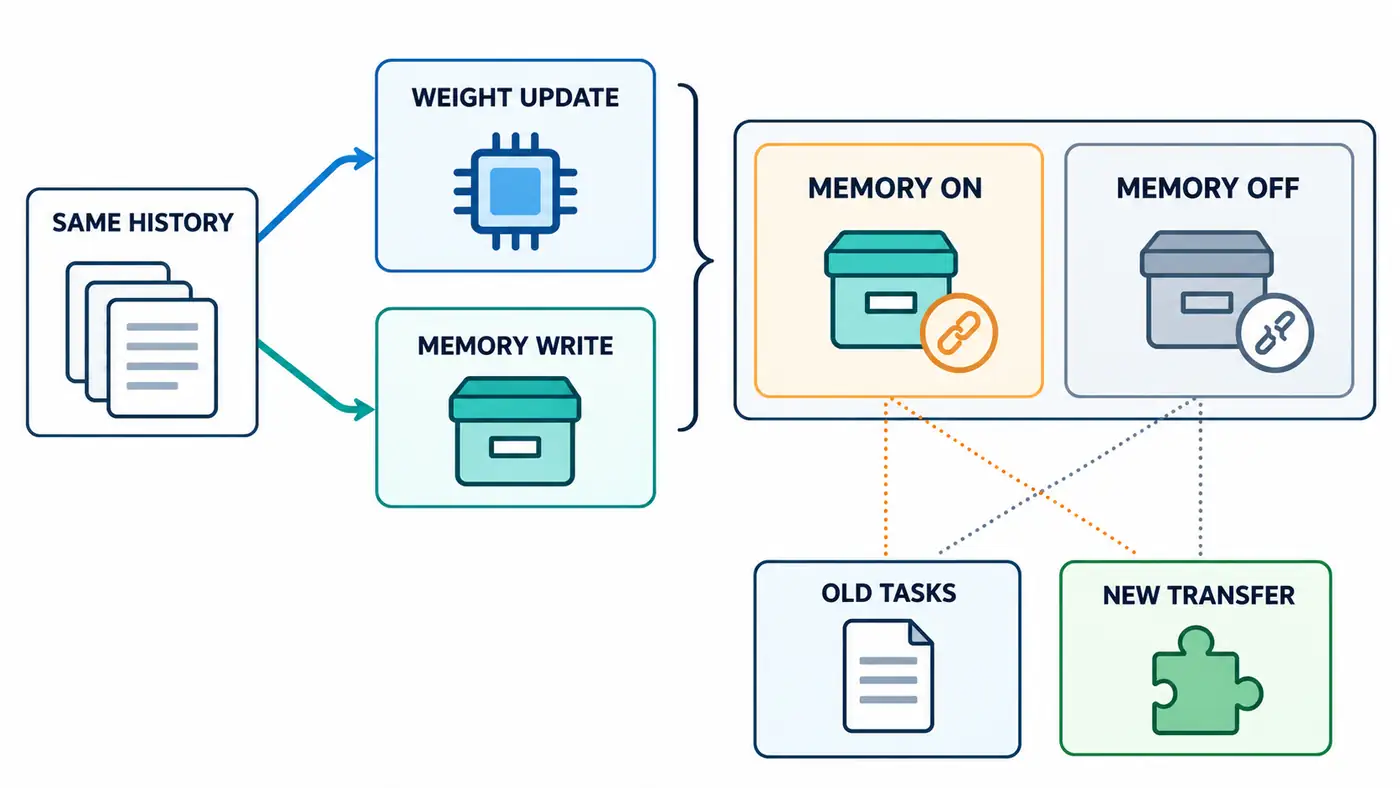
图中实线表示向不同实验分支提供相同历史,括号表示分别进入评测;点线只连接待比较的条件与测试项目,不表示因果提升。右侧应对每个分支分别测试。图不是论文数据,下面的方案也尚未执行。
可从相同检查点和一段固定经验流开始,设置纯顺序更新、带回放更新、冻结模型加外部记忆,以及更新与记忆并用的条件。新旧任务应包含需要规则应用的题,避免只要求找回原句。把近似重复与测试答案从经验库排除,并在开发阶段确定截断、检索和计分规则。
**第一步,拆开保持与新增收益。**每完成一个阶段,都评估旧任务、新任务和未训练的新组合。保存逐题结果,以初始模型、仅学当前任务的模型作为参考。若一个方案保留旧分数却没有新任务收益,它解决的是保持问题,不能被描述成完整的持续适应。
**第二步,干预支持来源。**对同一个训练后状态,分别开放记忆、屏蔽记忆、提供等长无关记忆;若结构允许,再只移除与当前题相关的记录。开放时改善、屏蔽后消失,说明收益依赖访问条件。可是关闭记忆可能本身就是分布变化,所以这种差异不能单独证明“没有学到任何东西”。
**第三步,检查迁移与恢复。**替换题目实体、表达和规则组合,并保持答案不可直接检索。如果规则迁移仍改善,证据比原题复答更强。若做短程恢复训练,要给所有对照同样的数据和预算,并确保恢复集与评测集隔离,防止把重新教答案误称为旧知识恢复。
最后把训练token、回放生成量、记忆字节数、检索次数和回答预算分别记账。无法全部匹配时,报告各自的成本与收益,避免用“同模型”掩盖资源差异。这些对照的目的,是让竞争解释给出不同预测,而不是预先选定某个机制获胜。
总结:让学习结论带上条件
少忘一点,可能来自参数保持、重新对齐、回放练习或检索补偿;这些进步都可能有用。研究结论应说明:什么状态改变了,在什么访问条件下,哪些旧任务保持了、哪些新任务改善了。
真正值得追问的不是记忆放在模型里面还是外面才算学习,而是经验是否带来可重复、可迁移、成本可说明的行为改善,以及改善在哪些条件下失效。把这个问题写清楚,才能从一个漂亮的保持分数走向可检验的持续学习主张。
参考资料
- Fan-Keng Sun、Cheng-Hao Ho、Hung-Yi Lee. LAMOL: LAnguage MOdeling for Lifelong Language Learning. ICLR 2020;本文核验arXiv v2(2019-12-23)全文,PDF标注ICLR 2020发表。全文
- Junhao Zheng、Xidi Cai、Shengjie Qiu、Qianli Ma. Spurious Forgetting in Continual Learning of Language Models. ICLR 2025,正式会议版。论文
- Yu Wang等. M+: Extending MemoryLLM with Scalable Long-Term Memory. ICML 2025;发表信息由PMLR核验,方法与实验依据arXiv v2(2025-05-30)。正式页面|已读全文
- Dongkyu Cho、Taesup Moon、Rumi Chunara、Kyunghyun Cho、Sungmin Cha. Forget Forgetting: Continual Learning in a World of Abundant Memory. ICLR 2026,正式会议版。论文
- Qisheng Hu、Quanyu Long、Wenya Wang. When Continual Learning Moves to Memory: A Study of Experience Reuse in LLM Agents. 2026,arXiv v1(2026-04-29)预印本;未确认正式录用。全文
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了一些让日常更有条理的小工具,欢迎了解:
- 日常收支小记:记录日常收支,安排预算与储蓄目标,让每一笔钱的去向更清楚。在 App Store 了解。
- 一事微光:按当下的时间和精力选择小行动,记录完成后的感受与发现,给日常行动和复盘留一个位置。在 App Store 了解。
更多技术文章与个人作品,欢迎访问我的网站:zffjzz.top。也欢迎分享使用感受,帮助我继续改进这些工具。