资料截止:2026-11-06。本文深读三项一手研究,未运行模型实验。
摘要|先看两张榜单在数什么
假如你给一批助手批改作业,上午按专家记录判定任务成功,下午把同一批作业交给自动裁判。上午排第一的系统,下午落到第二。学生没有重新答题,你还会把换榜首写成“学生退步了”吗?在 Huang 对公开智能体轨迹的分析里,这个问题有一个具体答案。专家标签选出 Claude,GPT-4o-mini 裁判的标签选出 GPT-4o。与此同时,作者调整所比较的任务范围和各类任务的权重,几个系统的成功率都降低,名次却保持原序。Huang,第 V-C 节
两张榜单可以各自算对,也可以各自回答一个有价值的问题。分歧发生在哪里,取决于能否沿着同一道题追过去:模型看到什么,交了什么答案,谁判它正确,这道题在总分里占多大分量。下文选取选择题、跨任务汇总和智能体日志三种材料。它们分别让我们观察答题过程、汇总规则和标签来源,其中只有一部分变化可以用已经保存的答案重新检验。
选择题里的反转发生在交卷之前
Alzahrani 等人研究的 MMLU 是一套跨学科选择题。看论文表 2 的两行就够了:在不给示例的条件下,Yi-6b 和 Mistral-7b 的默认准确率分别为 61.12% 和 59.56%。研究者把每道题的正确选项都移到 C,两者的准确率变成 58.59% 和 63.84%。同一对模型,默认设置下前者领先,固定到 C 后后者领先。题目考的知识点可以原样保留,输入中的位置和答案字母却同时变了。这里有重新向模型出题的过程,不能靠修改成绩表复现这次干预。Alzahrani 等,表 2、第 3.1 节
为什么强调“同时”?设想模型偏好某个字母,即使正确内容它原本会选,也可能被换位后的标记吸引。另一种可能是它更常选序列中某一位置。把所有正确答案都放到 C,这两种解释会做出相似预测。作者另做了打乱符号与选项的实验,指出只把文字和标记一起搬动,仍难拆开位置偏好与符号偏好;图 6 的进一步探查又只覆盖三个学科。表 2 足以举出名次翻转的实例,要说其中某个模型“丢了知识”,还缺少独立测量。Alzahrani 等,第 5.2 节、图 5–6
这个例子也不能倒过来读成“改提示一定会换榜首”。同一论文把示例换成其他学科的例子,或调整指令结尾,看到的排序变化就小得多。固定所有正确答案的位置,适合放大某一种敏感性;自然试卷上的位置分布不必如此极端。若实际目标是在通常编排下答题,这项结果提醒我们报告编排方式。若实际目标是在多种编排下都能答对,那么换位后暴露的弱点本身就属于要测的能力。Alzahrani 等,第 5.4 节
分数已经固定,怎样汇总仍然是研究问题
把一张成绩单横过来看,每行代表一道任务或一个学科,每列代表一个模型。每格都填好后,研究者仍需决定怎样读这张表。每题同权,题多的学科影响大;先在学科内取平均,再让每个学科同权,小学科的影响就会增大。两种加权分别对应“从题库随机抽题”和“先随机选学科,再在其中抽题”。如果你想了解学生跨科应答的表现,题目的收集成本无意中造成的数量差异,就不该悄悄替你决定研究目标。
可以用一个假设情形辨认权重的作用:甲在文字题上领先,乙在图形题上领先。逐渐增加图形题的份额,乙可能反超。反过来,若甲在每一类都领先,且两边对各类使用同一组非负权重,加权平均就不能让乙反超。遇到后一种报告,值得回去检查是否各模型漏跑了不同的题、分母是否相同,以及算的是平均分还是按名次投票。这条推论只用到了加权平均的定义,不需要对甲、乙的内部机制作任何假设。
Gordienko 等人的预印本给出了另一种看成绩表的办法。研究者用真实榜单的任务分数作为起点,提出一个刻意有利于追赶者的假设:被选中的任务一律让目标模型得到满分。接着问,对每个目标模型,至少需要改变多少个任务,才有机会排到榜首?在 BIG-Bench Hard 的 24 项任务、4507 个模型条目上,这个最少任务数在模型间的中位数,用算术平均汇总时是 13,用平均胜率时是 22。平均胜率关注一个模型在各任务上胜过其他参评者的情况,两种规则给局部提分的回报不同。Gordienko 等,第 4–5 节
这里有两个容易混用的动作。前面的学科加权保持各格成绩;这篇论文为了测规则对局部提分的敏感性,主动改动部分格子,然后比较不同汇总规则。作者没有真的训练这些模型,更没有证明某个榜单上的参赛者见过测试题。一个规则较难被这种方式推到榜首,仍可能与读者关心的能力相距甚远。尤其当读者关心低频任务上的严重错误时,胜过多少个竞争者,并不能告诉他错误的代价。Gordienko 等,第 5–6 节
让两位裁判读同一份轨迹
回到开头的研究。智能体的一次“答卷”是一串操作,同一个基础模型也可能搭配不同工具、提示和重试策略。Huang 分析的 AgentRewardBench 记录包含四种配置和去重后的 1302 条轨迹。Llama 缺少 VisualWebArena 的观察。如果把空格填成失败,就会惩罚未参加的项目;若各自只对跑过的项目取平均,几个系统又在回答不同的试卷。作者选择共同覆盖的三个基准,让它们在汇总时同权。此时所有配置的分数都下降,而排序保持。这支持的是一个收窄后的比较,Llama 在缺失项目上会怎样仍是开放问题。Huang,第 V-C 节、图 3
同一节中的裁判替换更有辨别力。专家记录与自动判定可以配到同一份操作上,轨迹保持原状,排名仍可能随成功标签改变。这里可以追问每个分歧案例:动作完成了,但环境检查没有捕捉到吗?回答看起来完整,操作却没成功吗?前者会造成漏判,后者会造成误判。区分它们需要回看任务和轨迹,单凭裁判名称无法判定谁错。专家标签在这项研究中是比较标准;推广到新的环境,还要说明在那里怎样核实任务的真实结局。Huang,第 V-C 节
还有一种容易被标题吞掉的结果:两份报告都排出了先后,但资料尚不足以区分两个系统。Huang 在 SWE-bench 原始榜单前十名内部取出 45 对提交,按仓库等权比较,用两个百分点作为实际有意义的差距。在逐对的不确定性规则下,5 对稳定,1 对对目标敏感,39 对证据不足。这个判断限定在已选中的前十名和作者设定的门槛。证据不足的两项可能有差别;要宣称它们足够接近,还得让差距的合理范围整个落在预先定义的等效区间内。Huang,第 V-B 节、图 2
哪些变化可以放在一起解释?
| 研究中的操作 | 保留了什么 | 可以据此判断什么 |
|---|---|---|
| MMLU 移动正确选项 | 同一批题的知识内容与受测模型 | 比较方向对呈现协议敏感,无法单独定位知识变化 |
| BIG-Bench Hard 模拟局部满分 | 同一份起始成绩表与候选模型集合 | 汇总规则改变冲到榜首所需的任务数,未测真实训练成本 |
| AgentRewardBench 更换成功标签 | 已有轨迹 | 裁判选择可改变点估计的榜首,仍需核查标签误差 |
三项工作没有共同的模型起点、训练过程、数据划分或推理预算。第一项用当时的模型实际作答,第二项取榜单已有分数作反事实修改,第三项重读已发布的系统运行记录。城市知识题的准确率、模拟登顶的任务数、工具操作的成功率没有共同单位。论文间真正能对照的是干预的位置。先画清楚哪里发生变化,再判断哪几种解释仍与观察相容,这比把三个数字排成一列更能帮助下一次研究选对照组。
一项能区分解释的小实验
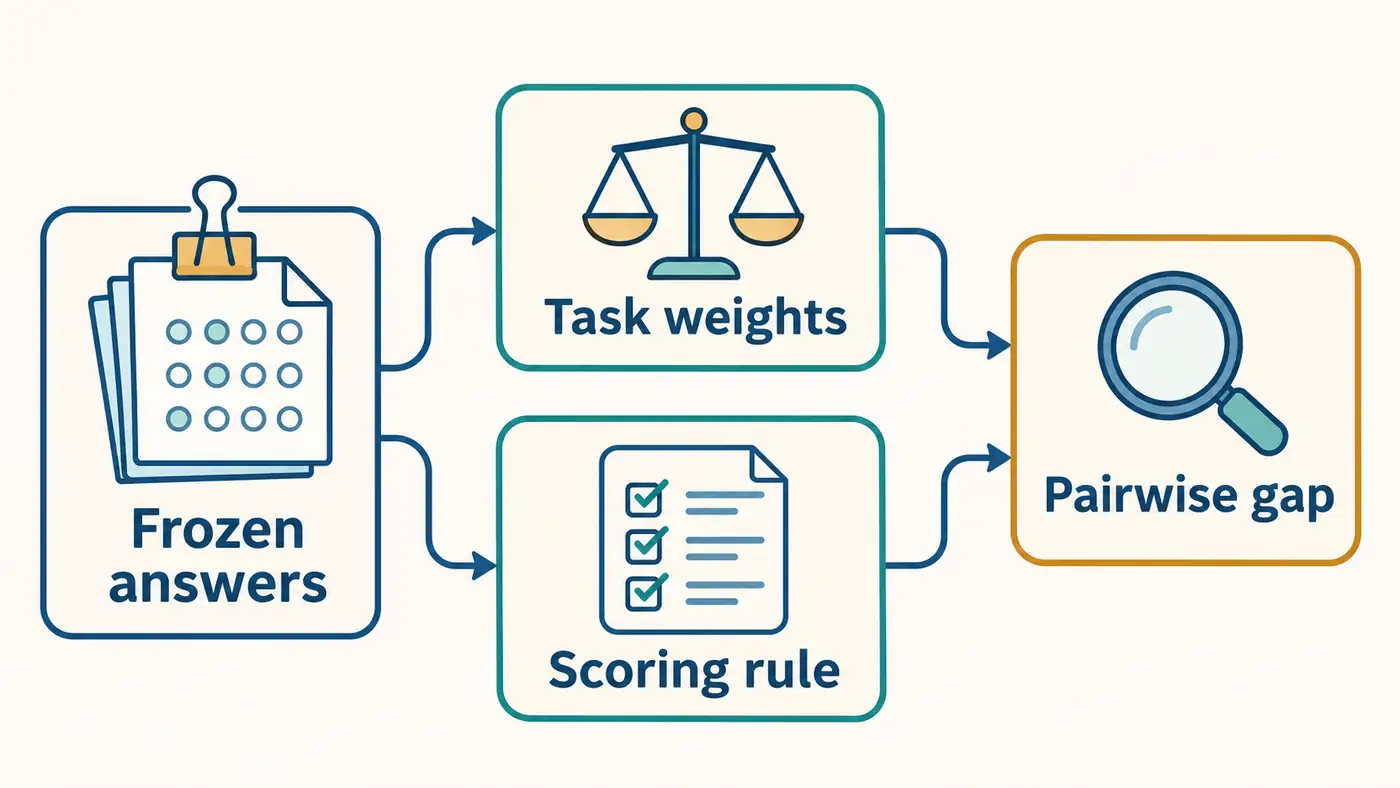
图中两条分支是建议的独立复算,箭头表示分析顺序。图中没有论文的测量结果。
先选一对有明确版本的公开模型,只研究一种能力,例如在多个学科里正确选择给定选项。用未参与规则选择的公开评测题,按学科保留题号、答案文本、选项顺序、原始输出和解析结果。两边使用相同的提示、示例数、生成上限和尝试次数。还要预先说明研究的是基础模型,还是含答案解析器的完整系统。若只拿得到完整系统的日志,结论就以系统为单位;一个解析器更能容忍额外说明,已经足以改变一部分“答错”的记录。
第一轮只操作已保存的答案。固定同一份逐题判分,让每题同权和每科同权各算一次,观察两模型的差距怎样随任务构成变化。再固定任务权重,对同一回答比较严格字母匹配与事先定义的答案抽取规则。对含多个冲突答案的输出应保留歧义,不要在看到榜首后替其中一个模型挑有利的解释。如果差距仅在重加权时翻转,可以逐科列出拉动总分的方向;如果仅在判分时翻转,可以直接展示哪些原始答案改变了标签。这两项诊断都无须再次调用模型。
第二轮才改变输入。按预先生成的置换移动各题选项,并同步移动正确答案标记,两边模型都重新作答。记录同一题、同一模型在换位前后是否仍选择同一段文字,同时检查顺序偏好与字母偏好。把这轮与重判旧答案分开,读者就能辨别“模型交了另一份答卷”和“裁判对旧答卷作出另一种判决”。要研究版本升级,再增加新旧检查点,在每个版本上完整交叉运行相同协议。否则,版本和出题方式一同更换,差异便无法归给其中任何一个。
最后把差距连同不确定范围一起交付。多个排列来自同一道题,抽样应以原题为单位,把两个模型的回答和对应排列一起保留;否则重复变体会显得像许多独立证据。事先写下多大的差距才值得区分,以及哪些任务分布属于研究目标。若在所有预定设置下差距都同向且超过门槛,便有理由报告该范围内的稳健领先;若不同目标下的差距可靠地反向,应分别命名目标。若区间仍同时容许两种有意义的方向,就把研究停在“暂不能决定”,并点明下一批独立题应从哪些学科补充。
总结
读榜单时,可以先补全一句话:“在这些题目、这套作答条件和这个判分规则下,甲相对乙领先多少?”只要原始答卷还在,权重和判分造成的差异就有机会逐题追查。若输入或模型版本也变了,就需要重新配对运行。两张榜单选出不同赢家并不稀奇;值得解释的是,哪一步足以让比较方向改变,以及换一个仍有意义的目标后,现有证据还能支持多强的结论。
参考资料
- Alzahrani 等(2024),When Benchmarks are Targets: Revealing the Sensitivity of Large Language Model Leaderboards,ACL 长文。
- Gordienko 等(2026),How Hard is it to Rig a Benchmark? A Social Choice Analysis of Leaderboard Robustness,arXiv v1 预印本。
- Huang(2026),What Does an LLM-Agent Leaderboard Rank Actually Compare?,DSAA 短文,本文依据 arXiv v1。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。