- 日期:2026-10-11
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-11;检索近12个月工作并保留经典对照。本文为文献深读,未运行模型训练或复现实验,不声称全面覆盖。
摘要:先问改善了谁
批改数学作业时,只检查最终答案,可能放过中途的错误;逐行检查,又需要更多时间和专业判断。把这一直觉搬到大模型,便得到一个诱人的结论:监督越细,推理越可靠。但实验里的“更好”可能只是从已有答案中挑得更准,也可能是验证器更会找错,或者生成模型本身变得更稳。这三种进步需要不同证据。
**本文的判断是:过程标签能够提供更明确的错误位置,但其收益取决于标签含义、使用方式和评测目标;结果标签也可能训练出有用的过程评分器。**真正值得比较的不是两个缩写谁获胜,而是新增的信息与计算究竟改善了哪个环节。下文用四项研究拆开这些问题,不把不同设置下的结果拼成阵营对抗。
“过程”至少有三个位置
首先是监督来源:标签只说明最终答案对错,还是说明某个中间步骤是否成立?过程奖励模型通常简称PRM,结果奖励模型简称ORM;不同论文对名称的用法并不完全相同,应以训练目标为准。
其次是评分位置:模型可以每一步都输出分数,但这些分数未必表示本步逻辑正确。若标签来自“从这里继续生成,最后能否答对”,它更接近未来成功潜力。结果监督的模型也可能读取完整解答,而不是只看到最后一个数字。Uesato等§2.4、Zhang等§3.1.1
最后是使用位置:把评分器用于候选重排,改变的是选出的回答;把它作为强化学习奖励,才会更新生成策略。“奖励模型训练得更好”与“用奖励训练后的模型更好”不是同一项实验。本文把实际生成解答的模型称为生成器,把检查候选的模型称为验证器。
Best-of-N指先生成多个候选,再选出评分最高的一条。它检验选择能力;错误定位则要求指出最早出错的位置,或判定整条解答无误。两者都有价值,却不能用同一个总分互相担保。
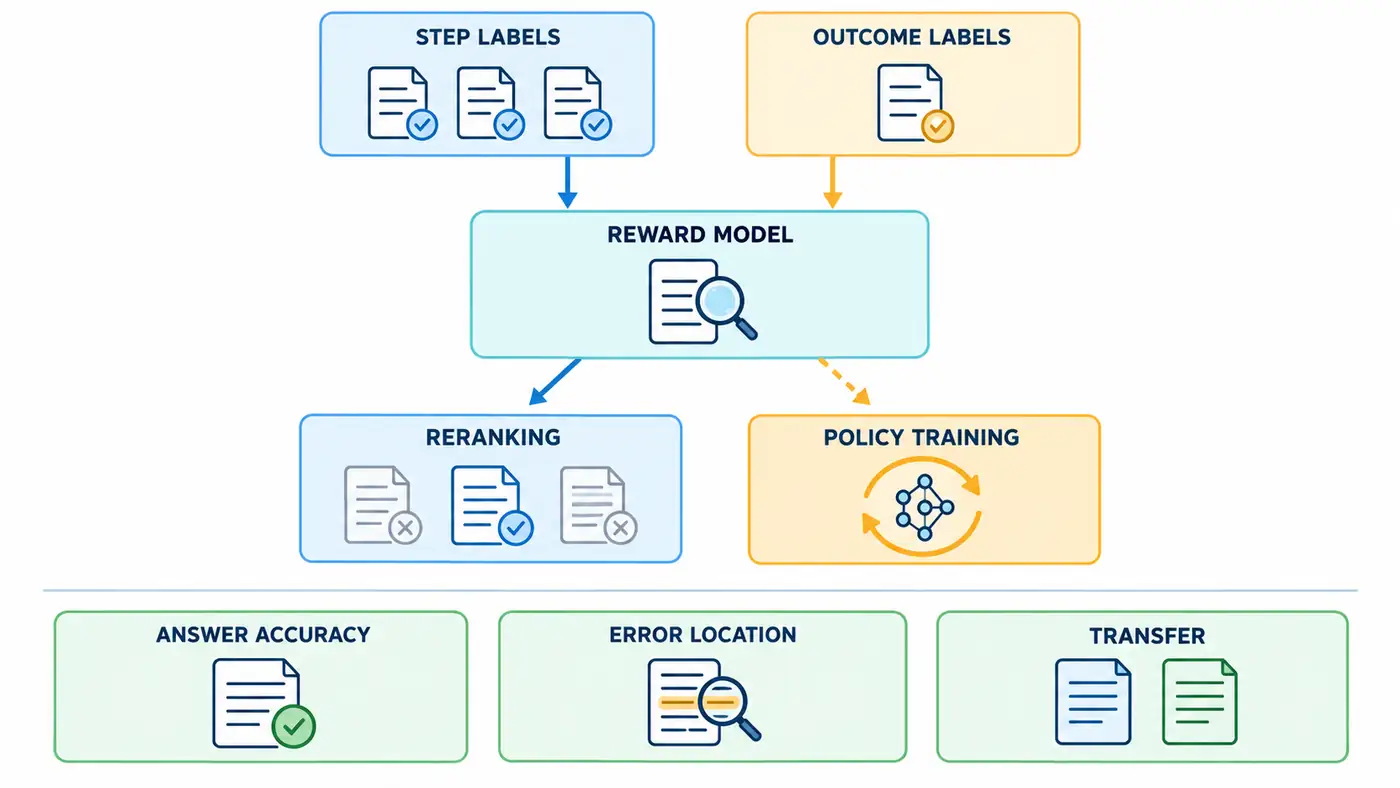
图中实线表示训练或使用路径,不表示必然产生收益;虚线提醒“更新生成策略”需要单独验证,并非已有重排结果的自然延伸。底部三项是独立评测问题,勾叉仅作图标,不是测量结果。封面的轨道检查装置同样是概念隐喻,不是论文实验设备。
经典优势成立,但先看实验动了哪里
Lightman等的《Let’s Verify Step by Step》在MATH数学题上比较过程监督与结果监督。其大规模实验从GPT-4起步,固定生成器,用不同验证器选择候选;论文明确说明没有用强化学习改善生成器。正式版图3报告,在每题1860个候选的条件下,PRM选出的答案正确率为78.2%,ORM为72.4%;评测采用保留的500道题。正式版§2.1、图3、附录C
这首先支持该条件下过程监督的验证器更会挑答案。它不能改写为模型单次生成正确率达到同一数值。论文也承认,大规模两组训练集并非严格可比;小规模实验另用大模型提供合成监督来做更直接的比较。原文§2、§3–4
因此,观察到优势与认定原因之间仍隔着一步:细粒度标签、样本选择和训练数据分布可能同时变化。对研究者而言,下一问应是“在相同问题与成本下还剩多少优势”,而不是从这一个结果推导出所有任务都该逐步打分。
Uesato等更早在GSM8K上比较了多种监督组合,既包含重排,也包含通过专家迭代更新生成器。专家迭代是先搜索较好样本,再用这些样本训练模型。论文报告,结果导向的方法可以获得相近的最终答案表现,而过程质量还需要另行检查;学习到的ORM也可能近似过程反馈。原文§2.6、§3及表1
这里的过程错误率尤其容易误读:分母是最终答案正确的解答,统计其中有错误步骤的比例,并非全部解答的错误率。它揭示“答对却推错”,不能直接代替整体正确性。作者还按最终答案测试错误率选择迭代检查点,因此这些结果不宜当成完全未参与选择的最终测试。原文§2.1、§2.6
两项研究没有构成干净的相反结论:小学应用题与更难的数学题不同,模型起点、标签规模、更新方式与解码协议也不同。后者的结果不能推翻前者;前者的局部优势也不能替后者回答生成训练问题。
每步都有标签,也可能监督错对象
Zhang等分析了过程奖励模型的数据构造和评测。常见的蒙特卡洛标注,就是从某个前缀多次续写,用最终成功情况估计分数;但续写失败可能来自后续能力不足,续写成功也可能经过纠错或侥幸命中。这使“这一步对不对”与“从这里还能不能做对”混在一起。原文§2.1、§3.1
论文同时检查候选筛选与错误定位,发现只看Best-of-N会掩盖过程缺陷:若候选本就包含答案正确但推导错误的解答,宽松验证器也能在答案指标上得分。作者因此采用续写估计与模型裁判对错误位置的一致性过滤,并同时评估两类能力。原文§3.1.3、§3.2
**本篇推断:**过滤后的提升仍不能单独证明某种标注方式天然优越。保留下来的题可能更容易达成一致,难以判定的错误则被排除。评价标签质量时,应同时看筛掉了什么;否则,干净的数据与更窄的覆盖范围可能被误认成同一种收益。
只给结果标签,也能学会找错吗?
2026年的LCA研究提供了一个有用的反例方向:主实验保留Math-Shepherd的推理文本与最终答案标签,丢弃逐步伪标签;通过聚合各前缀的预测来学习错误归属,并分别评估错误定位与候选重排。其报告的平均表现支持这条路线具有可行性,不等于每个子任务都领先。Jia等§4–5、表1–2
但“训练不用步骤标签”不能扩大成“研究全程不用过程信息”:超参数在ProcessBench的MATH子集上选择;聚合方法的另一组消融又把人工步骤标签汇总成轨迹标签。这两个实验的数据来源必须分开。原文§5.1、§5.3、附录C.5
其理论也依赖整体标签与局部错误关系等假设。答案对而过程错时,这种对应会失真;总体目标的性质也不保证有限样本训练必然收敛到理想解。原文§3.3、附录C.5与D.1
因此,近期证据收窄了问题:过程监督不必等于逐步人工标注,但要证明学到了可迁移的错误判断,仍需独立、可信的过程评测。“省去训练标签”是成本主张;“找到了真实错误”是能力主张,二者应分别验收。
比较前,把预算与分母放回桌面
| 研究 | 主要条件 | 可支持的观察 | 不能顺推的结论 |
|---|---|---|---|
| Lightman等 | 固定生成器、MATH候选筛选 | 过程监督验证器有选择优势 | 生成器已因RL变强 |
| Uesato等 | GSM8K、多种训练与重排组合 | 答案表现与条件过程错误可分离 | 两类监督在所有任务等效 |
| Zhang等 | 自动标注、重排及定位评测 | 标签目标和评测目标可能错位 | 高重排分就是可靠过程验证 |
| Jia等 | 结果标签训练、结构化聚合 | 可以学习有用的过程评分 | 全程无过程信息或全域领先 |
表中观察对应上述原文,不横向排名。GSM8K与MATH的题目难度不能当作已对齐的变量;只写“同为七十亿参数”也不能保证预训练、数学微调和监督历史一致。
对后续研究,本篇建议建立两种成本口径。等信息口径固定题目、轨迹和可见反馈,比较目标设计;等成本口径固定标注工时或总计算,允许各方法自行分配。前者利于研究机制,后者回答资源如何使用;二者不必选出同一个赢家。
人工逐步标签、模型裁判调用和续写采样都要计入成本。相同候选数量还不意味着相同推理预算:候选长度、验证器大小及评分次数都会改变开销。如果还要训练生成器,应另列训练预算,不能把测试时多采样的收益记到学习能力上。
三个能区分解释的后续实验
以下是本篇提出、尚未执行的设计,不是复现结果。它们分别针对“更会选择”“更会找错”“更会生成”三种解释。
**第一,冻结候选池,只更换验证器。**保存同题同批候选,比较多数投票、结果评分与过程评分,并对相同题目记录谁选对、谁选错。再独立核查被选解答的推导。如果答案收益存在而过程错误没有减少,就应把结论留在选择效果层面。候选池中根本没有正确解的题也要保留,以免把生成失败隐藏起来。
**第二,固定答案,干预中间过程。**构造语义正确的改写、确实错误的步骤,以及先错后纠正的轨迹;尽量匹配长度与表达。若评分主要追随末尾答案或文本风格,就不能解释成稳定的错误定位。真实语义标签需要有依据的标注和分歧处理,不能让被测模型自己充当金标准;这些标注本篇尚未采集。
**第三,冻结奖励后,再训练生成器。**从相同检查点开始,在相同训练预算下分别使用结果奖励、过程奖励和组合奖励。把独立的答案正确性、过程错误和跨生成器验证表现同时列出,最后换未参与选参的题型。若只有训练奖励上升而外部指标不变,应保留这个负结果,而不是继续调评测器直到出现优势。
这些设计都应预先约定开发集、最终测试集与停止规则。尤其要把“用过程标签选择超参数”记入信息预算,而不只检查梯度更新读过什么。这样才能判断较低的标注成本来自真实节省,还是被转移到了方法选择阶段。
总结:监督粒度不是结论粒度
当前证据支持过程信息对验证与选择有价值,也支持从较粗的结果反馈中学习部分过程判断。但收益不会沿着“步骤分数—选中答案—生成能力—泛化机制”自动传递。最有研究价值的报告,应说明改善发生在哪一层、比较消耗了什么信息,并留下能推翻自身解释的实验。读到“过程奖励更好”时,先补上对象、预算和指标,争议才成为一个可以检验的问题。
参考资料
- Hunter Lightman等,Let’s Verify Step by Step,2023预印本;ICLR 2024正式发表。arXiv v1;正式会议全文。本文数字按正式版核验。
- Jonathan Uesato等,Solving math word problems with process- and outcome-based feedback,2022。arXiv v1;全文。本次未确认正式录用,按预印本引用。
- Zhenru Zhang等,The Lessons of Developing Process Reward Models in Mathematical Reasoning,2025,Findings of ACL 2025。正式页面;正式全文;arXiv v2全文。
- Tianyu Jia等,The Weakest Link Tells It All: Outcome-Supervised Process Reward Modeling via Learnable Credit Assignment,2026。arXiv v2;全文。本篇采用2026-09-26版本;作者在arXiv注明已获EMNLP 2026 Oral录用,本次未独立取得正式会议录用页面,故不将该说明写成已核验的正式发表记录。