- 日期:2026-10-12
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-12。重点检索近12个月工作,并保留2025年的争议起点;本文为三篇一手研究的证据深读,未运行模型训练,不声称全面覆盖。
摘要:学习方法的名字,不能代替实验条件
给模型看标准解答,和让模型尝试后接收反馈,为什么会产生不同的迁移表现?“SFT记忆,RL泛化”给出了一个容易记住的回答,也容易让人忽略:两组模型是否看过同样丰富的解法,是否处在同一训练阶段,又是否接受了相同的测试。
本文的判断是:**强化学习在一些受控任务上表现出更强迁移,但现有证据不足以把泛化能力归属于某一种训练目标。数据选择、监督内容和优化程度改变后,SFT也能出现跨分布收益。**这并不意味着两种方法等价;它意味着需要把“观察到差距”和“解释差距来源”分开。Chu等,2025、Lu等,2026、Ren等,2026分别提供了任务对照、数据干预和训练动态三个切口。
“泛化”首先要说明换了什么
监督微调(SFT)让模型在给定问题和示范前缀时,提高示范中下一个词元的概率。强化学习(RL)则依据生成结果得到的奖励调整生成策略。这里主要讨论可核验任务中的RL,不把人类偏好优化的所有结论一并纳入。
直观地说,SFT像阅读做题过程,RL像交卷后得到反馈。但比喻不能替我们判决:教材可以包含多条解法,反馈也可能只让学生重复最熟悉的一条路径。“有探索”描述训练过程,不自动保证探索到了可迁移的方法。
分布内(ID)测试沿用训练任务的主要条件;分布外(OOD)测试改变其中某些条件。换卡牌规则、换图像风格、从数学题转到代码题,都是分布变化,却不是同一项能力。更何况,OOD通常只相对于本次后训练数据而言,不能据此断言预训练从未包含相似知识。
本文把“记忆训练规则”“保留原有能力”和“获得迁移收益”分开。换规则后成绩下降,只能先说明适应性受损;要进一步声称逐字记忆,需要近似复述等额外测量。反过来,迁移成绩高于训练前,也不足以定位内部究竟形成了什么算法。这是本文采用的证据标准,不是对模型内部状态的观测报告。
最早的强证据,也有明确的适用范围
Chu等在GeneralPoints算牌与V-IRL导航中改变规则或视觉输入。例如,训练时把J、Q、K都解释为10,测试时改为11、12、13,并在提示中告知新规则。模型要根据当前指令重新行动,而不是沿用训练映射。论文报告RL在这些OOD条件下改善,继续SFT则退化。原文§4、§5.1—5.2
这项对照并非简单地给RL更多训练:两支从共享的SFT初始化检查点出发,图6比较估算计算量相同的位置。主干是Llama-3.2-Vision-11B;RL允许利用验证器反馈逐轮修正,而正文SFT主要采用单轮专家示范。附录还测试了带错误和验证信息的SFT轨迹,局部结果依然不理想。图6、附录C.1—C.3
因此,不能用“完全没做公平比较”抹去观察,也不能把局部数据消融提升为“SFT本质上只能记忆”。计算量相近并不使反馈信息、轨迹分布和目标函数自动相同。论文还报告,RL无法恢复一个过度SFT检查点的OOD表现。§6 这对“只要加RL就能泛化”的说法构成边界。
差距也可能来自哪些样本真正推动了更新
Lu等考察视觉语言模型的分类与定位任务,按初始化模型多次作答的结果划分难度:全部正确为容易,全部错误为困难,有对有错为中等。这里的“困难”是相对于模型和采样协议的观测标签,不是题目永恒的属性。原文§4.1—4.2
其解释来自组相对策略优化(GRPO):同一问题的候选答案互相比较奖励;组内奖励相同时,相对优势为零,来自该项奖励的策略更新信号消失。这不等于整个训练没有更新,例如约束模型偏离程度的KL项仍可能贡献梯度。作者据此提出“隐式难度筛选”的解释,并用显式筛选的SFT检验它。§3—4
在论文的主要设置中,DC-SFT保留中等难度,或同时保留容易与中等难度数据,其平均OOD表现超过对照GRPO。研究采用Qwen2.5-VL的两种规模,先作共享格式初始化,再主要进行低秩微调;对照固定训练步数,SFT与GRPO的批量设置不同,不能直接称为等总算力实验。表2、§5.1—5.2
这个干预说明:至少一部分差距可以通过改变SFT接触的数据来改变。它尚未排除其他共同变化,也没有证明所有RL收益都由难度筛选造成。尤其是一次静态筛选与持续变化的在线采样并不相同;初期不会的题,可能在后期成为有效训练题。把论文读成“困难样本永远有害”,会把条件性发现变成新的口号。
一张训练曲线,也能改变“不会泛化”的判断
Ren等从未经指令微调的预训练检查点出发,用经过答案验证的长思维链(CoT)数学示范进行SFT。CoT指输出中展开的中间推理文本。论文在部分跨领域任务上观察到先下降、后恢复的轨迹:如果只看较早检查点,容易低估最终迁移表现。原文§2、§3.1,图3
这并不是“越训越好”。作者用更激进的学习率与训练安排观察到了后期退化,也发现数据质量和模型起点会影响恢复。该文后续GRPO对照匹配了起点、问题池、批量、响应上限及更新次数,但明确没有匹配总生成词元和总浮点运算量;其中SFT占优的结果不能建立普遍排名。§3.4、附录A及C.14
本文据此推断:研究者需要检查整个学习轨迹,而非只取一个训练时刻作算法归因。不过,“较晚表现恢复”也不直接证明模型学到了回溯或验证机制。论文的文本行为检测器只是可复查的行为代理,作者在局限中明确承认它不提供参数层面的机制解释。附录A
把三种解释放进同一个比较框架
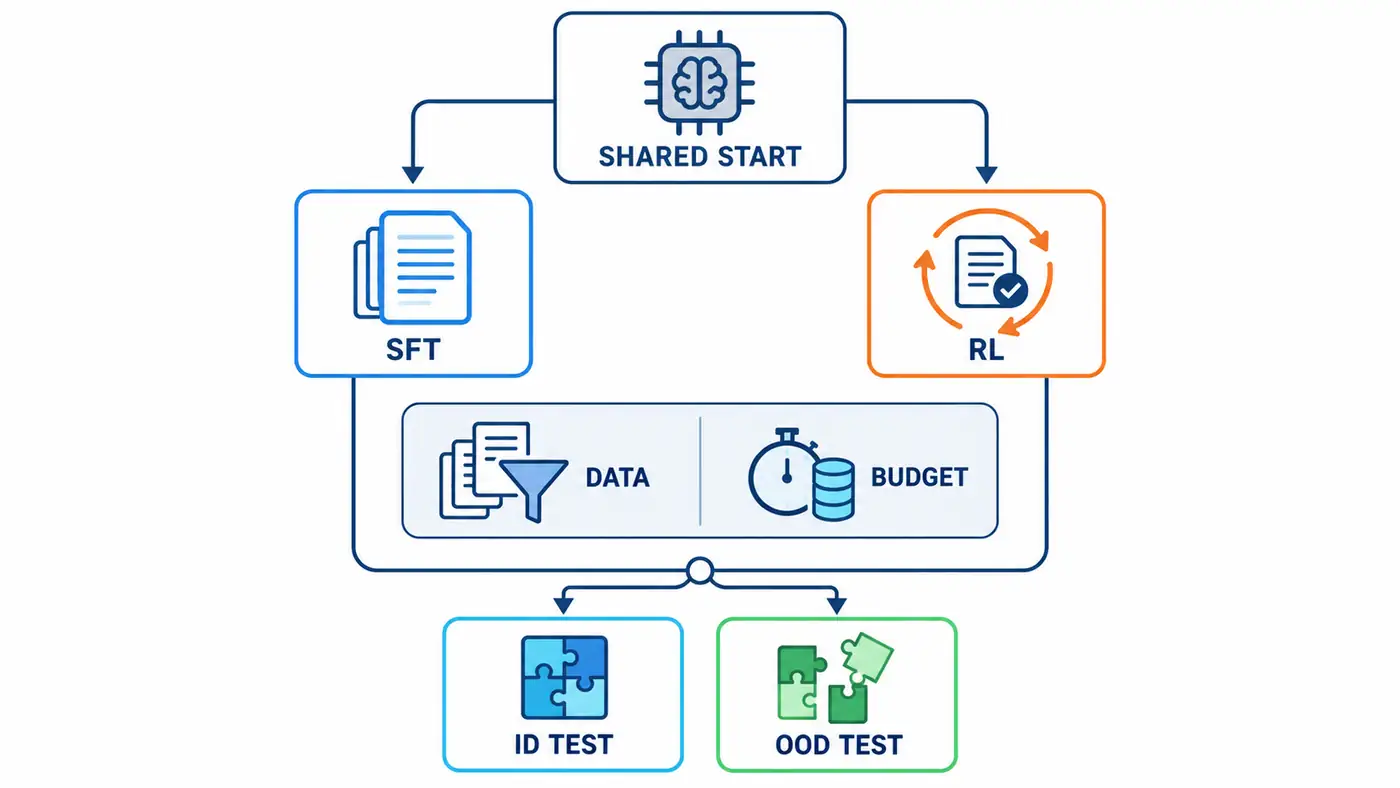
图:本文提出的比较协议。箭头表示共享起点后分别训练、分别接受同一套测试;下方汇合点表示协议共用,不表示模型融合。数据与预算是需要核对的条件。图中没有画出获胜方法或实测趋势;“探索、筛选、优化阶段”仍是需要区分的解释。
| 解释 | 可区分的观察 | 已有证据与边界 |
|---|---|---|
| 反馈探索更有利 | 同等数据覆盖与预算下,在线反馈仍有额外收益 | Chu等支持局部RL优势,但训练信号仍有差异 |
| 有效数据分布不同 | 保持SFT目标,改选样本后差距缩小 | Lu等提供干预证据,不能解释全部RL机制 |
| 比较了不同训练阶段 | 相同方法较晚检查点改变原有判断 | Ren等观察到恢复,也观察到激进训练下退化 |
这三种解释可以同时成立。它们分别关注“怎么获得经验”“哪些经验进入更新”“何时测量结果”,并不是三支互斥阵营。三篇论文的任务、模型、训练数据和评测指标均不同,因此本文只比较证据结构,不把它们的榜单数字拼成排名。
读表时还应区分预算的账本。相同问题数没有限制每题尝试次数;相同梯度步数没有限制每步处理多少词元;相同训练词元也未计入教师生成、困难度筛选和在线验证。对研究目标而言,可以分别报告“已有示范时的训练成本”和“从零构造数据的总成本”,但不能混用二者来宣布效率胜负。
这里没有一把能让所有变量同时相等的尺子。若研究“同样算力下谁更有效”,就允许两种方法用不同数量的经验,但要诚实结算计算成本;若研究“同样经验怎样被利用”,就尽量共享轨迹,再接受优化方式造成的成本差异。前者是资源配置问题,后者更接近学习机制问题。论文可以回答其中一个,却不应把一个答案包装成另一个。尤其不能先给SFT额外教师知识,再把提升全部归因于监督目标;也不能让RL反复访问验证器,却把信息来源记为零。
评测同样需要拆账。多次作答的平均正确率,和多次中至少成功一次的比例回答不同问题。Ren等的若干推理指标使用前者;Chu等的算牌成功则包含推理时验证机会。Ren等§2.2、附录B.4、Chu等附录C.3 同样写着“成功率”,也不能忽略解码与反馈协议。
一个能区分解释的后续实验
以下是实验建议,尚未执行。选一个能自动验算、能明确改变规则的任务,固定起点、训练问题池和独立开发集,并预先留出不参与调参的新规则测试集。先比较普通示范SFT、难度筛选SFT和在线RL,再增加一组SFT,使用RL实际生成并通过验证的轨迹。这一组可以检查:RL获得的部分收益能否被示范传递。
这仍不是一次就能解决的比较。RL轨迹的生成成本应记在供给这组SFT的数据账本中;若把已训练RL模型当教师,结论只能是“这些经验能否传递”,不能声称不需要RL。还应保留同等条数、近似长度的随机筛选组,以免把样本数减少或输出变短误认作难度筛选的作用。
预先固定若干预算节点,同时记录训练词元、在线生成词元、验证次数和时间;在开发集选检查点,最终测试只用于报告。除总正确率,还应分开统计格式失败、继续套用旧规则和执行新规则时的算错。这样才能知道分数变化来自哪里。所有方法使用同一解码协议,并报告多次独立训练的波动。
如果只改SFT数据就稳定缩小差距,会加强数据解释;若在覆盖与预算相近时在线RL仍额外获益,会加强反馈解释;若方法排名随检查点改变,则应优先报告训练动态。反之,某一操作没有奏效,也只能排除那一种实现下的解释,不能把一次负结果提升为算法不可能性。
总结:把方法标签还原成可检验的问题
现有研究允许我们说,RL有时比某种SFT配置更能适应变化;它们也明确提示,SFT的迁移表现会随数据和训练条件改变。对于科研新人,值得追问的不是替哪种方法站队,而是:这个差距经过哪些控制仍然存在,哪些解释已被削弱,哪些变量还纠缠在一起。
“记忆、探索、泛化”应当是等待测量的对象。只有把起点、经验、预算与测试分布交代清楚,论文标题里的强判断才能转化为可以积累、也可以被修正的研究结论。
参考资料
- Tianzhe Chu、Yuexiang Zhai、Jihan Yang等,SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training,2025。ICML 2025正式记录;方法与结果核验使用arXiv v2,2025-05-26。正式PDF本次未成功打开,不宣称逐字核对两个版本。
- Aojun Lu、Tao Feng、Hangjie Yuan、Wei Li、Yanan Sun,Why Does RL Generalize Better Than SFT? A Data-Centric Perspective on VLM Post-Training,2026。arXiv v1,2026-02-11全文。检索到CVPR 2026官方PDF记录,但本次直接打开失败;实验论断仅依据已读arXiv版本,不推定终稿完全一致。
- Qihan Ren、Peng Wang、Ruikun Cai等,Rethinking Generalization in Reasoning SFT: A Conditional Analysis on Optimization, Data, and Model Capability,2026。arXiv v2,2026-08-15全文;版本与状态。作者在arXiv及官方代码库声明获COLM 2026接收;本次未取得独立会议正式条目,按作者声明注明,不混同已检索到的FoGen非归档工作坊版本。