大模型研究争议:从论文结论到证据边界
摘要
一篇由智能体写出的论文收到了足以过审的分数,另一个系统在数学家研究已久的问题上找到了更大的点集。哪一件事更能说明机器参与了发现?前一件事覆盖的研究环节更多,后一件事留下的证据却更容易独立检查。两者之间还有一个有意思的测试:把一篇已发表论文的结论藏起来,只给智能体研究问题,看它能不能凭实验把结论找回来。读这三项工作,先问交到读者手里的究竟是什么,再问谁有能力把它推翻。工作坊实验、重发现基准、点集构造
一篇过审稿,分母从哪里算起?
Lu 等人做了一次真实的投稿实验。他们把 ICLR 工作坊的宽泛主题交给系统,请它提出想法、写代码、做实验并成文。研究者在各阶段筛选候选,看想法是否切题、代码能否正确实现想法并运行、稿件格式是否合格。作者报告,入选稿从构思到写作的内容没有经过人工修改。这里的两个动词值得分开读:改写会改变留下的内容,筛选会改变哪些内容能走到下一步。一次研究可以没有人工改写,同时相当依赖人工筛选。Lu 等,Human evaluation results
最终有三篇送审。评审知道投稿中有机器生成的作品,但不知道具体是哪几篇。其中一篇报告了组合正则化尝试的负结果,收到了两份弱接收和一份接收意见。组织者认为它很可能获接收,研究团队随后依照预定方案撤稿。正式发表在《自然》的是团队研究这套系统的论文。把两层稿件的作者和去向理清,才能看见这次实验最有意思的结果:一项没有得到预期改善的工作,也可以被同行认为值得讨论。Lu 等,图 2 与 Limitations
如果要问“再启动一次,产出同样质量稿件的机会多大”,就不能拿三篇当作所有尝试。早期淘汰的想法也耗费资源,负责排除错误实现的人还提供了判断。作者认为不做筛选也会生成选中的稿件,只是还会生成更多稿件、花费更高。这个解释可以成立,但没有给出同预算下取消筛选的成对结果。过审记录支持一条实际走通的路径,无法单独估计无人筛选时的产出率。想把结论推进一步,需要看被丢弃的分支,以及同一笔预算原本还可以用来做什么。Lu 等,Human evaluation results
把结论藏起来,智能体能重新找到它吗?
Wang 等人的 FIRE-Bench 换了交付物。出题人先找到一篇有明确实验发现的论文,再给智能体一个较高层的研究问题,隐藏原来的实验设计、实现细节和分析路径。这样既留下了选择方法的余地,也有一份可用于比对的参考结论。这里的“重发现”有明确的参照范围:对做题者来说需要自行寻找,对研究共同体来说已有文献记录。仅凭命中参考结论,无法把成果登记为首次发现。Wang 等,会议版与作者稿图 1 后的任务定义 方法全文
评分也值得细读。评测器把报告与参考文本拆成可以分别判断的主张,再用语言模型判断它们在语义上是否相符。精确率关心报告写出的主张有多少得到参考支持,召回率关心参考中的主张有多少被报告找回,F1 将两者合在一起。会议版报告,受测系统中表现最好的平均 F1 仍低于 50(百分制)。把它读成“不到一半实验做成功”会换掉计数单位。一份报告完全可能做完实验、说对变化方向,同时漏掉现象出现的条件。Wang 等,会议版摘要 作者稿 Claim matching and scoring
反过来想,假如一份报告发现了参考论文从未讨论的例外,现有分数会怎样处理?按作者稿的匹配规则,没有参考主张支持的输出会计入假阳性。这个约定便于比较谁更好地找回了已知现象。至于例外究竟来自新观察、实验错误还是写作者的猜测,要回到运行记录,设计能让三者给出不同预测的实验。用另一个裁判重新阅读同一段话,可以减少措辞理解上的分歧,却无法补上缺失的观测。Wang 等,Claim matching and scoring;例外情形为本文设想
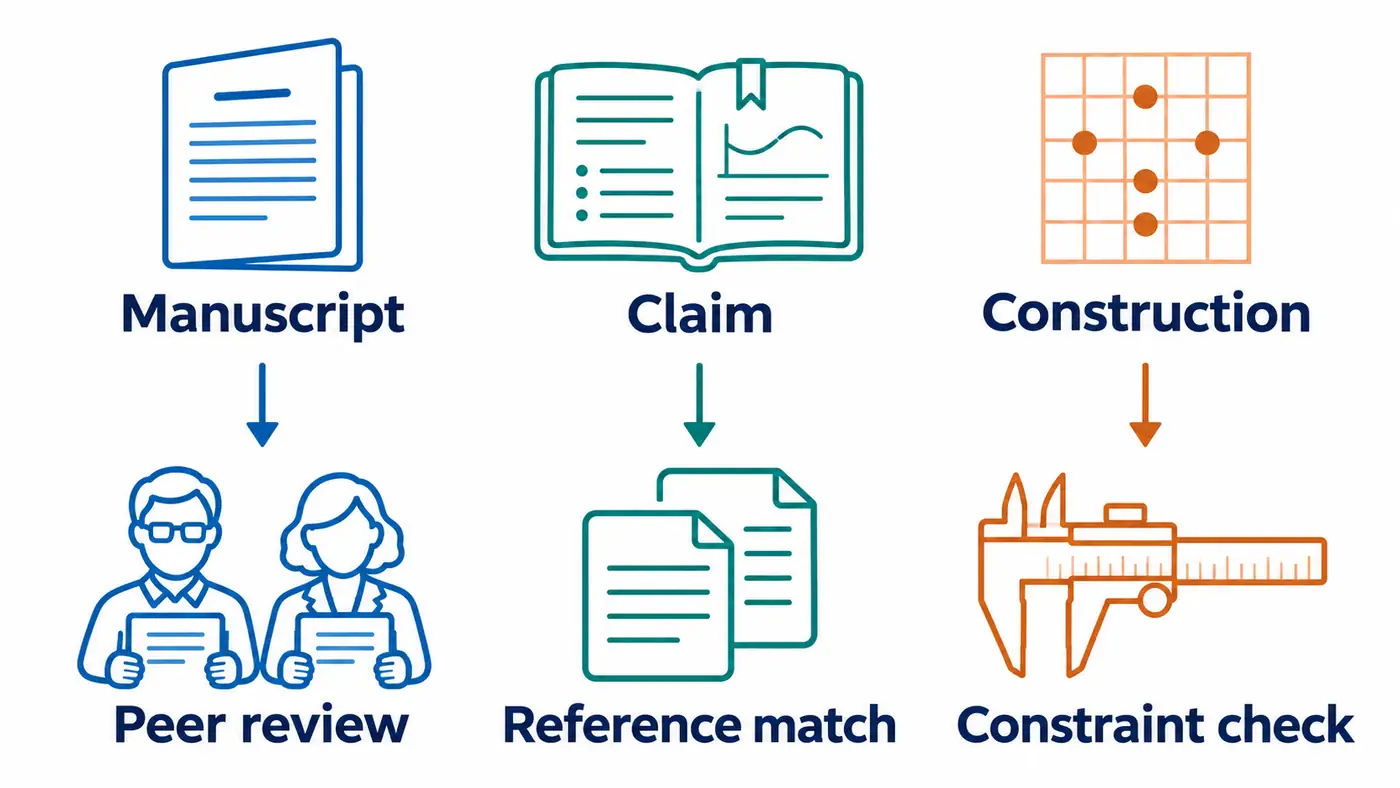
图中箭头表示检查对象与检查方式的配对。论文记录了相应评审、匹配或构造结果;独立重做经验实验能否得到相同结论,仍需另行检验。
一个点集,为什么比一句“有新意”更容易核查?
FunSearch 研究中的帽集问题有一条简短的规则。可以把每个点写成一串坐标,每一位只取零、一或二,加法按模三计算。目标是挑出尽可能多的点,又不让任何三个不同的点处在同一条有限几何直线上。这个定义给读者留出了复核入口:拿到点的清单后,对每一对不同点都能求出直线上剩下的第三点,再看它是否也在清单里。检查者可以另写程序,完全不必知道生成者走过哪条搜索路径。Romera-Paredes 等,图 3、图 4
研究者预先规定如何构造合法集合,语言模型参与搜索一个给候选点排先后的优先级函数。每次选择都可能排除后续候选,所以即使每步都合法,最终留下多少点也取决于顺序。作者在八维问题上找到了包含 512 个点的构造,图中列出的此前最好构造为 496 个点。这个结果有清楚的数学含义:该维度下至少能放下这么多点。若要声称它已经最大,还要排除所有更大的合法集合,那需要另一种证明。Romera-Paredes 等,图 4a–b
再看同一图的后两栏。模型搜索留下的是能生成点集的优先级函数,研究者随后检查向量的排列和坐标规律,手工整理出更直接的构造。一个解决了“怎样找到它”,另一个让同行更容易看清“它由哪些部分组成”。把后者全算作模型自己的解释,会抹掉论文里可追踪的人类贡献。反过来,因为问题和检查规则由人提供,就把新增的点集也说成单纯的文书自动化,同样解释不了旧下界为什么被推高。Romera-Paredes 等,图 4b–c、附录 E.2
偶然找到和稳定找到,也可以同时研究。作者稿附图 A.3 报告,在这个八维任务的 140 次实验中,有 4 次找到 512 点构造。对存在性命题,有一个合法例子就足够;对准备投入相同资源的下一个研究者,其他尝试同样重要。前者关心见证对象是否合法,后者关心搜索过程在给定条件下的回报。罕见成功可以产生可靠的数学知识,而一次可靠的数学发现对日常产出的稳定性仍然只提供有限信息。Romera-Paredes 等,作者稿附图 A.3
哪些差异值得放在一起比较?
三项工作的起点各不相同。一项从工作坊主题出发,允许产生许多想法;一项从已发表工作的研究问题出发,把路径留给智能体;还有一项连合法性的规则都已固定。它们没有共享同一个基础模型,也没有对齐训练资料、推理预算、筛选人时或测试划分。工作坊稿件面对的是审稿人,重发现任务有预先选定的参考发现,数学构造则在固定维度接受约束检查。把过审篇数、主张分数和点集大小排在同一条成绩轴上,会丢掉各自最值得保留的信息。工作坊协议 基准定义 构造任务
一个更有用的比较,是问每项结果还容许什么解释。稿件可能确实提出了有价值的经验观察,也可能因为把已知做法的局限讲得清楚而值得交流。重发现得分可能来自设计了合适对照,也可能含有模型从以往阅读中记住的知识;题面没有给出答案,不能保证模型训练时从未见过相关材料。数学例子收紧了这种不确定性,因为一个超出论文所列旧记录的合法构造自身就有信息量。不过,给出怎样的程序框架才容易找到它,以及在相同资源下其他搜索方法表现如何,仍是独立的问题。
一个可以实际区分解释的后续实验
可以从一个小型、可公开重跑的排序问题开始。假设研究组关心“输入中出现大量重复键时,哪种排序策略会失去原有优势”。先界定优势指运行时间还是比较次数,把实现、硬件和输入生成规则固定。将一种此前公开描述过的性能现象作为重发现任务,再预留一批新生成、对参与者不可见的输入,用于检查额外预测。这里的排序例子是一项研究设计,尚无实验结果。
给各组同样的起始模型、工具和时间。一组只读题面与公开资料后写预测,一组允许执行代码并据此修改假设,第三组在同样的执行预算下允许研究者筛选分支。每次筛选须保留入选与被淘汰的候选,记录人用了多少时间、是否看过性能结果。只读组也保留足够的推理时间,否则“能做实验”的收益可能混入总资源差异。各组提交同样简短的产物:预期在哪些输入上发生变化、方向如何、哪种结果会推翻自己的解释。
在这个例子里,“重复键越多,算法越慢”还不够具体。同样比例的重复键可以挤在一段,也可以散布在整个输入中。如果报告把耗时增加归因于比较次数,就应当预告,改变重复键的位置之后,比较次数与耗时是否还会一起变化。若两者分开变化,即使时间趋势猜对了,关于原因的那半句也应单独记为未获支持。这样评估者才有机会区分碰巧猜对方向和找到了可检验的解释。
锁定预测之后,再由另一位执行者用独立实现重跑,并打乱报告的来源标记。若允许实验的一组只在参考结论匹配上领先,新增预测在保留输入上没有优势,结果主要支持更好的重发现。若执行组能预告一个在独立实现中仍存在的边界条件,并且检索不到此前已报告的相同条件,就值得把它列为候选新发现,公开输入供同行寻找反例。若优势集中在有人筛选的一组,则要连同人时和筛选依据一起报告。到预定预算就停止,把无预测、方向错误和实现失败都计入,才能避免只展示最幸运的轨迹。
总结
读到“智能体完成了发现”,可以先索取一个具体对象:一篇稿件、一条带实验条件的预测,或者一份可以逐项检查的构造。接着问两件事:相对于哪份旧知识,这个对象增加了什么?换一个没有参与筛选的人,他能凭什么重新得到或推翻它?工作坊评审、已知结论匹配与有限集合检查各回答了一部分。把主张写到证据刚好能到达的位置,也就能把应当归给系统、研究者和后续验证者的贡献说清楚。
参考资料
- Chris Lu 等,2026,Towards end-to-end automation of AI research,Nature 正式论文。
- Zhen Wang 等,2026,FIRE-Bench: Evaluating AI Agents on the Rediscovery of Scientific Insights,ICML 正式论文。文中方法定位另见作者早期全文。
- Bernardino Romera-Paredes 等,2023 年在线、2024 年卷期,Mathematical discoveries from program search with large language models,Nature,引用位置对应作者接收稿。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。