- 日期:2026-10-25
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-25;检索近12个月工作,并保留争议所需的早期研究。本文为证据深读,未执行模型实验,不声称全面覆盖。
摘要:团队赢了,谁贡献了增益?
让几个模型先回答、再讨论、最后投票,分数超过一次作答,听起来很像集体智慧。但这个比较同时增加了尝试次数、可读文本和选择答案的机会。即使成员从未交流,只把独立答案汇总,也可能得到收益。
本文对照四项研究,追问三个可区分的问题:**多采几次是否足够,交换理由是否进一步有效,明确分工是否减少重复工作?**现有证据支持把独立采样视为强基线,也保留某些交流与汇总配置更有效的可能;尚不能把所有团队收益都解释为分工,更不能把某个基准上的无收益推广为协作无用。研究起点见Choi等、效率对照见Wunderlich等。
把“多智能体”拆成三个动作
这里的智能体可以是同一模型的不同会话,并不必然拥有不同权重或知识。自一致性是独立生成多条解答,再按最终答案投票;多智能体辩论让成员读取同伴输出并修订;分工则把问题分成互补子任务,最后合成结果。三者可能组合,却不是同一变量。
可以用一个假设场景理解差异:几位助手都检查同一段论证,再投票,这是重复尝试;交换各自发现的反例,是信息交流;分别核对定义、推导和适用条件,才接近任务分工。这个例子不是本次实验,也不保证最后一种最好。若定义核错了,后续推导与条件核查还可能共同建立在错误前提上。
“专业身份”也不等于专业能力。给同一个模型贴上数学家、审稿人、工程师的标签,只证明提示不同;若要声称形成互补专长,还需观察他们在不同子任务上的稳定优势。相反,没有角色名称的模型也可能通过工具或不同证据获得互补信息。
因此,本篇把成功轨迹当作需要解释的观察,而不是机制的直接证明。最终答案正确,不能告诉我们成员是在纠错、追随多数,还是汇总器恰好选中了原来就存在的正确候选。
四项研究,各自比较了什么?
投票已经拿走了多少收益?
Choi等的NeurIPS 2025论文把初始答案投票与后续辩论分开。主比较固定五个成员,在同一批题上评估Qwen2.5-7B-Instruct与Llama3.1-8B-Instruct;辩论并未稳定超过初始投票。**这里固定的是成员数,并没有把省下的辩论预算重新分给投票组。**它能显示初始集成很强,却不是全部成本配置的最优性证明。§2–3、表1
论文还建立了理想化信念更新模型。其定理要求邻居的平均正确答案信念等于当前成员的信念,才得到下一轮期望不变。不能把这一有前提的结果改写成“任何真实语言模型讨论都不可能增益”。真实交流能否引入可验证的新理由,是另一个经验问题。§4、定理2
配置选得合适,交流仍可能有价值
Wunderlich等在ACL 2026学生研究工作坊论文中,对采样、反思、辩论及分层汇总比较准确率与成本。分层汇总称为MoA:多份提议逐层合成,最后输出答案;它并不自动等同于专业分工。主实验使用Llama 3.1 70B和一千道抽样题,在所测MMLU-Pro配置中,采样、辩论、MoA的最高准确率分别为68.7%、70.0%、71.4%。§3–4.1、图2
关键限定是:这些点处于可比的估算预算,不是逐题耗时完全相同。成本模型计入浮点运算与显存搬运,使用特定量化、批处理和硬件假设;它不是实测端到端延迟。论文也承认抽样不确定性。因此,结果为部分配置提供支持,不能据此保证每个差值显著,或保证换模型、硬件后排序不变。附录B、Limitations
生成次数相同,也不代表账单相同
Ferreira等2026年9月的预印本,让三名成员各运行三轮,并用九次独立采样对照。在其小型开放权重模型池和所测离散任务上,辩论没有表现出稳定的额外优势。正文所说的匹配首先是生成次数匹配;读取同伴文本仍带来额外输入成本。稿件标注投稿ICLR 2027,本次未核实录用。§3.2、§5.1、表1
一个值得学习的纠偏是:部分长推理模型的讨论记录挤满服务上下文,导致末轮空输出。扩大窗口并重跑受影响配置后,原先部分劣势接近消失。这说明失败可能来自实现容量。其极端角色提示也不等于任务专长训练,不能用该结果否定所有分工方式。§5.5、§7
能答题,不等于能共同执行
Kim等正式发表于Nature Machine Intelligence的研究,把比较扩展到需要工具反馈的任务。在六个基准、五类架构的配置中,金融分析与顺序规划呈现不同方向的协作效果。正式版说明匹配的是系统级推理token预算上限和工具访问,迭代次数主要是终止上限;实际消耗仍可能不同。Main results、Methods
作者以可拆分程度解释部分差异,但跨基准比较也同时改变了环境和评分方式;本篇不把它当作对“分工机制”的单变量识别。论文还明确限制跨领域绝对成绩预测,部分验证子集仅二十题。它提供了任务依赖的证据,没有给出普适协作门槛。Robustness and sensitivity analysis、Discussion
| 研究切口 | 控制或成本口径 | 主要观察 | 不能直接推出 |
|---|---|---|---|
| 初始投票与辩论 | 固定成员数 | 初始集成是强基线 | 讨论永远无效 |
| 配置效率比较 | 估算计算与搬运时间 | 部分汇总配置占优 | 专业分工已被识别 |
| 辩论与重复采样 | 固定生成次数 | 交流优势不稳定 | 总token、延迟相同 |
| 工具交互架构 | 系统预算上限 | 任务间效果不同 | 新领域的统一规律 |
表中各行对应上述论文;任务、模型起点、抽样与计分不同,不做跨论文分数排名。第一项是NeurIPS正式论文,第二项是ACL学生研究工作坊论文,第三项仍是预印本,第四项采用正式期刊版本。
争议真正落在“预算”和“信息”上
这些研究不构成简单的正反阵营。固定成员数,问的是现有团队讨论后怎样;固定生成次数,问的是调用机会如何分配;固定系统预算上限,问的是资源受限时什么架构有效;比较效率前沿,则是在已试配置中寻找准确率与成本的折中。问题不同,结论可以同时成立。
效率前沿可以直观理解为:在已测试的方案里,没有另一个方案同时更便宜且更准。但它依赖搜索过哪些配置。若只细调团队、却只给单体一次尝试,前沿会偏向团队;若只测试一种笨重讨论协议,也不能代表全部交流机制。配置选择本身应使用开发集,随后冻结方案,在独立测试集上比较。
成本至少应区分生成与读取。多个成员每次都重新读完整历史,即使最终输出同样短,也可能消耗更多资源。并行执行可以缩短等待时间,却未必减少总计算;同样的token数量跨不同模型也未必对应同样成本。研究者应先说明自己限制的是调用次数、总算力、延迟还是花费,避免结论在这些含义之间滑动。
信息同样需要记账。如果团队多拿了数据库、额外检索结果或更强裁判,它赢的是一个包含这些资源的系统。要问“通信本身是否有效”,必须让对照有机会获得同样的证据。要问“分工是否有效”,则要进一步控制证据总量,只改变谁先看什么、如何分配任务与合成答案。
一个能区分解释的后续实验
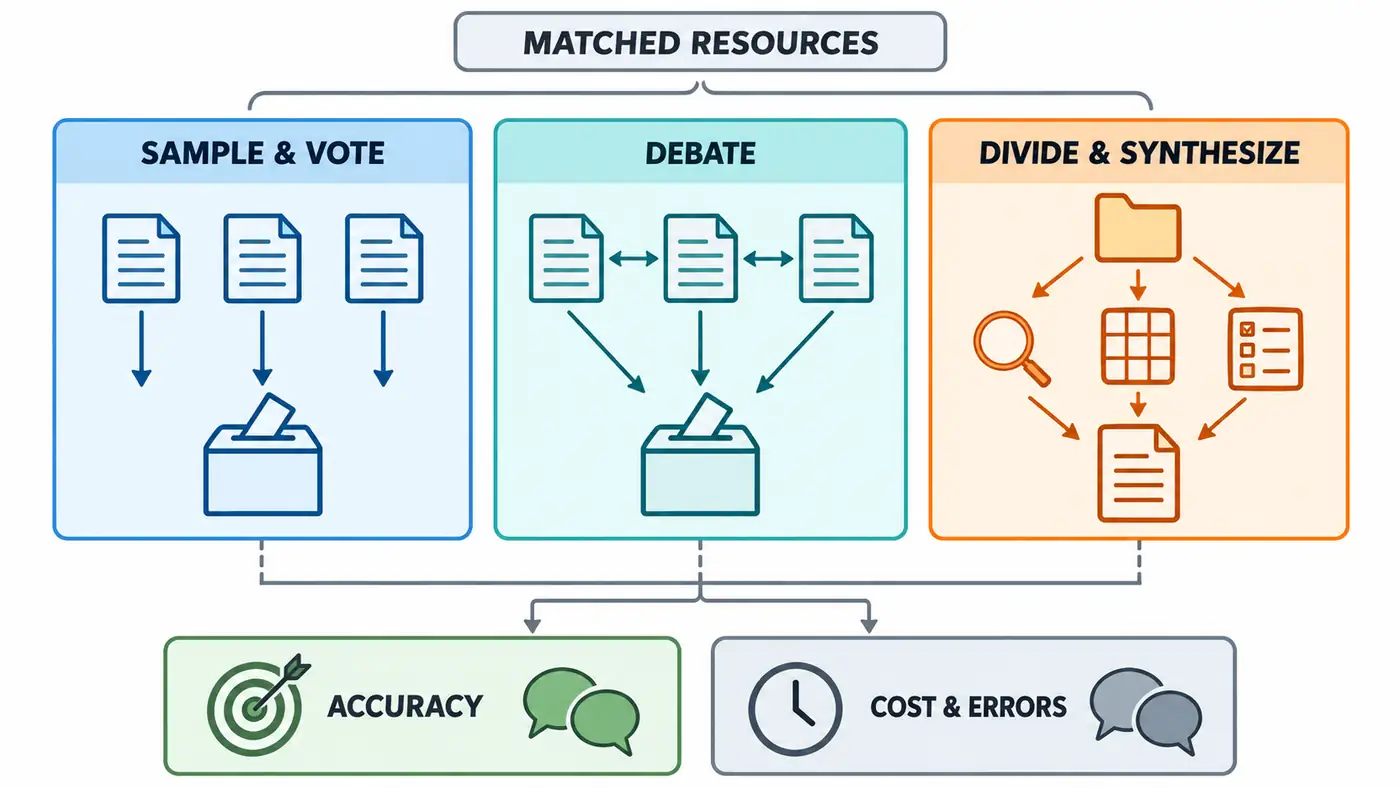
图示为本篇提出的比较框架,未执行。实线表示预设信息流,虚线连接共同观测指标;三条路线不是已经证实的因果机制,也不暗示哪条获胜。顶部资源匹配须落实为明确预算规则,并额外保留单体基线。
可以从一类答案可核验、又能拆成子问题的任务开始,先固定模型检查点、题目划分、证据池、工具权限、解码和评分器。保存一组初始候选,再构造三条路线:独立采样后投票;读取相同候选后互相修订;按预先定义的互补子任务处理后合成。另给单体相同的总资源,让它自行规划、检验与修订。
这里最好分开做两种实验。机制实验复用同一批初始候选,研究交流究竟改了什么;效率实验允许各方案在同一总预算内自主分配采样与交流。前者更便于归因,但不代表最优配置;后者更贴近资源取舍,却不能仅靠总分定位机制。把两者混成一张榜单,会重新引入最初的问题。
接着做针对性干预。对辩论组,比较真实理由、只显示答案、以及长度相近但与当前题不相关的理由。若只有真实理由产生额外纠错,才更支持内容交换有贡献;若只显示多数答案也一样有效,应考虑答案聚合或从众的解释。无关理由可能制造额外干扰,因此仍要保留完全无通信的对照,不能只比较“真实”和“乱序”。
对分工组,保持证据并集不变,比较按子任务分配、随机分配以及每人看全部证据。还应让单体执行同一份分解方案:否则团队优势可能来自更好的任务说明,而非多主体协作。删去角色名称但保留实际分工,也能检查名字与工作内容各自的影响。这里的分配规则都应在看测试答案之前确定。
除最终正确率,还需保留逐题轨迹:初始候选有没有正确答案,哪些错误被修正,哪些正确答案被改坏,成员是否重复查同一证据,合成时是否丢失关键约束。答案一致率只能衡量共识,不能替代正确性。把纠正与破坏分别统计,才不会让平均提升掩盖特定类型的伤害。
最后预先规定资源耗尽、工具失败、空答案和上下文溢出的处理方式,按题做配对比较,跨随机种子检查稳定性。若选择配置时已经看过某批题,就不再把它当独立验证集。这些都是未来实验设计;本文没有运行这些路线,也没有产生新的准确率。
总结:从“人多”走向可反驳的解释
判断多智能体的研究价值,不必先相信团队优越,也不必先否定协作。更有用的顺序是:先证明收益超过独立采样,再检查真实信息交换是否贡献纠错,最后验证任务分配是否在相同证据与资源下减少重复、保留约束。
目前更稳妥的结论是,采样、通信、汇总和分工需要分别举证。一个系统确实更准,可以是有价值的结果;只有让竞争解释接受同样严格的对照,才能进一步回答它为什么更准、收益何时会消失。
参考资料
- Hyeong Kyu Choi、Xiaojin Zhu、Sharon Li(2025),Debate or Vote: Which Yields Better Decisions in Multi-Agent Large Language Models?。NeurIPS 2025正式版。
- Florian Valentin Wunderlich、Lars Benedikt Kaesberg、Jan Philip Wahle、Terry Ruas、Bela Gipp(2026),Multi-Agent Reasoning Improves Compute Efficiency: Pareto-Optimal Test-Time Scaling。ACL 2026 Student Research Workshop;正式全文。
- Leonardo Ferreira、Gardenia Liu、Kaden Zheng(2026),Beyond Symmetric Agents: Cognitive Diversity and Multi-Agent Debate in Small Language Models。arXiv v1,2026-09-26;投稿状态不等于录用。
- Yubin Kim等(2026),Capable language models can outgrow the benefits of collaboration。Nature Machine Intelligence 8,1157–1172;早期预印本题为Towards a Science of Scaling Agent Systems。作者代码维护记录说明分析脚本已修正默认配置集合;本文未运行其代码,也不将已发表数值冒称为本次复现。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了两款让日常更有条理的小工具,欢迎了解:
- 日常收支小记:记录日常收支,安排预算与储蓄目标,让每一笔钱的去向更清楚。在 App Store 了解。
- 一事微光:按当下的时间和精力选择小行动,记录完成后的感受与发现,给日常复盘留下一点线索。在 App Store 了解。
更多技术文章与个人作品,欢迎访问我的网站:zffjzz.top。也欢迎分享使用感受,帮助这些小工具慢慢改进。