大模型研究争议:从论文结论到证据边界
摘要
组会上有人说,微调后的模型终于做对了一道老题。坐在旁边的人想看它以前的十份答卷,另一个人想把题干中的关键事实改掉,还有人想把新旧答案匿名交给同一个裁判。三个人都在追问这次进步是否可信,却可能各自得到一个正确、彼此又不能替代的答案。
这也是回看本系列时最值得保留的分歧。**题目有没有被解出、答案有没有用到指定证据、评判者有没有认出好答案,是三个可以分别出错的环节。**下面依据四篇一手研究,给每个环节选一个能用小规模对照回答的问题。实验方案都是提议,文中标明出处的观察来自论文。
把前面的争议放回同一张桌上
回看推理、蒸馏和多智能体几篇,最容易遗漏的是失败的尝试。读者看到的是被选中的漂亮解法,系统可能另外生成了许多答非所问的候选。过程监督和自我反思又多了一层选择:中间有人指出哪一步错了,重新作答的人就比第一次多知道一件事。若只能保存一种原始材料,我会留下同一道题的全部尝试,包括最后没被选中的回答。它们能让后来的人区分生成和挑选各贡献了什么。
知识冲突、长期记忆和视觉依据几篇遇到另一种困难。输入材料与常识恰好一致时,照着材料答和凭记忆猜会得到同一个词。工具调用成功也留下类似疑问,熟悉的接口名与实际功能一直配对,很难看出模型依赖哪一个。值得留下的是一对题面:保留问题和操作要求,只替换决定正确答案的那条证据。读者可以指出两份作答理应从哪里开始分开。
再看仿真迁移、形式化证明、榜单反转和科研发现几篇,评判者接受什么,本身就决定了能写多强的结论。证明交给检查器之后,还有题意是否译对的问题;科研系统写出可读的论文之后,还有产物能否由他人检验的问题。三处缺口没有共同的分数单位。下面只挑同时满足两个条件的争议:研究者能主动改变一件事,而且至少有一种可能结果会让自己收回原判断。
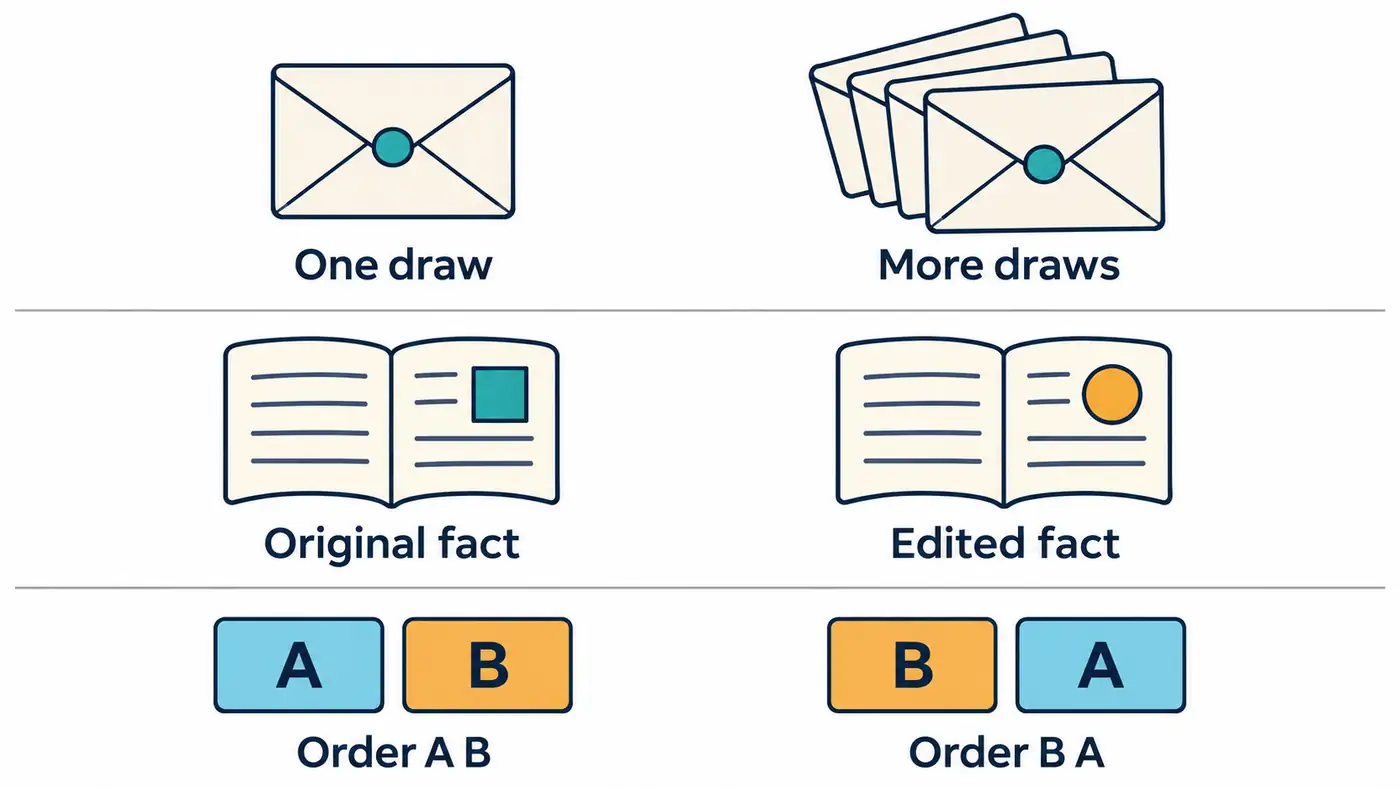
每一行是一项独立的拟议比较。信封代表生成机会,书页代表给定材料,字母卡代表已冻结的答案。图中没有测量值,也没有预设哪一边胜出。
例如,图检索那篇指出,建图时还可能补入新的文本信息。若想检验边的作用,就要让没有边的基线也读到相同材料。规模外推那篇要求把最大的几次训练留到拟合之后再揭晓。前者需要配平输入,后者需要隔离预测目标。这两种研究都很值得做,但只有答卷、没有建图记录或训练曲线的读者,很难补做关键对照。这是本篇选择下面三个问题的取舍。
问题一 再给起点模型几次机会,它会追回哪些题?
可验证奖励强化学习让模型根据答案核对等反馈更新参数。判断它带来了什么变化,通常要对照接受这次训练前后的两个检查点。一次作答衡量的是把题交给模型就得到正确答案的机会。多次采样则可以问,给每道题同样多次机会,只要其中有一次通过就算解出,能覆盖多少题?这个指标叫 pass@,其中 是每题最多查看的候选数。知道标准答案的评测者能识别命中,真实使用者未必能从这么多候选里挑出它。
Yue 等的图 2 给出了一个具体理由。若干数学基准上,强化学习后的模型在小预算处领先,增加采样后,起点模型可以赶上并反超。各题集采样深度并不统一,例如 MATH500 的这一分析每题生成 128 次,AIME24 则生成 1024 次。因此曲线的右端表示研究者实际看到的范围。某题到这里仍然零命中,既可能非常难,也可能存在概率极低的正确输出。两种情形不能靠再解释一次零来区分。Yue 等
连曲线是否真的交叉,也需要给出不确定性。Chen Yang 的预印本对相同题目的前后模型做配对推断,同时考察小预算领先和大预算落后。图 1 里,DeepScaleR 与自己的起点比较,单条回答上限从 8k 到 16k 再到 32k 个词元,可见的交叉和有统计支持的交叉出现在不同设置。词元是模型生成文本时计费和截断的单位。图中同一上限下两边被截断的比例也不同,各设置的每题生成数还有差异。它提醒我们记录未写完的答案;这张图本身不能给每个模型规定合适长度。Chen Yang
**可以怎样做。**选一对具有明确训练继承关系的公开检查点,冻结题目、提示模板、温度和判分器,另用开发题调通答案提取。先约定每题固定采样数和单条长度上限,同时保存实际词元数。在同一批输出上分别计算首次命中和预算内至少一次命中,并列出两边都中、仅前者中、仅后者中、都没中的题。最后一组也要出现在表里,否则难题在报表上凭空消失了。
若后训练模型首次更稳,而原先看似独有的成功被起点模型多次追回,这批题支持采样效率的解释。若有一批题只在后训练模型上反复命中,换一批预先留出的同类题仍如此,就有理由研究有限预算下新增的覆盖。停止条件是跑完预先分配的题和生成额度。若按题配对估计的差异区间很宽,或两边大量答案被截断,就把结果写成“这个预算还分不开”。为追求交叉一直加采样,会让终点本身也受结果影响。
问题二 把决定答案的那句话改掉,模型会跟着改吗?
假设档案写着展品收藏于甲馆,后来一份临时调拨单写着“借展至乙馆”。问收藏地与问当前展出地,正确答案可以不同。如果只换掉馆名,同时把问题里的“收藏”偷偷改成“展出”,就无法判断答案改变来自哪条信息。这是假设例子。它说明材料替换最费时间的环节常常是写题,尤其是确定究竟哪一个词控制标准答案。
Longpre 等在问答材料中替换实体,考察模型在原来能答对的样本上,会输出原答案、替换后的答案,还是别的回答。图 3 显示,在见过或更接近训练样本的情形中,生成式阅读器更常保留旧答案。他们的“记忆比率”用原答案次数除以原答案与替换答案的次数之和。“其他”被排除在这个特定比率之外,却保留在输出分布里。忽略这一点,一个常常答非所问的系统,也可能在两个命名答案之间显得非常果断。Longpre 等
**可以怎样做。**选有明确出处、能确认答案的短材料,要求模型“只按本段作答”。为每一题写一个原版、一个替换同类实体的版本,以及一个只改无关细节的对照版。三个版本分别在新会话里问,记录无材料时的答案作为参照。再加一个便宜的诊断:把有证据的那句话单独给它。如果这时能跟着读对,而放回全文就失败,可以优先检查定位与干扰;如果单句也读错,全文上的失败就没法单独归因于检索。
这里有两种截然不同的“成功”。两份有效材料各自答对,无关改写又保持原答,支持模型在这类题上使用了指定证据。所有改写都使答案大幅波动,则连对无关措辞的稳定性都成问题。预先约定同时报告全体题、原版答对的子集,以及拒答和其他回答。若替换引入语法异常、两个答案都说得通,先标为题面缺陷并报告比例。一轮独立检查仍不能确定唯一文本答案,就停用这组题。即使模型完全跟随虚构材料,也只能证明它执行了阅读指令,现实事实和跨会话知识更新还需要别的检验。
问题三 两份答卷只换座位,裁判还认得同一份吗?
Zheng 等在 MT-Bench 首轮问题上用同一个 GPT-3.5 生成两份相似回答,再让裁判分别以两种顺序比较。表 2 的默认提示下,GPT-4 的换位一致率为 65.0%。这里的“一致”要求换过位置后裁决对应同一结果,一直选择排在前面的回答反而会失败。作者特意挑了难分的情形,不能把这个数当作所有裁判或所有题目的判对率。他们随后采用保守办法,只在两种顺序都支持同一答案时判胜。Zheng 等
**可以怎样做。**从公开题中选出能独立判分的一小组,例如要求从文本提取两个字段。冻结两份候选,一份完整、一份漏项,尽量匹配长度;另建一组同样完整而措辞不同的近似平局。封存字段答案,裁判只见题面、答卷与评分要求。除了交换答卷,再做原顺序的独立重复,保持调用次数相等。这个额外对照有用,因为即使什么都不换,一个随机裁判也可能改判。每次都把位置还原到答案身份,分别记录胜负、平局和无法解析。
如果换位翻转超过原序重复的波动,而且总偏向同一个位置,顺序就能解释一部分裁决变化。如果同一份漏项答案在两个位置都稳稳获胜,换位一致性再高也救不了评分标准。先报告能独立核对的题里选对了多少,再看近似平局里有多少被硬分出胜负。实际开展时,在预先约定的重复次数用完后封表;若连明显漏项都持续判错,应停止用这个裁判讨论细微的风格偏好。两位答题者从头到尾没有再写一个字,这个实验定位的是测量环节。
总结 手上的材料决定从哪里开始
如果手头只有两批已经保存的答案,先做第三题最省事。若有权编辑输入材料,第二题能把“看起来参考了原文”变成一次可反驳的预测。第一题则有更高的入场成本,需要确知模型的训练起点,还需要按题保留失败输出。三者的模型、训练经历、题集划分、计算预算与评分单位都不同,不能把曲线覆盖率、实体选择比例和裁判一致率排成能力榜。
我会请准备开题的同学先写下两句话:“如果出现哪一种结果,我会放弃现在的解释?”“如果额度用完仍分不出来,我还可以诚实地说什么?”能写出这两句,就有了值得动手的小问题。实验即便留下一个宽区间,下一位研究者也能知道究竟要增加题目、修订材料,还是换一个判分办法。
参考资料
- Yue 等,NeurIPS 2025。Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?
- Chen Yang,arXiv 预印本 v3,2026-11-03。When Pass@k Crossovers Are Real—and Why: Paired Inference and the Markov Kernel of RLVR
- Longpre 等,EMNLP 2021。Entity-Based Knowledge Conflicts in Question Answering
- Zheng 等,NeurIPS 2023,Datasets and Benchmarks。Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。