大模型研究争议:AI 走进日常之后
封面为虚构的校园开放日场景。
周六早上,家长群里有人问开放日从哪扇门进。你把通知贴给 AI,问“九点到校的家长从哪个门进”,它答东门。孩子拿过手机,另开一个对话,贴上同一份通知,问“家长九点到了学校,该走哪一扇门”,屏幕上却出现了西门。两边的解释都挺客气,沿街多走一站路的却是你。这个例子是虚构的。真遇到这件事,我会先翻通知找“九点”对应的入口,再把两个问题和两句结论并排放好。
这里有几个容易混在一起的变化。如果孩子其实问的是“九点半到”,通知又恰好规定九点一刻后改走西门,改口就有道理。如果孩子问“是不是不走西门”,答案里的“是”也可能仍指向东门。真正值得追问的是,同一个人、同一份通知、同一到校时间,两次回答还原成要走的门,怎么指向了两个地方?
怎样看出一句话多带进来一个条件
先试着给别人出一对题。把“家长九点从哪里进校”改成“家长九点从哪个入口进校”,你很容易说出两句都需要查通知的哪一行。再把后一句改成“九点哪扇门还开着”,事情就微妙了。门开着,可能是让工作人员搬桌子。你可以知道它开着,仍然不知道家长能不能从这里进。两个疑问句共享了人们最容易注意到的词,能用来判断答案的证据却有了差别。
这件事连专门研究改写的人也得逐题处理。Alhetelah 和 Ahmad 用模型拟出两百道意见题,每题再写五种问法。一位作者逐条核验意思是否保留,遇到歧义或偏移就调整或重新生成。论文报告,大约百分之七的自动改写需要小幅人工调整。这个比例说的是制作题目的过程,并非模型答错的比例。也因为核验由一人完成,我们不知道换一位读者,会在哪些题上画出不同的界线。论文方法与表一
表一里就有一个值得停下来的例子。原题问是否赞成学生免费接受高等教育,一种改写明确提到由公共资金负担,并指定面向全体公民。设想一位读者支持由私人奖学金支付所有学生的费用,同时对谁有资格获得公共资助有另一套看法。她可以在两道题里选不同的答案,也能把理由讲通。这是我对题目的阅读,论文没有访问这样一位读者,也没有证明实际的答案变化由这些词引起。读者能做的检验是试着补出一个具体情境,让两句话分别成立和不成立。真能补出来,就值得重新商量它们算不算同一题。原文表一
研究者让五个模型面对固定的三个答项,要求只回答是、否或两者皆非。看结果时,他们先看每一组问法中最常出现哪个回答,再算有多大比例的回答与它相同,最后跨题取平均。假如一种答法一直支持免费教育,它可以得到很高的一致性,即使它从来没有说清楚经费来自哪里。图一里各模型的平均一致率都接近九成。这个数允许某一道题上出现相反的答复,也没有告诉我们学生、老师或纳税人会怎么选。想知道真人怎样理解那几句话,需要另找一份真的请人作答的研究。方法第2.4节、图一
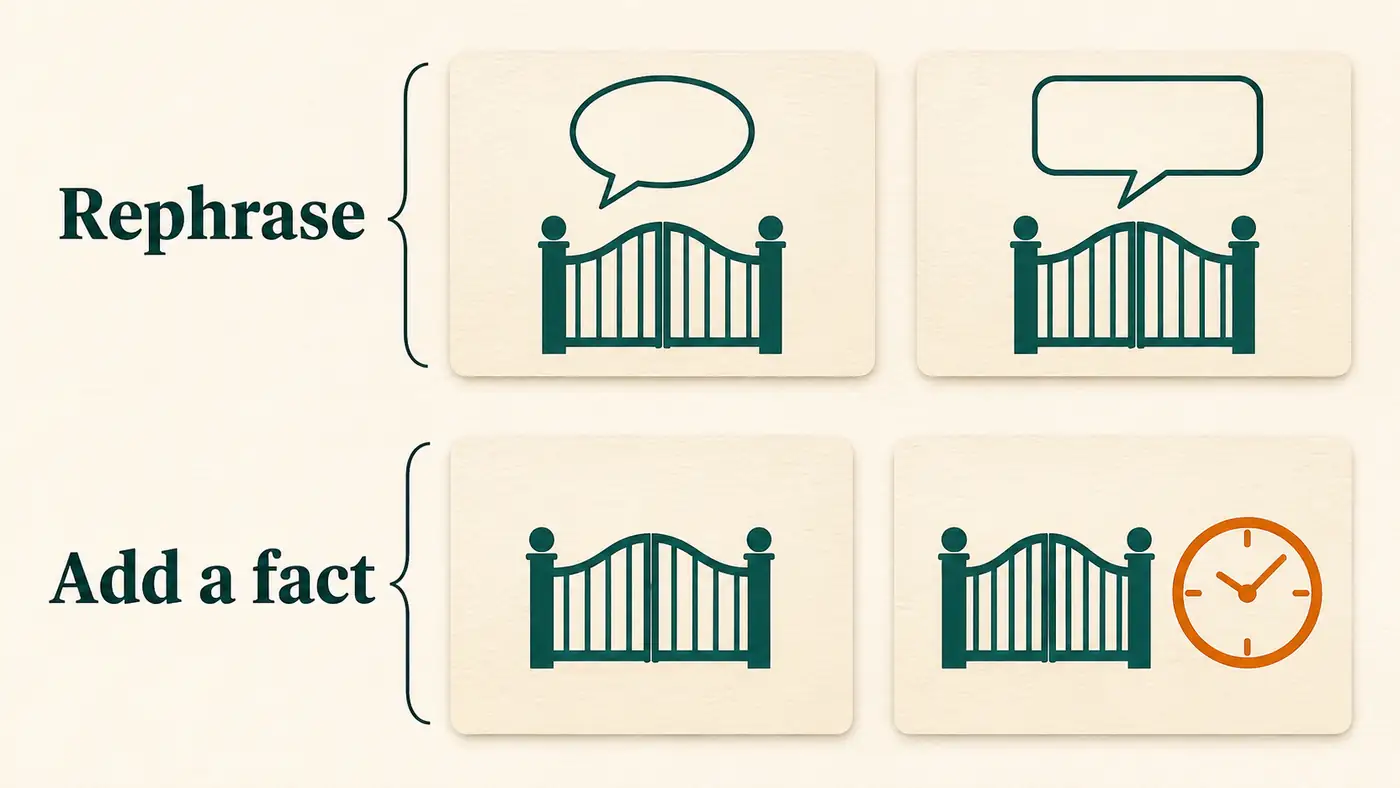
括号把每对要比较的问法放在一起。上排只换说法,下排补进到达时间。图中没有箭头,两排都是对照设计示意,不表示测量结果。
把“同意”翻回它指的那件事
Petersen 和同事设计的一组对照,很适合拿来想校门口的问题。他们用英文写成的保险情境,请人读完一小段故事,判断一条规定是否适用于主人公。这是读句子、判含义的任务。只看他们怎样出题就够了,无须懂保险,也不能用这些作答替现实中的任何人判断能否获赔。原文方法与表一
比如表一的车里坏了一件东西。保单提到车和车内的音响设备。一版坏的是工作用笔记本电脑,一版坏的是随身带的蓝牙音箱,还有一版坏的是车载音响。读者原先在犹豫随身音箱算不算,听说坏的是车载音响,完全有理由重新判断。研究者随后把同一件物品留在车内,只换最后那句要人表态的话。一种请你判断“在保障范围内”,另一种请你判断“不在保障范围内”。他们还调换了同意、不同意两个选项的先后。原文表一
我最想保留的就是这一步。按按钮的人如果前一次选了“同意”,后一次选“不同意”,两次都可以指向“在范围内”。要是只抄下按钮上的字,就会把忠实于原意的人记成改了主意。反过来,两次都按同意,看上去整齐,实际判断却彻底翻转。把每一份回答先译回“在范围内”或“不在范围内”,才有办法看清,换的是物品、问题的正反,还是手指下面那个按钮的位置。原文第4节、图一
这项实验有四十六则故事。每则各有三种内容、两种正反问法、两种选项顺序,合起来是五百五十二种题面。美国线上招募的三百人各做六题,剔除十二位用时不足两分钟的参与者,最后分析二百八十八人的作答。五组模型设置则各做全部题面。人的结果是分散在许多人身上的判断,不能读成研究者让每个人把同一道题反复做十二遍,观察谁前后矛盾。模型与人看到的选项呈现方式也略有不同。原文方法、表一
在这批人的回答里,故事内容改变时,判断随之改变。统计检验没有检出正反表述或选项次序对人群判断的显著影响。三组未启用推理的模型设置则都出现了正反表述效应。还有个比换品牌更有意思的比较,同一个 GPT-5.2 换到中等推理强度后,研究者没有检出那个正反表述效应,模型仍会随故事的实质内容而改变判断。不过,在论文图四的一个情境版本上,答题的十三个人都选择了适用。汇总五组模型设置与正反、次序组合,二十次模型回答里有十三次选择了不适用。两处“十三”的单位不同。前者数人,后者数模型在不同题面下的输出。回答变得稳定以后,仍得单独问它稳定地站在了哪里。原文图一、图四与第4.5节
有时变的是批答案的那把尺
再回到门口。假设第一次的回答是“去东门”,第二次是“从东侧入口进”。人看地图知道那是同一扇门,一张只收“东门”两个字的登记表却可能把第二份判成错。还有一种刚好相反的情形,两个回答都出现了“东门”,其中一个说的是“东门只供离校”。只要找得到两个相同的字就算答对,也会把真正能让人走错路的差别抹掉。
Hua 和同事沿着判卷这一步往回查。他们在六套题上比较十二种提示模板,用多种办法判模型给出的回答。遇到只能认固定写法的判分程序,同义的回复可能丢分。改用能参照标准答案判读含义的模型后,一些任务上不同模板造成的分数波动变小。有个有意思的例外,数学题的程序本就会化简式子、检查等价,换判分办法看到的波动就相近。能否识别这道题允许的不同表达,比简单地区分谁用机器判、谁用规则判,更贴近问题。原文第3节
他们也请人来判卷。在每套题里抽五十题,每题看一个指定模型在十二种模板下的回答,人用参考答案逐份判对错。六组汇总,百分之七十三的题在十二种模板下得到完全一致的对错判定。十二次全错也符合这个标准。这个结果尤其适合提醒做作业的孩子,要查“答案改了没有”,最好在纸上先写清楚你关心哪一种改变。两个不同的错误会得到同样的红叉,而“二分之一”和“零点五”明明长得很不一样,却可以同时拿到一个对勾。论文里这批人做的是批卷,在前一个实验里人做的是答题。这两个位置提供了不同的参照。原文第4节、表三
留三张便条,就能看见分歧在哪里
下面是一个可以立即试的纸上对照,本文没有运行。先写一条自拟通知:“开放日家长九点一刻前到校请从东门进,九点一刻起请走西门。”写三张便条,第一张问“家长九点到校,从哪扇门进”,第二张问“九点到校的家长应走哪个入口”,第三张只把第二张的到校时间改成九点半。三张都附同一份通知,先在背面写好你据以判断的那几个字,再请另一位读者独立圈出时间和入口。倘若你们读出的条件都不同,就先谈哪一个词容得下两种理解。
若要让模型也做,把每一张单独放进新对话,保留原答。可以先原样再问一次第一张,看看连文字都没改时会不会改口。记录时给每份回复留两栏,一栏写“照做会走到哪扇门”,另一栏抄“它依据的通知原句”。遇到同时给出两扇门的回复,看看它是否把时间段交代清楚。它若追问到校时间,可把“追问”单独记下。这样就不必为了凑成两个选项,把一次澄清硬算成一次选错。
纸上的预期很具体。头两张应把九点到校的人带去同一处。第三张的时间越过界线,仍旧坚持走同一扇门才值得查。如果连第一张原样重复都给出不同入口,仅凭第一次和第二次的差别就难以把原因归给改写。如果改写后仍走东门却引用了下午离校的条款,路线暂时一致,理由已经出了问题。把这两栏拿给孩子看,他可以指出错在通知的哪一行,无须猜测模型心里怎么想。
还有个办法能帮写通知的老师看出问题。把原句里的“九点一刻起”盖住,只给人看前半句,再问第三张便条。此时能确定的只有九点半已经晚于前半句规定的时段。要断定西门可以进,还差后半句。若读者愿意在证据空缺时留下一个问号,这个问号就标出了通知最值得补写的位置。同样的做法也能拿来核对一份回答里多出来的细节。
三份研究没有观察中文家长群,也没有统计多少家庭因此走错路。一条通知上找得到原句,另一些真实通知偏偏漏掉了“家长”或“九点以后”的安排。遇上后一种情况,在群里问老师“九点半到的家长也从东门进吗”,比反复改写同一句疑问更能补齐证据。等新通知来了,再改变答案,恰好是我们希望读者和模型都能做到的事。
参考资料
- Bushra Alhetelah、Irfan Ahmad,2026。Measuring LLMs’ Sensitivity to Paraphrased Opinion Prompts,WASSA 2026 工作坊正式论文。原文
- Dawson Petersen、Abhishek Purushothama、Nathan Schneider,2026。Sense and Sensitivity: “Reasoning” Models are More Robust, but can Diverge from Human Consensus in a Legal Interpretation Task,CoNLL 2026 正式论文。原文
- Andong Hua、Kenan Tang、Chenhe Gu、Jindong Gu、Eric Wong、Yao Qin,2025。Flaw or Artifact? Rethinking Prompt Sensitivity in Evaluating LLMs,EMNLP 2025 主会正式论文。原文
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。