- 日期:2026-11-02
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-11-02;重点检索近12个月一手研究,不声称全面覆盖。本文为论文深读,未运行模型实验。
摘要:说出了图中对象,还缺哪一层证据?
模型回答“桌面上可以喝茶,因为有茶壶和杯子”,还把杯子的位置指出来。这样的解释比一句“可以”更容易检查,但仍留下一个问题:杯子真影响了答案,还是模型决定答案后才找到了合适的说法?封面以茶具作概念插画,并非论文样本,也不是严格配对的实验刺激。
本篇对照三项研究:逐句核对视觉描述、删除对象观察预测变化,以及用成对图像检查描述与判断的一致性。**当前证据支持把视觉依据单独评估;它还不支持把流畅解释、正确定位或高答题分数当成内部推理透明的证明。**三篇论文并未形成简单的赞成与反对阵营,主要差别是“忠实”究竟指哪一种关系。[1][2][3]
先把“可信”拆开
多模态思维链,是模型针对图像与问题输出的中间推理步骤;本文主要讨论可见文字解释,而不是所有内部计算。视觉落地,指一句描述能够对应到图中的对象、属性或关系。行为忠实性则进一步追问:解释强调的证据,是否与模型预测对输入变化的反应相符。
这里至少有三种可区分解释。第一,模型使用了杯子这条证据,并在理由中准确报告。第二,模型确实看见杯子,却主要依据其他线索作答,理由只是正确但不完整的场景描述。第三,模型错误感知或受到提示暗示,生成一条听起来合理的理由。这三种情况都可能碰巧答对。
为便于理解,可以做一个尚未执行的思想实验:保留茶壶,移走杯子,问题仍问“有没有可直接使用的饮水容器”。如果模型坚持原答案,需要检查它是否把茶壶也算容器,而不能立即宣布它没看图。干预的含义必须由题目与标签规则共同决定;读者直觉中的“关键对象”,未必就是任务定义中的必要证据。
第一层:解释里的视觉陈述是真的吗?
Uppaal等的《Journey Before Destination》把推理链分成感知步骤和推理步骤,仅对感知步骤判断是否符合图像,并用模型裁判统计不忠实感知率。作者还以人工标注比较裁判可靠性;这不等于裁判在任何任务都具有人工金标质量。1,§3与表1
这项研究在感知任务中使用同一基础模型衍生的推理模型,并借助外部检测器定位问题步骤再生成。它报告视觉描述可以改善,但表4显示,换用较弱检测器后,描述指标变好也可能伴随答题准确率下降。额外检测与重写还增加推理成本。因此,不能把结果表述为“模型只靠自己反思就更可靠”,也不能把感知句符合图像等同于这些句子造成了答案。1,§5–7、表4与局限
本篇的理解是:这一层适合回答“有没有说错图”,而非“有没有说全作答原因”。假如一段解释只说“画面里有物体”,它可能很少出错,却几乎没有帮助。评价还应关心相关性、遗漏和信息量;否则删掉具体细节也可能改善表面指标。这是对测量目标的分析,不是该论文已验证的作弊实验。
第二层:影响预测的对象,解释提到了吗?
Menzat等构造删除单个对象的图像对,分别询问原图与编辑图,用候选答案概率的变化衡量干预影响,再判断解释是否提及被删对象。其vCCT考察影响幅度与提及之间的相关性;vCT则只把“答案翻转而未提及”计为失败,因此不翻转很多时容易得到高分。2,§3
在两类任务、八个模型的比较中,先回答再解释的vCCT高于先写解释再回答。这里测的是特定提示下的可见解释,不能外推为所有原生推理轨迹;概率也只在固定候选集合内归一化。作者用不删除对象的重建作为伪影对照,但编辑与提及识别仍会出错。结果说明解释顺序会改变这个行为指标,不能证明事后解释还原了内部计算。2,§3.3–4与表1
这个结果看似反直觉,其实暴露了两个不同问题:“解释能否预测哪些输入变化会影响答案”和“答案是否依赖已经写出的解释”不是一回事。先答后解释无法作为同一次已完成作答的前置步骤,却仍可能描述相关输入。反过来,先写解释也不保证每句话都是必要计算。
对研究者而言,删除对象的价值在于主动改变证据。但变化大也可能来自画面不自然、遮挡关系变化或候选答案失效。若移除唯一能回答问题的物体,却强迫模型在原来的选项中选一个,测到的可能是无合适答案时的响应。此时应先判断题目是否仍可回答,再解释概率移动。
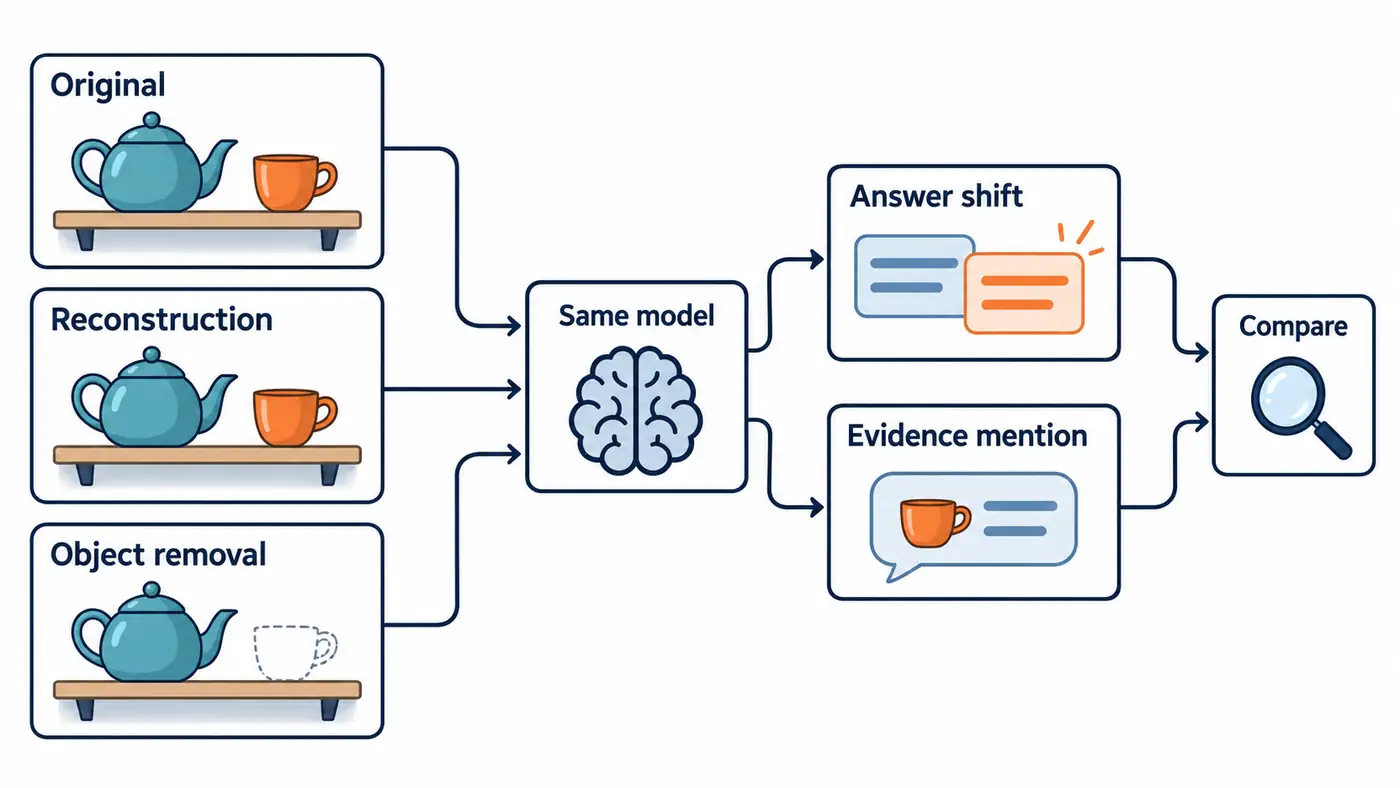
图:拟议的测量流程。原图、保持内容的重建图与删除对象图分别交给同一模型,再对照答案变化和证据提及。箭头仅表示信息处理顺序;虚线杯子标示被移除位置,不应出现在真实测试图中。图中没有论文测量数值,也不表示已证明的因果机制。
第三层:看到了差异,能否稳定地说清楚?
Lv等的SPD-Faith Bench让模型比较图像对,区分是否发现变化、是否说对对象和变化类型,以及解释和判断是否自洽。其矛盾率针对“相同吗”和“不同吗”等对称提问;描述对齐指标则评估解释与视觉差异。论文报告不同维度表现并不同步。3,§3
作者进一步结合注意力和隐藏表示分析解释失败,并提出视觉信息传递方面的解释。本篇采用较窄的判断:热点落到区域上,不能独自证明属性已被正确编码或用于后续答案。已读v1的数据构建段还同时出现人工核验及将进行核验的措辞,因此本文不把数据人工检查状态扩大表述为全部无误;也不据此否定已报告的诊断结果。3,§3.1、§4
这项工作提示一个实际的阅读陷阱:模型回答“不同”,同时写错了差异是什么,不能算完整成功;但回答对称问题时自相矛盾,也不能直接被称为有意撒谎。否定句理解、随机采样、输出解析和视觉识别都可能参与。要定位责任,需要为这些环节分别保留对照。
三种证据为何不能直接排名
| 测量问题 | 观察入口 | 能支持的局部判断 | 尚不能证明 |
|---|---|---|---|
| 感知句符合图像吗 | 逐步标注与裁判 | 描述错误是否减少 | 解释是否造成答案 |
| 解释跟踪视觉影响吗 | 对象删除与预测变化 | 提及和干预影响是否相关 | 完整内部因果路径 |
| 描述与判断一致吗 | 图像对及对称提问 | 差异描述、逻辑一致性缺口 | 失败来自唯一机制 |
表中三个入口分别对应[1]、[2]、[3]。任务从单图感知问答到视觉蕴含、再到双图差异描述,模型起点、提示和输出结构均不同;一个比例按感知句汇总,一个指标是样本间相关性,另一个衡量成对回答的矛盾。它们既没有共同分母,也不是等预算比赛。
尤其要区分评估与改进。[1]引入检测和重写,[2]主要比较提示与测量协议,[3]还讨论内部表征与修正方法。若把它们放在一起宣布某种训练方式最有效,就越过了论文实际控制的变量。本文只比较证据能回答的问题,不拼接榜单数字。
一个能区分解释的后续实验
下面是建议方案,未在本次运行。先固定一个可读取候选分数的模型与一组明确依赖对象属性的问题。每题准备原图、保持内容的重建图、改变关键属性图,以及改变无关区域图。先确认题目在每张图上仍有合法答案,保存编辑指令和实际变化区域;不要把“编辑请求只改一处”当成“图片确实只改一处”。
在完全相同的图像和问题上比较直接作答、先解释后作答、先答后解释。三种模式记录实际输出长度、图像分辨率、采样设置和模型调用次数。预算无法完全相等时,同时报告每种模式成本,并增加同等总调用额度的直接作答对照,避免把多看几次图的收益归给解释形式。
判读时保留三份互不替代的记录:最终答案是否正确;感知陈述是否受图像支持;被改变的关键证据是否被提及。提及还要检查方向,例如“杯子消失”与“杯子仍在”不能只因都有“杯子”就同样计为成功。裁判应看具体图像与句子,并用独立抽样标注估计误差,不能让生成模型自行宣布通过。
如果解释能反映证据,关键属性变化应当引起与任务相符的描述和预测变化,无关编辑则不应造成同等幅度的扰动。如果只有描述变了而答案对关键属性不敏感,应检查是否存在替代证据或下游绑定失败。如果答案变了但理由不更新,则更支持解释遗漏重要因素。若重建图也造成类似变化,应先排查图像处理流程,而不是扩大忠实性结论。
进一步检验解释是否参与答案,可以固定图像,只替换中间解释中的一条属性,再让模型继续回答;同时加入同义改写和无关句替换。这个操作仍可能制造模型平时不会遇到的前缀,所以必须报告输入异常的影响。即使得到方向一致的变化,也只支持该设置下的依赖,不能据此认定整条推理链完全透明。
预先规定什么结果会推翻自己的解释也很重要。若效果只出现在一个编辑器或一种提示中,就收窄到该协议;若换用独立裁判后差异消失,就优先解释评分偏差。不要只挑答案翻转的成功例子:保留没有变化、拒答和无法判定的样本,才知道测量覆盖了什么。
总结:更详细的解释,要接受更具体的检验
多模态思维链提供了可检查的陈述,因此有研究价值。但可检查不等于已经可信。读一篇声称解释更忠实的论文,应先问它核对的是图像事实、输入影响,还是解释对答案的作用,再看对照是否足以排除替代解释。
本篇的当前结论是:把这三层证据分开报告,比给模型贴上“会看图”或“只会编理由”的总标签更可靠。真正未决的问题,是这些测量能否在相同任务、相近预算和独立裁判下共同改善,并在新的视觉条件中保持。
参考资料
- Rheeya Uppaal、Phu Mon Htut、Min Bai、Nikolaos Pappas、Zheng Qi、Sandesh Swamy,2026,Journey Before Destination: On the importance of Visual Faithfulness in Slow Thinking。EACL 2026正式论文;本文读取正式全文。
- Bayar Menzat、Maximilian Süss、Ruizhi Wang、Benno Steinegger、Thomas Lukasiewicz、Oana-Maria Camburu,2026,Counterfactual Tests for Measuring Chain-of-Thought Faithfulness in Visual Language Models。Findings of EMNLP 2026正式页面;正式PDF因访问大小限制未取得,方法与结果依据arXiv v1全文,不声称逐字核对最终出版版。
- Weijiang Lv、Yaoxuan Feng、Xiaobo Xia、Jiayu Wang、Yan Jing、Wenchao Chen、Bo Chen,2026,SPD-Faith Bench: Diagnosing and Improving Faithfulness in Chain-of-Thought for Multimodal Large Language Models。Findings of ACL 2026正式页面;正式PDF因访问大小限制未取得,实验讨论依据arXiv v1全文。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:按当下的时间和精力选择小行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。