- 日期:2026-10-24
- 读者:研究生、科研新人和工程型研究者
- 资料截止:2026-10-24;检索覆盖近12个月相关工作,并保留方法起点。本文是文献深读,未运行模型实验,不声称全面覆盖。
摘要:先问“加图”究竟加了什么
把一批文档整理成图,再回答跨文档问题,成绩提高了。我们容易把结果解释为“关系建模起作用了”。但建图通常还会抽取事实、生成描述、合并实体、预先总结文档,并改变查询时的计算量。模型看到的内容和获得内容的过程,都可能一起变化。
**当前证据支持某些图增强系统在特定任务上的价值,却不足以把全部收益归给图的连接结构。**本文用原始GraphRAG、HippoRAG 2和一项更新至2026年的系统评估,分别考察全局概括、图引导检索和预算对照。原始研究、HippoRAG 2、系统评估的任务和评测不同,不能拼成一张冠军榜。
一条边,不只是画在两个点之间的线
检索增强生成,简称RAG,是先从外部资料找证据,再让语言模型据此回答。图增强方法把实体、段落等表示为节点,把关系或归属表示为边。三元组是“主体—关系—客体”这样的事实单位。图的拓扑则是节点如何连接;它与节点上的文字、边的语义标签不是同一件事。
设想一个纯说明性例子:材料甲说某研究者参与项目,材料乙说项目由某基金资助,问题问研究者关联哪些资助方。按问题与段落相似度各自排序,可能只找到甲;沿项目节点扩展,有机会找到乙。不过,若一段预生成摘要已经写出两者的联系,即使不遍历图,也可能答对。这个例子没有测量结果,只说明两种可区分的解释。
因此,至少要分开三条假设路径。第一,连接帮助导航:正确关系使检索器跨过词面距离,找到缺失证据。第二,加工提高可读性或覆盖度:抽取、实体归并和摘要让答案更容易被检索。第三,资源改变搜索机会:更多候选、更长上下文或额外模型调用提高成功率。它们可以同时成立,不必互相排斥。
“更多信息”也需说清:同一语料的摘要未必增加新的外部事实,却可能增加某次回答实际看到的相关内容;抽取模型还可能混入自身知识。若不给生成内容保留原文出处,就无法分辨有效压缩与未经支持的补充。这是本篇提出的归因问题,不是对所有建图系统的事实指控。
三项研究,回答的是三个层次的问题
**原始GraphRAG研究全局概括。**它从文本抽取实体关系,划分连接紧密的社区,再生成社区摘要;查询时分批作答、汇总。实验既有向量检索,也有直接对原文做分批汇总的TS基线。社区方案在部分全面性、多样性比较中占优,但v2的声明计数及聚类指标没有显示它与TS存在显著差异。这里的“声明”是可核查陈述的抽取单位,不代表每条已核实为真。§3–5,尤其§5.2
这项设计的价值是提醒我们:弱基线可能没有机会看到全局。图方案胜过局部检索,不能直接证明连接本身不可替代;它与全文汇总的对照更接近这个问题。作者也将研究范围限制在两套语料上的全局问题,明确保留对虚构内容的进一步评估。较丰富的回答和较可靠的事实,仍是两种测量。§4.1、§6.1
**HippoRAG 2把图用于挑选原文段落。**它同时纳入短语与段落节点,让查询匹配三元组,经语言模型过滤后,用个性化PageRank传播相关性,再取段落作答。这个算法可以直观理解为:从与查询有关的位置出发,按连接分配访问权重,而不是只看每段文字单独有多相似。§3
其多跳检索消融显示,去掉段落节点或改变查询连接方式会影响召回;但查询到节点的替代方案并未使用同样的三元组过滤,过滤消融也不是每个数据集都改善。最终系统包含多个相互作用的部件,不能把整套系统与稠密检索的差值命名为“纯拓扑收益”。这里的召回是找回支持段落的程度,也不同于最终答案正确率。表2–4、§6.1
**Han等的系统评估提供了更直接的预算检验。**在其Llama-3.1-8B、MultiHop-RAG设置中,普通RAG、补齐token预算的RAG和社区局部GraphRAG,总体准确率分别为67.02、69.33、69.01。补齐预算后,文本方案的总体分数已接近图方案;不同题型仍有差异。这里的token是模型处理文本的计量单位,等数量不等于等证据。附录M,表31–32
这组结果不能证明图无用,也不能证明剩余差异就是图关系的因果作用。它只改变了一个重要解释条件:原先的前十个段落与前十个实体及其关联内容,实际输入量并不相同。预处理信息、索引和检索过程仍有差别。论文还测试了更强文本检索策略,不能把它概括成“只比较最朴素基线”。§3.4、§4.3、附录M
| 证据切口 | 关键条件 | 能观察到什么 | 尚不能证明什么 |
|---|---|---|---|
| 全局概括 | 社区摘要对照原文汇总 | 组织方式与指标相关的差别 | 所有优势均来自连接 |
| 图引导检索 | 段落、查询连接和过滤消融 | 部件改变后的召回变化 | 孤立的拓扑因果贡献 |
| 输入预算对照 | 同任务、同生成模型,补齐token | 部分系统差距收缩 | 等信息、等总计算下仍占优 |
为什么不能直接比较论文里的分数
先看问题要求什么。跨语料概括需要覆盖多个主题;多跳问答需要凑齐一条支持链。一个答案包含更多视角,不等于它在资助关系问题上找对了全部节点。评价全面性的裁判偏好,也不能直接替代问答准确率。把这些任务都称作“复杂推理”,会掩盖真正的测试对象。
再看模型起点。HippoRAG 2主实验使用Llama-3.3-70B与NV-Embed-v2;上述系统评估采用另一套建图、嵌入和生成配置。因此,即使都使用某个同名数据集,也要继续核对抽样、语料范围与提示。本文只在各篇内部解释对照,不用跨篇数字判断某个方法后来“退步”了。两篇实验设置、统一设置说明
还要区分资源的时间位置。建图调用在索引阶段付出,摘要可能被后续查询复用;查询扩展和过滤则在每次提问时发生。仅报告最后一次生成长度,会漏掉前面的工作。反过来,把一次建图成本全部压给第一道题,也可能误判大量复用时的效率。更可解释的比较应分别列出索引成本、每题成本、查询数量与更新频率。
这些区分导向一个有限结论:图是组织和选择证据的候选工具,系统成绩是其有效性的起点证据;要解释为什么有效,还需要更细的干预。“关系有帮助”与“摘要有帮助”之间,现有研究并没有形成必须二选一的阵营。
下一步实验:让竞争解释给出不同预测
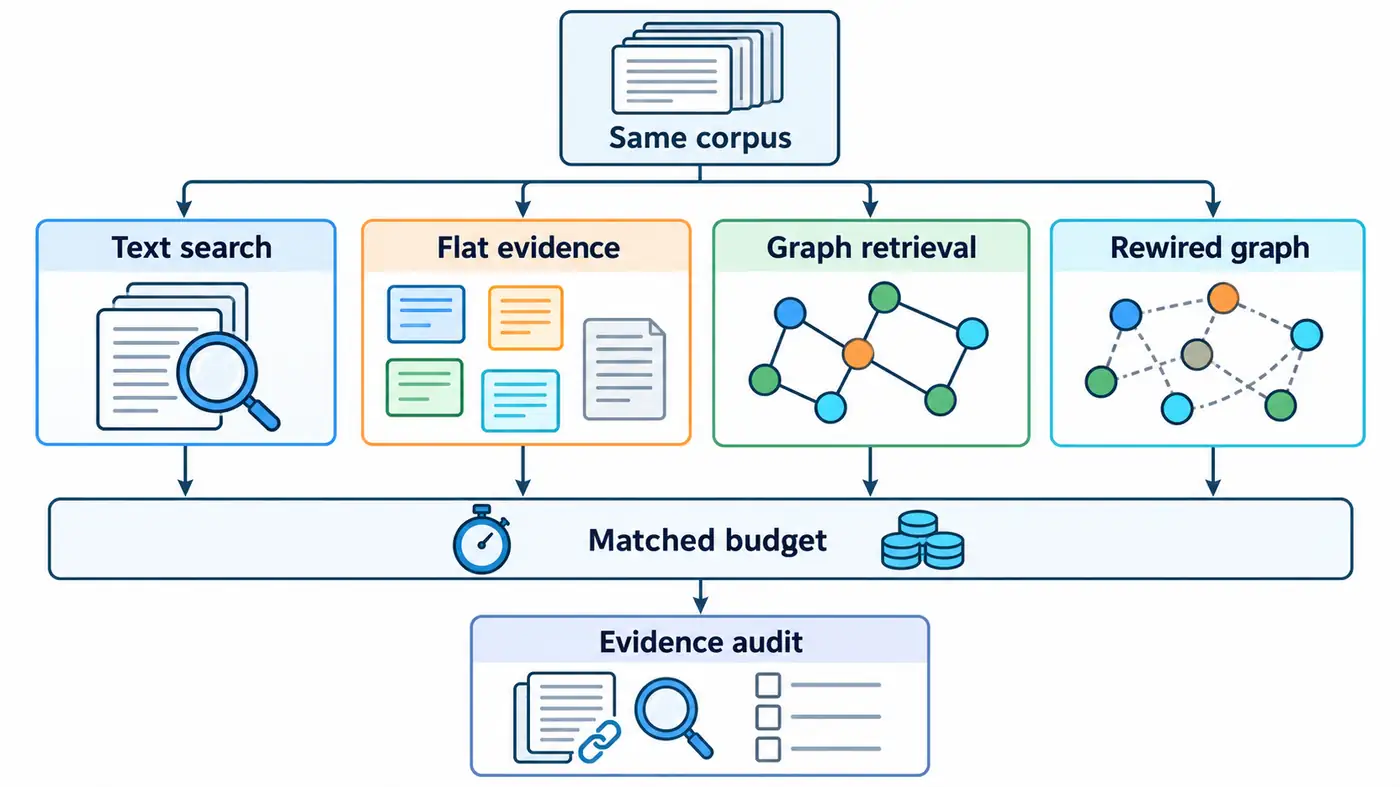
图:本篇提出、尚未执行的四路对照。实线箭头表示处理流程;右侧虚线边表示重连干预,不表示已观测到的机制或效果。节点颜色仅为分组示意,不编码概率或对应关系;公平控制以保存的数据为准。预算栏要求实验开始前规定限制,图中下置只是汇总呈现。
可以先固定一个语料快照和生成模型,设置四路:原文文本检索;可访问同批抽取事实与摘要、但不使用邻接遍历的平铺检索;完整图检索;保持节点文本、改变导航连接的图检索。第二路回答“信息加工是否已经足够”,第四路回答“当前连接有没有被有效利用”。它们与原文基线合用,才比单独删掉整张图更有诊断力。
这里有一个容易忽略的陷阱:关系文字本身也是信息。若重连同时改写三元组内容,掉分可能来自读到了错误事实,而不是失去导航结构。因此可先只干预检索器使用的邻接关系,让最终答案仍依据可回查原文;明确不把虚假连接作为事实喂给生成器。随后单独开展关系语义干预,两种实验不要混报。
重连也不能随意进行。应保留节点数量、适当的度分布和候选访问限制,并记录断连、可达距离等变化。否则,系统变差可能只是大量证据变得不可达。这样的控制依然不完美,但它能让“正确连接提供导航信号”的解释比“破坏索引当然变差”更具体。
预算最好分两轮处理。第一轮匹配最终输入token和生成设置,考察证据选择;第二轮匹配总模型调用或计算上限,把节省的预算给文本方案用于重排、多轮检索。索引构建单独记账,并报告不同查询次数下的摊销。若某个对照无法同时满足所有预算,应展示差异,而不是把“公平”当作一个没有内容的标签。
评测也应沿流程拆开:先看支持段落是否进入候选,再看是否凑齐跨文档链,最后看答案与引用是否被原文支持。按直接事实、关系组合、全局概括和无答案问题分组,避免一种题型的增加改变总分含义。语义正确性若需要人工金标,就明确安排独立标注;模型裁判只能作为另一种测量,不能冒充人工判断。
测试题与建图提示、过滤提示的开发数据应分开。可以利用公开数据中已有支持段落的题目,但要检查答案是否被某份摘要提前直接写出,并把这种情况单独报告。它仍可能是合法的预处理收益,只是不能被当成查询时沿边推理的证据。
最后预先写下结果如何解释:平铺方案追平完整图,支持信息加工解释;完整图在等预算下仍领先,且适当重连后下降,更支持导航结构有用;只有增加调用时领先,则应把优势表述为资源利用方式。任何一种结果都只约束该语料、任务和实现,不能宣判所有图方法的价值。
总结:把系统收益拆成可以追问的贡献
读到“加入图后提高”,可以继续问:新增了哪些文字,改变了哪些连接,多做了哪些计算,最终量到的是覆盖、召回还是正确性?这四个问题决定结论能走多远。值得继续验证的不是图是否天然优越,而是在同等信息机会下,哪些关系能让证据更容易被找到、组合并核查。
参考资料
- Darren Edge等,From Local to Global: A Graph RAG Approach to Query-Focused Summarization,2024初稿、2025年v2。原文v2。本次按预印本引用,未确认正式发表记录。
- Bernal Jiménez Gutiérrez等,From RAG to Memory: Non-Parametric Continual Learning for Large Language Models,ICML 2025。正式发表页、本次核验全文v2。正式PDF访问失败,方法和数值均以所读v2为准。
- Haoyu Han等,RAG vs. GraphRAG: A Systematic Evaluation and Key Insights,2025初稿、2026年3月v3。原文v3。作者发表列表列为KDD 2026;本次未取得可独立核对的会议收录条目,ACM页面访问受限,不声称已阅读正式终版。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也独立开发了一些日常小工具,欢迎了解:
- 日常收支小记:记录日常收支,安排预算与储蓄目标,让每一笔钱的去向更清楚。在 App Store 了解。
- 一事微光:按当下的时间和精力选择小行动,记录完成后的感受,为日常行动与复盘留一点空间。在 App Store 了解。
更多技术文章与个人作品,欢迎访问我的网站:zffjzz.top。也欢迎分享使用感受,帮助这些小工具逐步改进。