大模型研究争议:AI 走进日常之后
孩子收到交流活动的英文邮件,让 AI 翻成中文。你扫了一眼:“参加者周五之前会收到分组信息。”于是放心等通知。孩子却指着原文问:这里的 may,是不是只说可能收到?这是一个自拟情境,不是实测案例。第一层回答很简单:中文没有病句,不代表原来的承诺还在。收件时间译对了,谁发通知也译对了,仍可能把“可能发生”变成“已经保证”。
但反过来也不能见到英文里的一个小词在中文里消失,就判定翻译失真。译成“预计周五前发出”,未必还需要另加一个“可能”;译成“周五前一定发出”,才明显提高了确定程度。今天要查的不是两种语言有没有逐字对应,而是看完译文的人,会不会比看原文的人多相信一件原话没保证的事。
一句话顺不顺,和它答应了什么
先把三种判断拆开。读起来是否自然,可以由熟悉中文的人判断;意思有没有变,需要对照两种语言;读者最后理解成什么,还得让读者作答。一个人在前一项给出高分,并没有顺手完成后两项。这也是不懂原文时最难的一步:我们能感到中文流畅,却缺少发现语义变化的参照。
还要分清“小词”究竟在做什么。自拟例句“你可以提前进教室”,可能是在说允许,也可能是在说门开着、条件允许;“他应该到了”,可能是根据路程作推测,而不是规定他有到场义务。只让模型把所有 should 换成“应该”,保住了字面,却可能没有保住说话人的意思。问一句“谁允许的,还是谁推测的”,往往比数情态词更接近问题。
因此至少有两种可区分的解释。第一种是语义真的被改强了:原话保留了不发生的可能,译文把它封死。第二种是表达方式改变了:不确定性换到“预计”“据目前安排”或上下文里,意义仍在。另有一种值得单列的情况:原句本来就含糊,译者选了一种读法。那需要补上下文,不能靠中文更漂亮来裁定。
这些解释会导向不同的修改。真被改强,就恢复原来的保留;换了表达但意义没变,不必硬塞重复的“可能”;上下文不足,就保留歧义或请发信人说明。翻译不是把一句话改得越谨慎越好。原文明明已经确认,译文擅自加“不一定”,同样可能让读者误判。
近期研究看见了问题,也留下了账没算清
Karachina 在二〇二六年发表的研究专门检查俄译英的情态表达。材料是一百六十句,按四类情态各选四十句,包括选取的语句和作者构造的语句;它不是对日常翻译请求的随机抽样。研究把传意、语法、风格和情态类别等分开评判,列出的错误包括把一种情态换成另一种,以及没有传出情态意义。它支持“值得单独检查”,不能给中文邮件提供一个通用出错率。
读这篇时尤其要压住抄排行榜的冲动。方法节把五项评分汇总成百分比,结果节又使用“正确翻译”的说法;如果不知道具体分母,就不应把数字写成一百封邮件里有多少封译对。正文仅称 ChatGPT,没有足以锁定后台模型的版本标识;不同平台的“改进”操作也不完全相同。本文因此不转述其优劣排名。能从这份近十二个月的一手研究带走的,是把语法与情态分开查的办法,而不是哪个服务今天最可靠。
这不是挑剔论文格式。假设一份译文语法、风格都很好,只把“可能”改成“必然”,综合得分仍可能显得不错;而另一份译文用词生硬,却准确保留了保留态度。对准备按邮件办事的家长,这两种错误的意义不同。这里是假设性说明,没有给研究重新算分,也没有声称它的某个样本正好如此。
最能改变判断的对照:给同一句话补上前后文
Karpińska 和 Iyyer 的文学翻译研究用同一个 text-davinci-003 模型,比较只给单句、提供整段但逐句翻译、以及整段翻译三种设置。人工评价覆盖十八个语言方向、一百八十个原文段落;评价者对照原文标出错误,再比较译文优劣。这测的是机器译文质量,由人来判,不是测学生读完能考多少分。
论文图五中,整段翻译相对“看整段但逐句译”获得约三分之二的偏好票。但表二同时显示,两种设置的误译计数接近,整段译并非每一项都最好。这个对照比简单比较两个品牌更有解释力:看得到上下文,以及允许把整段组织成目标语言,是两个可分开的条件。研究仍发现漏译等问题;文学文本和旧模型的结果也不能直接搬成今天中文通知的成绩。
把这一点放回邮件,可以设计一个未执行的小对照。先只翻“你应该周五到达”,再补上前句“我算过列车时间了”,最后换成“参加者须遵守以下报到安排”。后两版改变了信息,不能拿它们的不同译法证明模型不稳定。恰恰相反,合理译者应当让前一种更像推测,后一种更像要求。只有原文和语境保持不变时,才能进一步追问哪个译法无端改了强弱。
这也解释了为什么“只改一个词”有时不公平。如果你先把原文的 maybe 删掉,再责怪两次译文不同,测试的已经不是忠实程度,而是模型有没有跟随信息变化。真正有用的控制是保留原文,把两份候选译文放在一起,只改确定程度,再请懂两种语言的人指出哪份额外许诺了什么。
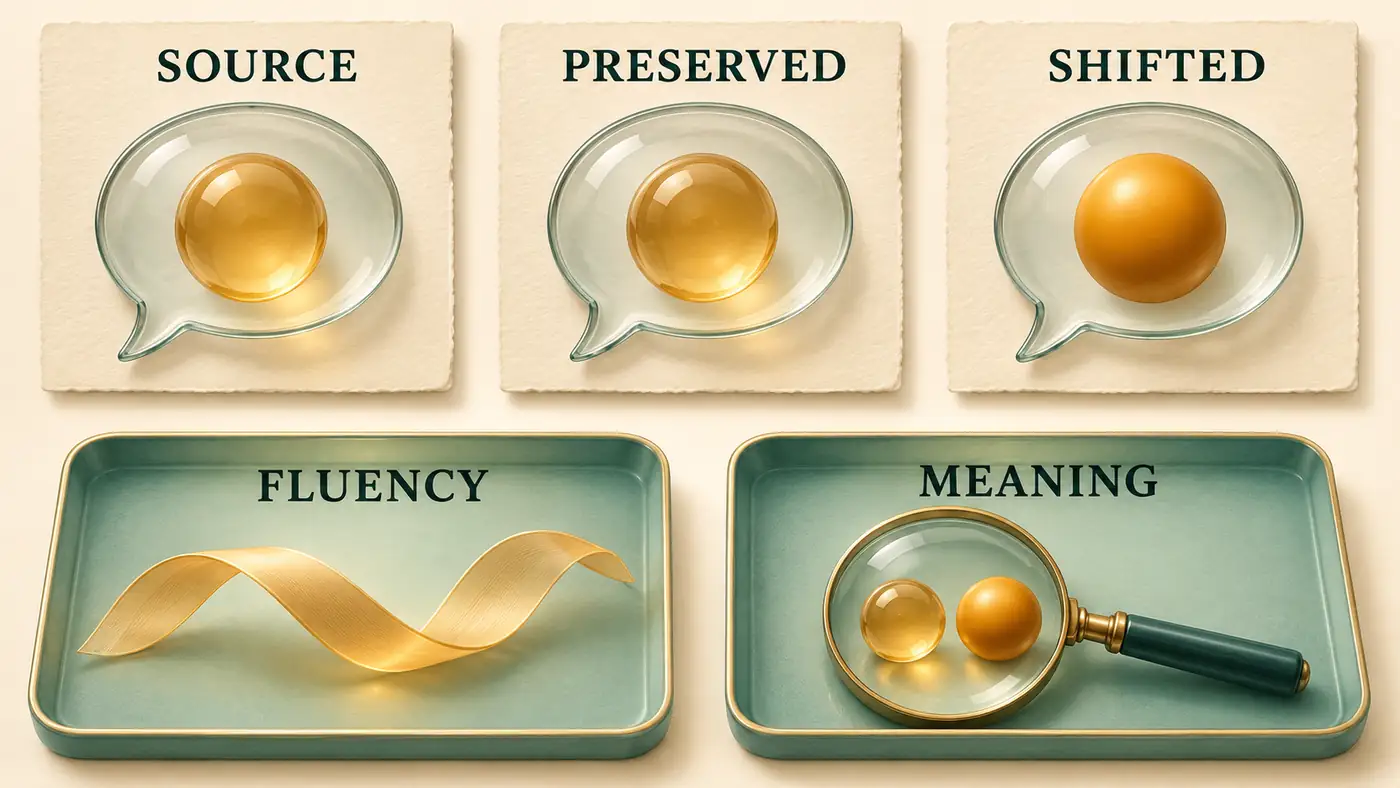
方法示意:同一原文对应两份候选译文,比较语气强弱;下方分开检查流畅度和意义。球的透明度只是概念符号,没有概率刻度;图中没有因果箭头,也不是论文测量结果。
“不”还在,也可能已经否定错了地方
确定程度之外,另一个容易藏进顺畅句子的变化是否定范围。看两句自拟中文:“不是每个学生都要发言”和“每个学生都不要发言”。都有“每个学生”和“不”,读者得到的安排却完全不同。前一句不要求人人发言,后一句要求人人不发言。只检查否定词有没有留下,会把这个区别放过去。
Tang 等人的经典研究研究的是神经机器翻译,不是今天的聊天大模型。其英德人工评估在两个方向各抽二百五十句,英中使用带否定标注的 NegPar 材料。表五区分保留否定词、换一种说法仍准确、范围错位、意思错误和遗漏。表六把准确改述也算作正确。因此没有对应的“不”不必然算错,有“不”也不保证对。
这篇还明确区分两类测试:让模型给正确译文与人为改错的译文打分,以及检查模型真正生成的译文。前者像一道选择题,后者像独立写答案;前者过关不能代替后者。本文借用它的评估区分,不把旧系统的正确率当作现有产品表现,也不把模型选对的比例写成双语读者理解正确的比例。
对普通读者,否定范围可以用一句追问检查。看到“不是所有活动都需要报名”,就问“有没有不报名也能参加的活动”;看到“所有活动都不需要报名”,就问“哪一项还要求报名”。这只是帮助找出语义差异的例子;真实通知若还有其他条件,不能靠一条孤立句子决定参加资格。完整段落仍是判断的依据。
把“读者理解”补进来,还缺一次什么实验
上面三份研究没有共同完成这样一个实验:把同一封英文邮件的不同中文译文随机给中文家长,记录他们对发信人承诺的理解。不能从译文里找到一处语气变化,直接跳到“家长一定会因此安排错时间”。有人可能看得出不确定,有人可能另问老师,也有人原本就不会按邮件行动。文字变化和行为后果之间,还隔着人。
如果老师想把它变成课堂练习,可以先请双语读者根据原文回答两个问题:事情已经确定了吗,哪些条件还没满足?再让另一批读者只看译文回答同样问题。最后才让双语读者指出具体哪几个字造成差异。这是未执行的建议;要比较两版,最好让每个人只先看到其中一版,避免看过原文后替译文补意思。
更细一点,可以将“读起来是否自然”单独问,把“是否保证发生”另列一题。这样才可能看到一种有用的结果:两版都很自然,但对承诺的理解不同。也要容许另一种结果:双语读者自己就对原文意见不一。此时答案不该强行统一成某个模型的解释,而应该记录争议发生在哪一处,并寻找能消除歧义的背景信息。
研究者还需关心谁来评价。熟悉两种语言的译者能定位错处,只懂目标语言的人更接近日常使用者;两者承担的任务不同。学生、家长、文学译者也不是可随意互换的样本。几段小说的评价,既不证明某个孩子会误读,也不证明某种提示词能普遍改善阅读理解。
今天就能做的一次三分钟核对
选一段确实要用、又不涉及高风险决定的短文。先在译文旁写下自己的理解:“已确认”“只是预计”或“原文未说明”。再回到原文,只找支撑这项判断的短语,连前后一句一起看。可以请 AI 标出对应表达,但它给出的解释仍需与原句核对,不能让同一个解释自动成为自己的证明。
接着做一个反例检查:假如事情没有发生,原话算不算被违背?“可能周五收到”和“周五一定收到”,对这个问题的回答不同。若你不懂源语言,就把原句、上下文和这个具体疑问交给懂两种语言的人,比笼统问“翻得好不好”更容易得到可核对的回应。这里没有承诺三分钟能解决所有歧义;练习的目标只是找出最值得追问的一处。
还可以给这次核对留一张很小的记录:原句是什么,译文是什么,你最初以为对方保证了什么,回看后改了什么。无需给整篇打一个总分。下次再遇见同类表达,先翻这张记录,看看新句子的说话人、场景和前提是否相同。如果不同,就重新判断,别把上次的译法变成机械替换规则。这份记录的作用是让自己的理解有据可查,并不构成对某个模型的正式评测。
最后只修改已经查清的地方。不要给整段统一撒上“也许”“不一定”,也不要为了中文干脆而删掉全部保留。需要保留的是原作者的判断强度:他确定到哪里,你就译到哪里。孩子问 may 的那一刻,最有价值的下一步不是重新生成一封更漂亮的邮件,而是一起确认,周五之前究竟有什么已经说定了。
参考资料
- O. Y. Karachina,2026,An Evaluation of the Effectiveness of Online Services and Artificial Intelligence Systems in the Translation of Modal Constructions from Russian into English,Russian Linguistic Bulletin 第6(78)期,6月9日正式发表;重点见方法、结果与讨论。
- Marzena Karpińska、Mohit Iyyer,2023,Large Language Models Effectively Leverage Document-level Context for Literary Translation, but Critical Errors Persist,WMT 正式论文;见第三至六节、图五及表二。
- Gongbo Tang、Philipp Rönchen、Rico Sennrich、Joakim Nivre,2021,Revisiting Negation in Neural Machine Translation,TACL 第9卷正式论文;见第三节、第四节及表五、表六。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。