大模型研究爭議:AI 走進日常之後
孩子收到交流活動的英文郵件,讓 AI 翻成中文。你掃了一眼:“參加者週五之前會收到分組信息。”於是放心等通知。孩子卻指著原文問:這裡的 may,是不是隻說可能收到?這是一個自擬情境,不是實測案例。第一層回答很簡單:中文沒有病句,不代表原來的承諾還在。收件時間譯對了,誰發通知也譯對了,仍可能把“可能發生”變成“已經保證”。
但反過來也不能見到英文裡的一個小詞在中文裡消失,就判定翻譯失真。譯成“預計週五前發出”,未必還需要另加一個“可能”;譯成“週五前一定發出”,才明顯提高了確定程度。今天要查的不是兩種語言有沒有逐字對應,而是看完譯文的人,會不會比看原文的人多相信一件原話沒保證的事。
一句話順不順,和它答應了什麼
先把三種判斷拆開。讀起來是否自然,可以由熟悉中文的人判斷;意思有沒有變,需要對照兩種語言;讀者最後理解成什麼,還得讓讀者作答。一個人在前一項給出高分,並沒有順手完成後兩項。這也是不懂原文時最難的一步:我們能感到中文流暢,卻缺少發現語義變化的參照。
還要分清“小詞”究竟在做什麼。自擬例句“你可以提前進教室”,可能是在說允許,也可能是在說門開著、條件允許;“他應該到了”,可能是根據路程作推測,而不是規定他有到場義務。只讓模型把所有 should 換成“應該”,保住了字面,卻可能沒有保住說話人的意思。問一句“誰允許的,還是誰推測的”,往往比數情態詞更接近問題。
因此至少有兩種可區分的解釋。第一種是語義真的被改強了:原話保留了不發生的可能,譯文把它封死。第二種是表達方式改變了:不確定性換到“預計”“據目前安排”或上下文裡,意義仍在。另有一種值得單列的情況:原句本來就含糊,譯者選了一種讀法。那需要補上下文,不能靠中文更漂亮來裁定。
這些解釋會導向不同的修改。真被改強,就恢復原來的保留;換了表達但意義沒變,不必硬塞重複的“可能”;上下文不足,就保留歧義或請發信人說明。翻譯不是把一句話改得越謹慎越好。原文明明已經確認,譯文擅自加“不一定”,同樣可能讓讀者誤判。
近期研究看見了問題,也留下了賬沒算清
Karachina 在二〇二六年發表的研究專門檢查俄譯英的情態表達。材料是一百六十句,按四類情態各選四十句,包括選取的語句和作者構造的語句;它不是對日常翻譯請求的隨機抽樣。研究把傳意、語法、風格和情態類別等分開評判,列出的錯誤包括把一種情態換成另一種,以及沒有傳出情態意義。它支持“值得單獨檢查”,不能給中文郵件提供一個通用出錯率。
讀這篇時尤其要壓住抄排行榜的衝動。方法節把五項評分彙總成百分比,結果節又使用“正確翻譯”的說法;如果不知道具體分母,就不應把數字寫成一百封郵件裡有多少封譯對。正文僅稱 ChatGPT,沒有足以鎖定後臺模型的版本標識;不同平臺的“改進”操作也不完全相同。本文因此不轉述其優劣排名。能從這份近十二個月的一手研究帶走的,是把語法與情態分開查的辦法,而不是哪個服務今天最可靠。
這不是挑剔論文格式。假設一份譯文語法、風格都很好,只把“可能”改成“必然”,綜合得分仍可能顯得不錯;而另一份譯文用詞生硬,卻準確保留了保留態度。對準備按郵件辦事的家長,這兩種錯誤的意義不同。這裡是假設性說明,沒有給研究重新算分,也沒有聲稱它的某個樣本正好如此。
最能改變判斷的對照:給同一句話補上前後文
Karpińska 和 Iyyer 的文學翻譯研究用同一個 text-davinci-003 模型,比較只給單句、提供整段但逐句翻譯、以及整段翻譯三種設置。人工評價覆蓋十八個語言方向、一百八十個原文段落;評價者對照原文標出錯誤,再比較譯文優劣。這測的是機器譯文質量,由人來判,不是測學生讀完能考多少分。
論文圖五中,整段翻譯相對“看整段但逐句譯”獲得約三分之二的偏好票。但表二同時顯示,兩種設置的誤譯計數接近,整段譯並非每一項都最好。這個對照比簡單比較兩個品牌更有解釋力:看得到上下文,以及允許把整段組織成目標語言,是兩個可分開的條件。研究仍發現漏譯等問題;文學文本和舊模型的結果也不能直接搬成今天中文通知的成績。
把這一點放回郵件,可以設計一個未執行的小對照。先只翻“你應該週五到達”,再補上前句“我算過列車時間了”,最後換成“參加者須遵守以下報到安排”。後兩版改變了信息,不能拿它們的不同譯法證明模型不穩定。恰恰相反,合理譯者應當讓前一種更像推測,後一種更像要求。只有原文和語境保持不變時,才能進一步追問哪個譯法無端改了強弱。
這也解釋了為什麼“只改一個詞”有時不公平。如果你先把原文的 maybe 刪掉,再責怪兩次譯文不同,測試的已經不是忠實程度,而是模型有沒有跟隨信息變化。真正有用的控制是保留原文,把兩份候選譯文放在一起,只改確定程度,再請懂兩種語言的人指出哪份額外許諾了什麼。
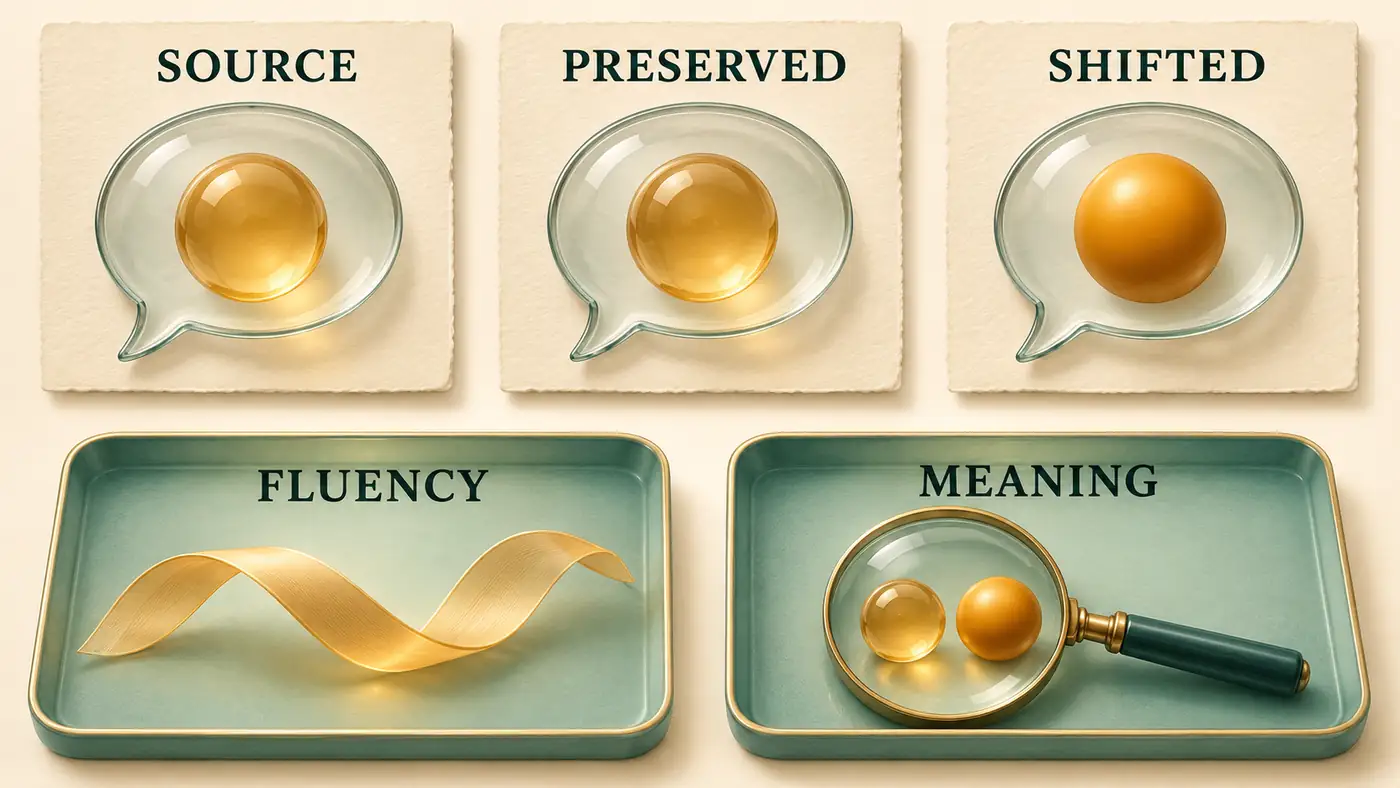
方法示意:同一原文對應兩份候選譯文,比較語氣強弱;下方分開檢查流暢度和意義。球的透明度只是概念符號,沒有概率刻度;圖中沒有因果箭頭,也不是論文測量結果。
“不”還在,也可能已經否定錯了地方
確定程度之外,另一個容易藏進順暢句子的變化是否定範圍。看兩句自擬中文:“不是每個學生都要發言”和“每個學生都不要發言”。都有“每個學生”和“不”,讀者得到的安排卻完全不同。前一句不要求人人發言,後一句要求人人不發言。只檢查否定詞有沒有留下,會把這個區別放過去。
Tang 等人的經典研究研究的是神經機器翻譯,不是今天的聊天大模型。其英德人工評估在兩個方向各抽二百五十句,英中使用帶否定標註的 NegPar 材料。表五區分保留否定詞、換一種說法仍準確、範圍錯位、意思錯誤和遺漏。表六把準確改述也算作正確。因此沒有對應的“不”不必然算錯,有“不”也不保證對。
這篇還明確區分兩類測試:讓模型給正確譯文與人為改錯的譯文打分,以及檢查模型真正生成的譯文。前者像一道選擇題,後者像獨立寫答案;前者過關不能代替後者。本文借用它的評估區分,不把舊系統的正確率當作現有產品表現,也不把模型選對的比例寫成雙語讀者理解正確的比例。
對普通讀者,否定範圍可以用一句追問檢查。看到“不是所有活動都需要報名”,就問“有沒有不報名也能參加的活動”;看到“所有活動都不需要報名”,就問“哪一項還要求報名”。這只是幫助找出語義差異的例子;真實通知若還有其他條件,不能靠一條孤立句子決定參加資格。完整段落仍是判斷的依據。
把“讀者理解”補進來,還缺一次什麼實驗
上面三份研究沒有共同完成這樣一個實驗:把同一封英文郵件的不同中文譯文隨機給中文家長,記錄他們對發信人承諾的理解。不能從譯文裡找到一處語氣變化,直接跳到“家長一定會因此安排錯時間”。有人可能看得出不確定,有人可能另問老師,也有人原本就不會按郵件行動。文字變化和行為後果之間,還隔著人。
如果老師想把它變成課堂練習,可以先請雙語讀者根據原文回答兩個問題:事情已經確定了嗎,哪些條件還沒滿足?再讓另一批讀者只看譯文回答同樣問題。最後才讓雙語讀者指出具體哪幾個字造成差異。這是未執行的建議;要比較兩版,最好讓每個人只先看到其中一版,避免看過原文後替譯文補意思。
更細一點,可以將“讀起來是否自然”單獨問,把“是否保證發生”另列一題。這樣才可能看到一種有用的結果:兩版都很自然,但對承諾的理解不同。也要容許另一種結果:雙語讀者自己就對原文意見不一。此時答案不該強行統一成某個模型的解釋,而應該記錄爭議發生在哪一處,並尋找能消除歧義的背景信息。
研究者還需關心誰來評價。熟悉兩種語言的譯者能定位錯處,只懂目標語言的人更接近日常使用者;兩者承擔的任務不同。學生、家長、文學譯者也不是可隨意互換的樣本。幾段小說的評價,既不證明某個孩子會誤讀,也不證明某種提示詞能普遍改善閱讀理解。
今天就能做的一次三分鐘核對
選一段確實要用、又不涉及高風險決定的短文。先在譯文旁寫下自己的理解:“已確認”“只是預計”或“原文未說明”。再回到原文,只找支撐這項判斷的短語,連前後一句一起看。可以請 AI 標出對應表達,但它給出的解釋仍需與原句核對,不能讓同一個解釋自動成為自己的證明。
接著做一個反例檢查:假如事情沒有發生,原話算不算被違背?“可能週五收到”和“週五一定收到”,對這個問題的回答不同。若你不懂源語言,就把原句、上下文和這個具體疑問交給懂兩種語言的人,比籠統問“翻得好不好”更容易得到可核對的回應。這裡沒有承諾三分鐘能解決所有歧義;練習的目標只是找出最值得追問的一處。
還可以給這次核對留一張很小的記錄:原句是什麼,譯文是什麼,你最初以為對方保證了什麼,回看後改了什麼。無需給整篇打一個總分。下次再遇見同類表達,先翻這張記錄,看看新句子的說話人、場景和前提是否相同。如果不同,就重新判斷,別把上次的譯法變成機械替換規則。這份記錄的作用是讓自己的理解有據可查,並不構成對某個模型的正式評測。
最後只修改已經查清的地方。不要給整段統一撒上“也許”“不一定”,也不要為了中文乾脆而刪掉全部保留。需要保留的是原作者的判斷強度:他確定到哪裡,你就譯到哪裡。孩子問 may 的那一刻,最有價值的下一步不是重新生成一封更漂亮的郵件,而是一起確認,週五之前究竟有什麼已經說定了。
參考資料
- O. Y. Karachina,2026,An Evaluation of the Effectiveness of Online Services and Artificial Intelligence Systems in the Translation of Modal Constructions from Russian into English,Russian Linguistic Bulletin 第6(78)期,6月9日正式發表;重點見方法、結果與討論。
- Marzena Karpińska、Mohit Iyyer,2023,Large Language Models Effectively Leverage Document-level Context for Literary Translation, but Critical Errors Persist,WMT 正式論文;見第三至六節、圖五及表二。
- Gongbo Tang、Philipp Rönchen、Rico Sennrich、Joakim Nivre,2021,Revisiting Negation in Neural Machine Translation,TACL 第9卷正式論文;見第三節、第四節及表五、表六。
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。