大模型研究争议:AI 走进日常之后
班刊收到一篇写校运会的稿子。小编辑圈出最后一句“那一刻,我明白了坚持的意义”,在旁边打了个问号。这个结尾她太熟了,昨晚让 AI 写运动会范文,它也这么收尾。可坐在旁边的同学说,小学老师教他们升华主题,全班有一半的人都会这样写。要是把作者名字折起来,单凭这一句,你愿意把稿子退回去吗?
这是一个设想。两位同学都认出了某种写法,争议发生在下一步。同一句套话,既可能来自模型学到的范文,也可能来自学生练了好几年的作文格式。读者有时确实能从文章里辨出来源,尤其当桌上还有一份同题稿可供比较。但如果手里只有这一篇,最要紧的问题就成了:在那些你觉得“很像”的稿子里,有多少原本就是人写的?
把旁边那份稿子拿走
想象桌上还有一篇同题来稿。第一篇用三段话赞美运动精神,第二篇写接力棒掉在了哪条跑道上,谁第一次没捡起来。假如事先有人告诉你,其中恰好一篇是模型写的,你可能选第一篇。现在把第二篇抽走。第一篇一个字也没变,你却失去了一条相当有用的信息:你再也不能靠排除另一篇来作答。这个小动作,也是读辨认研究时值得在脑子里做的一次对照。
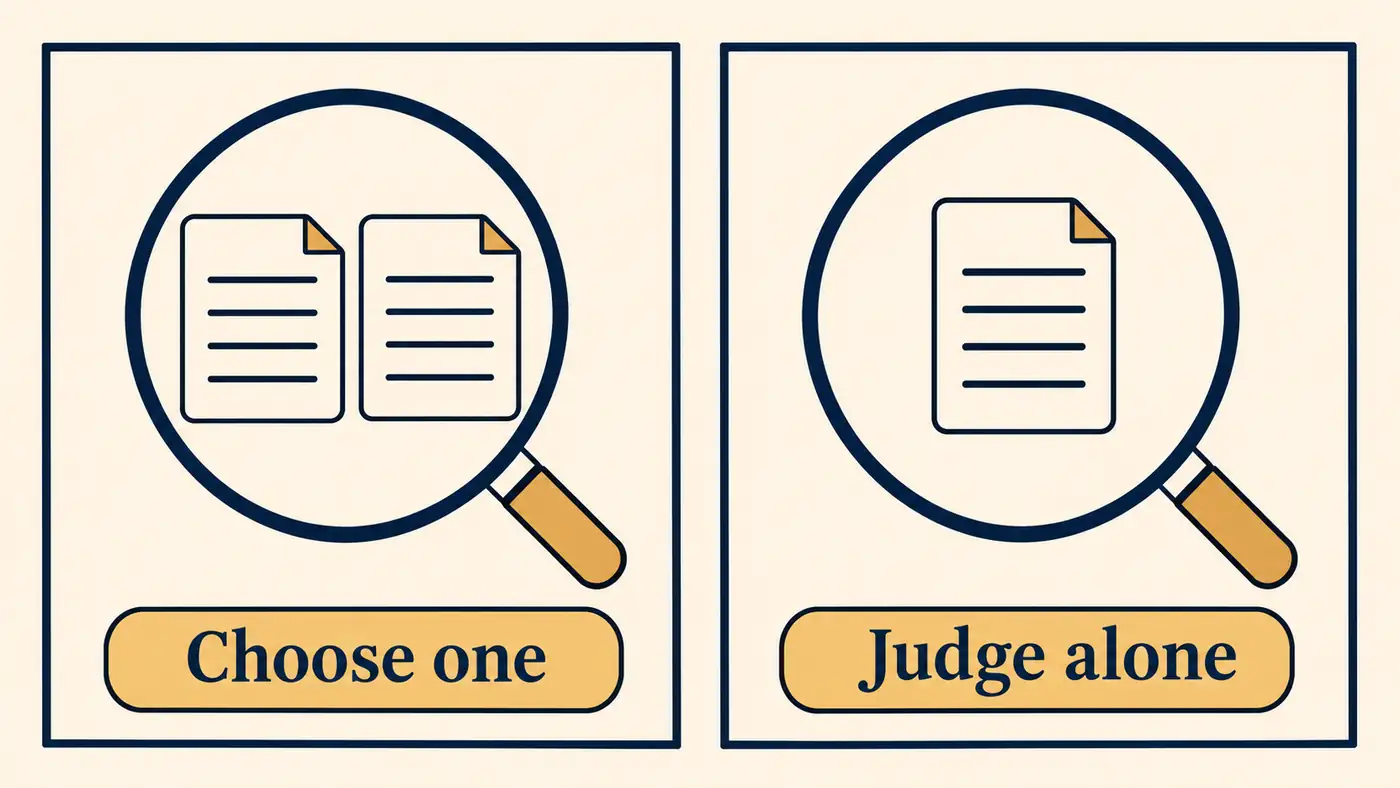
图示两种读题条件。左边已知两篇各来自一方,右边要独立判一篇。画面并列,无先后箭头,也不表示两种条件的实测得分。
Wang 等人在 ACL 发表的研究把这种区别直接写进了给读者的题面。表二列了四种任务,其中一种要从一对文本里选出人写的那篇,另一种虽然也给两篇,却允许“两篇都是”或“两篇都不是”。后一种题里,哪怕第一篇露出明显线索,读者也得回头看第二篇。还有一种干脆只给单篇。研究中的多数标注采用了已知一人一机的配对题。原文表二与第 3.4 节
这篇论文给“我确实能看出来”留下了位置。研究找来十九位有自然语言处理经验、熟悉模型文本的标注者,让他们读自己母语的材料。九种语言、十六套数据上,作者报告的简单平均正确率是 87.6%。这是不同标注设置的正确率取平均。它不能拿去给一张陌生来稿盖章,说作者有这么大的概率是人,更没有为每个普通读者测出一份成绩。研究方法及表三
中文学生作文尤其值得细看。如果一切都靠“已知一人一机”这条提示,那么允许两篇同源之后,辨认理应变得很吃力。然而表三里,配对二选一的那行是 98.0%,允许两篇都出自同一方的那行仍有 97.0%。这给“全靠猜题技巧”提供了一个反例,也给结论划了边界。两行用的样例数不同,标注者配置不同,有没有预先看带答案的例子也不同。不能把两个数相减就说,去掉提示的代价恰好是一个百分点。两行里读者面前也都还摆着两篇文章。表三中文作文两行
这里有两种说得通、又可以分开检验的解释。一是读者熟悉某类模型稿,确实认得它处理具体细节的习惯。二是两堆稿件在收集时就有区别,比如一堆要求限时写,另一堆允许慢慢改,读者认出了写作条件。后一个例子是方法上的设想。要区分两者,可以先让两方接到同一份现场笔记、篇幅要求和读者说明,再看原来的线索还剩多少。仅凭某个题库的高分,我们不知道换一套编辑要求后,原来押中的那个词还能帮多大忙。
有多少次,读者把人猜成了机器?
另一项叫 TURING 的研究,在公司内部搭了一个读稿页面。员工一次读一篇,可以选人、AI,也可以选“不知道”,提交后能看到答案。题库涵盖诗、食谱、演说等十种体裁。论文发在二〇二六年,但作者注明模型稿生成于二〇二四年年中。拿论文的发表年份当成受测模型的年份,会把这场辨认推迟近两年。原文第 2 节及表一
研究收到了二百一十四人的九千多次判断。分析时先剔除“不知道”和没有有效阅读时间的回答,再处理读得过快的记录,最后留下 7943 次判断,正确率为 59.3%。这里的一次是某个人对某段文字作答,同一人会贡献多次回答,同一篇也能被不同人读到。它既不是七千多位读者的投票,也没有告诉我们一个从未得到答案反馈的人第一次扫一眼会怎样。第 3.1、3.2 节
“不知道”值得单独留一行。设想两位编辑读相同的十篇稿,一位每篇都猜,另一位只对最有把握的两篇表态。即使后一位两篇全对,也还得问剩下八篇怎么办。如果编辑部允许把难判的稿件交还作者说明,暂缓判断本身就有用。如果要求每篇当天定稿,前面那份只在表态时计算的成绩就少算了一部分工作。读到一个正确率,先找一找有多少次判断根本没进分母,再决定这个数字能回答哪个实际问题。
对班刊编辑更有用的是图二。沿着已知由人写的那一行读,有 37.3% 的判断把稿子判成 AI;沿着模型稿那一行读,有 43.6% 把它判成人。前一个数回答“给你人稿,会错怪多少”,后一个数回答“给你模型稿,会放过多少”。两种错可以同时很多。若只记得某次自己准确挑出了一篇模型稿,记忆里缺的恰恰是那些同样让自己起疑、后来却没机会揭晓的人稿。原文图二及第 3.2 节
体裁也会改变这道题。在同一项研究中,只看模型稿,人们认出小说片段的比例约为四成四,认出新闻文章的比例约为七成。读者在这里要辨认的是这批来源和模型下的样本。别由此给体裁贴上永久的难易标签,采样的篇幅、题目和生成方式都可能随着换一份题库而变。也不能拿这份单篇研究和前面的多语种研究相减,给专家训练标出收益。要测训练,得让起点可比的读者面对同一套事先留出的新稿,并控制他们得到的反馈。第 3.2 节及表一
七个检测器点头,算七份证据吗?
把作文交给软件,就换了一位作答者。Liang 等人研究过七种当时可用的检测器。作者收集了中文论坛上的九十一篇英语托福作文,并取了美国八年级学生的八十八篇作文作比较。两组都按人写的材料来测。所以,只要一个工具在这里报出“AI”,研究者就能记下一次误报,根本不用先造一篇高仿的机器作文。作者全文及图一
九十一篇托福文里,有八十九篇至少被一个工具标过;有十八篇同时被七个工具标过。前者相当于编辑说“只要有一个报警我就拦下”,后者相当于“我要等所有工具都报警”。把门槛从一个改成七个,拦下的人稿少了,但那十八篇并没有因此换作者。它们也不能用来算七个工具会共同漏掉多少机器稿,因为这九十一篇里没有机器稿。图一及正文结果
为什么托福作文容易吃亏?一种可能是考试写作鼓励稳妥、常见的表达,而词句好不好预测恰好是某些检测方法关注的线索。作者还让模型改动原作文的用词,检测结果随措辞变化。读这个对照要留心,改写后的版本已经经过模型处理,不能继续拿它当作纯人写的原件。两个原始作文集也来自不同渠道,作者年龄、写作任务等条件没有逐人配平。研究揭示了特定工具在这些英语作文上的误报,无法单独量出母语背景的因果效应,更不能替今天的中文班刊报一个误报率。作者全文图一
收稿箱里本来有多少机器稿?
下面是方便心算的假设,数字没有取自论文。设一种辨认办法能抓到九成机器稿,也会把一成人稿错标。一百篇来稿中若有五十篇机器稿,它会标出四十五篇机器稿和五篇人稿。编辑抽一篇被标记的稿子,猜它来自机器,猜中的机会是九成。把同一办法用到另一百篇上,这回只有十篇机器稿,它会抓到九篇,也会错标九篇人稿。在这十八个警报里,只有一半指中了机器稿。
两次的辨认本事完全一样,编辑看到红灯后该有的把握却不同。原因只在收稿箱:第二回可供错标的人稿足足有九十篇。当你问“这篇被标红,真是机器写的可能性有多大”,分母是所有亮红灯的稿子。当工具报告“在人稿中很少亮红灯”,分母是所有已知人稿。就算后一句确有依据,也还差真实来稿的组成,才能走到前一句。实际班刊连这个组成往往都不知道。
还有一些稿子从收进来起,就放不进那两个筐。学生自己采访,让助手把口语整理通顺,又把末段重写,究竟该给整篇填哪个标签?若班刊关心的是现场有没有这场接力赛,采访对象和笔记可以核对。若老师关心的是学生能不能独立写出结尾,就请他解释为什么留下这一句,或给同一场比赛另写一个收尾。两个问题各有能查的东西。硬给这篇稿子报一个二元判断,只会把尚未说清的写作约定伪装成已有标准答案的考题。
下次圈出一句套话时
可以和朋友做个小练习,以下是未执行的建议。请对方找几段来源能核实、允许拿来玩的短文,另备同题同体裁的模型稿,统一字号,去掉署名。先单篇给你看,不提前说各有几篇。每读一篇,写下理由,例如“结尾概括得很大,没提谁接棒”,再写下什么发现会让你改判。留一栏给“不知道”,把它也保留下来。揭晓时,专门翻回你最有把握却猜错的那篇,看看理由是不是仍然可以逐字用在它身上。
如果还想知道参照稿帮了什么,可以另备一批材料,让两位读者分头读;一位看同题配对,一位看拆散的单篇,再在下一批互换任务。别让一个人刚看过答案就拿原题重测。记录双方错怪了几次人稿、漏掉几次机器稿、放弃判断几次。几篇的小练习只够找出自己用错的一条理由,谈不上估计全班的准确率。回到开头,即便永远查不到那句“坚持的意义”是谁先写出来的,编辑依旧可以在旁边写一条有用的批注:“接力棒掉下去的时候,你站在哪里,看到了什么?”
参考资料
- Yuxia Wang 等,2026,ACL 正式长文。Is Human-Like Text Liked by Humans? Multilingual Human Detection and Preference Against AI
- Natalia Kalashnikova、Nicolas De Bufala、Sophie Fayad、Laurent Cervoni,2026,LREC 正式会议论文。TURING: Evaluating Human Abilities to Identify AI-Generated Texts
- Weixin Liang、Mert Yuksekgonul、Yining Mao、Eric Wu、James Zou,2023,发表于 Patterns。期刊版 · 作者全文
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。