大模型研究爭議:AI 走進日常之後
班刊收到一篇寫校運會的稿子。小編輯圈出最後一句“那一刻,我明白了堅持的意義”,在旁邊打了個問號。這個結尾她太熟了,昨晚讓 AI 寫運動會範文,它也這麼收尾。可坐在旁邊的同學說,小學老師教他們昇華主題,全班有一半的人都會這樣寫。要是把作者名字折起來,單憑這一句,你願意把稿子退回去嗎?
這是一個設想。兩位同學都認出了某種寫法,爭議發生在下一步。同一句套話,既可能來自模型學到的範文,也可能來自學生練了好幾年的作文格式。讀者有時確實能從文章裡辨出來源,尤其當桌上還有一份同題稿可供比較。但如果手裡只有這一篇,最要緊的問題就成了:在那些你覺得“很像”的稿子裡,有多少原本就是人寫的?
把旁邊那份稿子拿走
想像桌上還有一篇同題來稿。第一篇用三段話讚美運動精神,第二篇寫接力棒掉在了哪條跑道上,誰第一次沒撿起來。假如事先有人告訴你,其中恰好一篇是模型寫的,你可能選第一篇。現在把第二篇抽走。第一篇一個字也沒變,你卻失去了一條相當有用的信息:你再也不能靠排除另一篇來作答。這個小動作,也是讀辨認研究時值得在腦子裡做的一次對照。
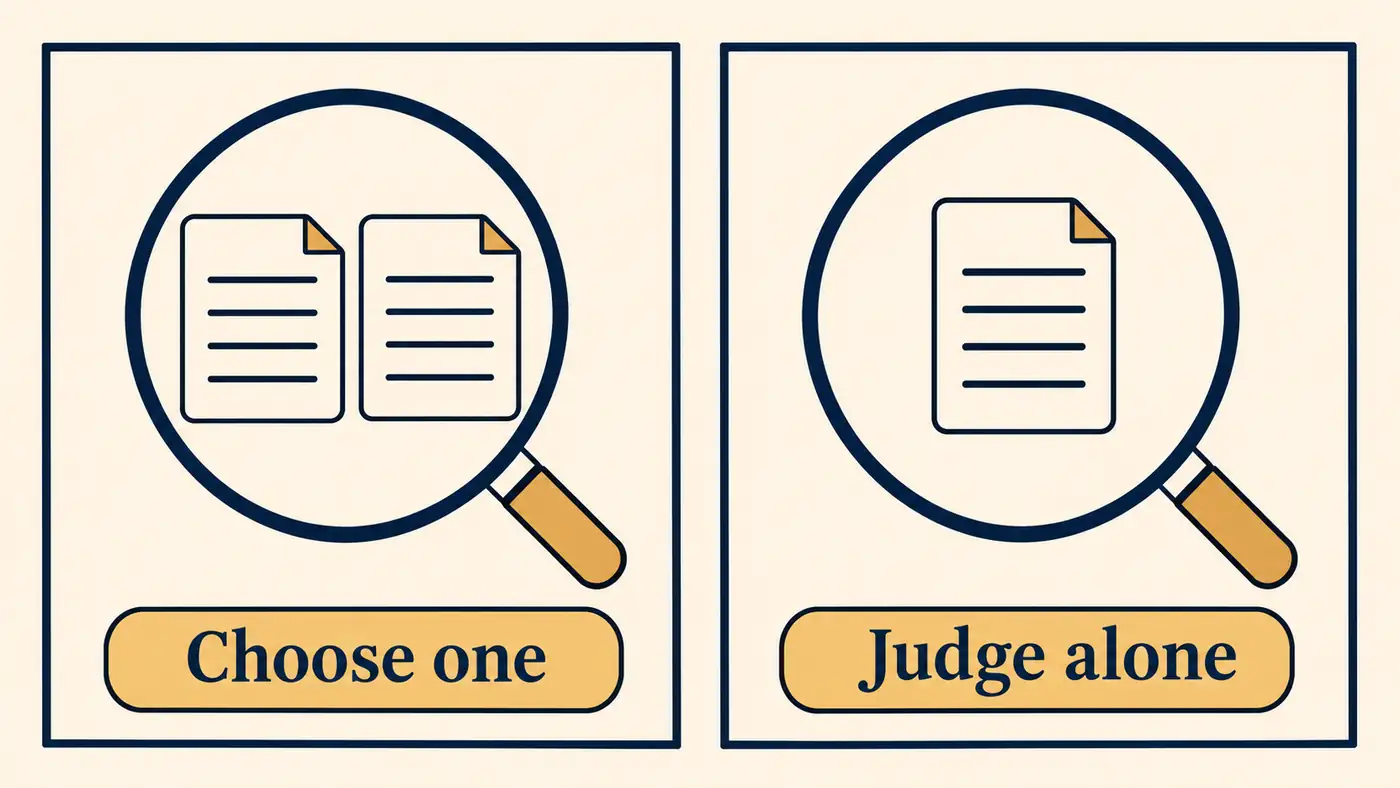
圖示兩種讀題條件。左邊已知兩篇各來自一方,右邊要獨立判一篇。畫面並列,無先後箭頭,也不表示兩種條件的實測得分。
Wang 等人在 ACL 發表的研究把這種區別直接寫進了給讀者的題面。表二列了四種任務,其中一種要從一對文本里選出人寫的那篇,另一種雖然也給兩篇,卻允許“兩篇都是”或“兩篇都不是”。後一種題裡,哪怕第一篇露出明顯線索,讀者也得回頭看第二篇。還有一種乾脆只給單篇。研究中的多數標註採用了已知一人一機的配對題。原文表二與第 3.4 節
這篇論文給“我確實能看出來”留下了位置。研究找來十九位有自然語言處理經驗、熟悉模型文本的標註者,讓他們讀自己母語的材料。九種語言、十六套數據上,作者報告的簡單平均正確率是 87.6%。這是不同標註設置的正確率取平均。它不能拿去給一張陌生來稿蓋章,說作者有這麼大的概率是人,更沒有為每個普通讀者測出一份成績。研究方法及表三
中文學生作文尤其值得細看。如果一切都靠“已知一人一機”這條提示,那麼允許兩篇同源之後,辨認理應變得很吃力。然而表三里,配對二選一的那行是 98.0%,允許兩篇都出自同一方的那行仍有 97.0%。這給“全靠猜題技巧”提供了一個反例,也給結論劃了邊界。兩行用的樣例數不同,標註者配置不同,有沒有預先看帶答案的例子也不同。不能把兩個數相減就說,去掉提示的代價恰好是一個百分點。兩行裡讀者面前也都還擺著兩篇文章。表三中文作文兩行
這裡有兩種說得通、又可以分開檢驗的解釋。一是讀者熟悉某類模型稿,確實認得它處理具體細節的習慣。二是兩堆稿件在收集時就有區別,比如一堆要求限時寫,另一堆允許慢慢改,讀者認出了寫作條件。後一個例子是方法上的設想。要區分兩者,可以先讓兩方接到同一份現場筆記、篇幅要求和讀者說明,再看原來的線索還剩多少。僅憑某個題庫的高分,我們不知道換一套編輯要求後,原來押中的那個詞還能幫多大忙。
有多少次,讀者把人猜成了機器?
另一項叫 TURING 的研究,在公司內部搭了一個讀稿頁面。員工一次讀一篇,可以選人、AI,也可以選“不知道”,提交後能看到答案。題庫涵蓋詩、食譜、演說等十種體裁。論文發在二〇二六年,但作者註明模型稿生成於二〇二四年年中。拿論文的發表年份當成受測模型的年份,會把這場辨認推遲近兩年。原文第 2 節及表一
研究收到了二百一十四人的九千多次判斷。分析時先剔除“不知道”和沒有有效閱讀時間的回答,再處理讀得過快的記錄,最後留下 7943 次判斷,正確率為 59.3%。這裡的一次是某個人對某段文字作答,同一人會貢獻多次回答,同一篇也能被不同人讀到。它既不是七千多位讀者的投票,也沒有告訴我們一個從未得到答案反饋的人第一次掃一眼會怎樣。第 3.1、3.2 節
“不知道”值得單獨留一行。設想兩位編輯讀相同的十篇稿,一位每篇都猜,另一位只對最有把握的兩篇表態。即使後一位兩篇全對,也還得問剩下八篇怎麼辦。如果編輯部允許把難判的稿件交還作者說明,暫緩判斷本身就有用。如果要求每篇當天定稿,前面那份只在表態時計算的成績就少算了一部分工作。讀到一個正確率,先找一找有多少次判斷根本沒進分母,再決定這個數字能回答哪個實際問題。
對班刊編輯更有用的是圖二。沿著已知由人寫的那一行讀,有 37.3% 的判斷把稿子判成 AI;沿著模型稿那一行讀,有 43.6% 把它判成人。前一個數回答“給你人稿,會錯怪多少”,後一個數回答“給你模型稿,會放過多少”。兩種錯可以同時很多。若只記得某次自己準確挑出了一篇模型稿,記憶裡缺的恰恰是那些同樣讓自己起疑、後來卻沒機會揭曉的人稿。原文圖二及第 3.2 節
體裁也會改變這道題。在同一項研究中,只看模型稿,人們認出小說片段的比例約為四成四,認出新聞文章的比例約為七成。讀者在這裡要辨認的是這批來源和模型下的樣本。別由此給體裁貼上永久的難易標籤,採樣的篇幅、題目和生成方式都可能隨著換一份題庫而變。也不能拿這份單篇研究和前面的多語種研究相減,給專家訓練標出收益。要測訓練,得讓起點可比的讀者面對同一套事先留出的新稿,並控制他們得到的反饋。第 3.2 節及表一
七個檢測器點頭,算七份證據嗎?
把作文交給軟件,就換了一位作答者。Liang 等人研究過七種當時可用的檢測器。作者收集了中文論壇上的九十一篇英語託福作文,並取了美國八年級學生的八十八篇作文作比較。兩組都按人寫的材料來測。所以,只要一個工具在這裡報出“AI”,研究者就能記下一次誤報,根本不用先造一篇高仿的機器作文。作者全文及圖一
九十一篇託福文裡,有八十九篇至少被一個工具標過;有十八篇同時被七個工具標過。前者相當於編輯說“只要有一個報警我就攔下”,後者相當於“我要等所有工具都報警”。把門檻從一個改成七個,攔下的人稿少了,但那十八篇並沒有因此換作者。它們也不能用來算七個工具會共同漏掉多少機器稿,因為這九十一篇裡沒有機器稿。圖一及正文結果
為什麼託福作文容易吃虧?一種可能是考試寫作鼓勵穩妥、常見的表達,而詞句好不好預測恰好是某些檢測方法關注的線索。作者還讓模型改動原作文的用詞,檢測結果隨措辭變化。讀這個對照要留心,改寫後的版本已經經過模型處理,不能繼續拿它當作純人寫的原件。兩個原始作文集也來自不同渠道,作者年齡、寫作任務等條件沒有逐人配平。研究揭示了特定工具在這些英語作文上的誤報,無法單獨量出母語背景的因果效應,更不能替今天的中文班刊報一個誤報率。作者全文圖一
收稿箱裡本來有多少機器稿?
下面是方便心算的假設,數字沒有取自論文。設一種辨認辦法能抓到九成機器稿,也會把一成人稿錯標。一百篇來稿中若有五十篇機器稿,它會標出四十五篇機器稿和五篇人稿。編輯抽一篇被標記的稿子,猜它來自機器,猜中的機會是九成。把同一辦法用到另一百篇上,這回只有十篇機器稿,它會抓到九篇,也會錯標九篇人稿。在這十八個警報裡,只有一半指中了機器稿。
兩次的辨認本事完全一樣,編輯看到紅燈後該有的把握卻不同。原因只在收稿箱:第二回可供錯標的人稿足足有九十篇。當你問“這篇被標紅,真是機器寫的可能性有多大”,分母是所有亮紅燈的稿子。當工具報告“在人稿中很少亮紅燈”,分母是所有已知人稿。就算後一句確有依據,也還差真實來稿的組成,才能走到前一句。實際班刊連這個組成往往都不知道。
還有一些稿子從收進來起,就放不進那兩個筐。學生自己採訪,讓助手把口語整理通順,又把末段重寫,究竟該給整篇填哪個標籤?若班刊關心的是現場有沒有這場接力賽,採訪對象和筆記可以核對。若老師關心的是學生能不能獨立寫出結尾,就請他解釋為什麼留下這一句,或給同一場比賽另寫一個收尾。兩個問題各有能查的東西。硬給這篇稿子報一個二元判斷,只會把尚未說清的寫作約定偽裝成已有標準答案的考題。
下次圈出一句套話時
可以和朋友做個小練習,以下是未執行的建議。請對方找幾段來源能核實、允許拿來玩的短文,另備同題同體裁的模型稿,統一字號,去掉署名。先單篇給你看,不提前說各有幾篇。每讀一篇,寫下理由,例如“結尾概括得很大,沒提誰接棒”,再寫下什麼發現會讓你改判。留一欄給“不知道”,把它也保留下來。揭曉時,專門翻回你最有把握卻猜錯的那篇,看看理由是不是仍然可以逐字用在它身上。
如果還想知道參照稿幫了什麼,可以另備一批材料,讓兩位讀者分頭讀;一位看同題配對,一位看拆散的單篇,再在下一批互換任務。別讓一個人剛看過答案就拿原題重測。記錄雙方錯怪了幾次人稿、漏掉幾次機器稿、放棄判斷幾次。幾篇的小練習只夠找出自己用錯的一條理由,談不上估計全班的準確率。回到開頭,即便永遠查不到那句“堅持的意義”是誰先寫出來的,編輯依舊可以在旁邊寫一條有用的批註:“接力棒掉下去的時候,你站在哪裡,看到了什麼?”
參考資料
- Yuxia Wang 等,2026,ACL 正式長文。Is Human-Like Text Liked by Humans? Multilingual Human Detection and Preference Against AI
- Natalia Kalashnikova、Nicolas De Bufala、Sophie Fayad、Laurent Cervoni,2026,LREC 正式會議論文。TURING: Evaluating Human Abilities to Identify AI-Generated Texts
- Weixin Liang、Mert Yuksekgonul、Yining Mao、Eric Wu、James Zou,2023,發表於 Patterns。期刊版 · 作者全文
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。