大模型研究爭議:AI 走進日常之後
想像一道很普通的題:騎車去圖書館,去程慢、回程快,往返走的是同一條路。能把兩個速度加起來除以二嗎?你把題發給 AI。它講得很清楚,你跟著點頭,把答案寫進本子。第二天,老師只改了幾個字:這回不是去和回的路程相同,而是按兩種速度騎的時間相同。昨天抄下的那個解法,還該照用嗎?
這不是給學生設套。它讓人看見作業本上通常看不出的區別:順著別人的解答能讀懂,和沒有解答時知道第一步該做什麼,是兩種本事。 AI 可以幫到其中一種,也可能讓你恰好跳過原本打算練的那一種。判斷它有沒有幫你學會,值得看的是下一張白紙,而不只是眼前這張寫滿的紙。
同一間數學教室,寫完練習和參加考試是兩回事
在土耳其一所高中,研究者把近千名學生所在的班級分到三種條件。老師先複習大家學過的數學內容。接下來的練習,有的班用課本和筆記,有的可用一個能像普通聊天助手那樣答題的 GPT-4,還有的使用同一模型做的輔導版。練完後大家都合上資料和電腦,獨立在紙上做題。考試考的是剛練過的概念,題目相近,但不是抄回原答案就能交卷。Bastani 等,PNAS,實驗設計與表 1
把練習冊收上來,兩個 AI 組的成績都更好。故事如果到這裡就結束,普通聊天助手已經像一個成功的家教。可看下一份卷子,使用通用聊天版的班級,比未用 AI 的對照組低了約 5.4 個百分點。你可能見過這項研究被概括為“考試成績下降 17%”。兩個數並不衝突:對照組這份考試的平均得分率是 32.1%,論文裡的 17% 是相對此基線的差距,不是滿分一百的卷子少拿十七分,更不是每名學生都比自己上次退步。
輔導版的結果又不一樣。它被要求儘量給提示而非直接交答案,老師還為具體練習提供了正確解法、常見錯法和相應反饋。學生在練習時得到幫助,隨後獨立考試和對照組的差異沒有達到統計顯著。準確的讀法是:通用版出現的那種損失,在輔導版上沒有清楚出現;它並沒有在這場考試裡被證明優於課本和筆記。因為提醒方式和教師材料是一起變的,也不能把差別都歸功於一句“請別直接告訴我答案”。
假如你是家長,看到的通常只有作業這一端。孩子今天主動問了五個問題,也許是在比較解法,也許只是把五道題各貼了一遍。聊天次數一樣,本子也都寫滿。與其根據這兩件事表揚或指責,不如請孩子從中挑一道,把題裡的一個條件換掉,說說昨天的理由還能不能用。這才問到了練習的目的。
反過來,也別看到卷面分低就以為學生把原先掌握的知識全忘了。這項比較問的是:用兩種不同方式花掉同一段練習時間,之後哪一組做得更好?它沒有給每個人分別過一遍“有助手的人生”和“沒助手的人生”。一種可能是,助手沒帶走任何原有知識,只是佔用了本來可以用來練會那一步的時間。這和“工具讓人的智力變差”是兩件不同的事。
那些沒答對的題,有多少其實是沒再試?
一份白卷可以有兩種來歷:想了很久還不會,或者看到難題就點了跳過。兩者對下一次教學的意義不同。前者可能需要有人解釋一個概念,後者可能連展示已經會什麼的機會都沒有。網上一組關於分數計算和閱讀理解的實驗,專門給參與者留了“跳過”這個按鈕。Liu 等,COLM 2026,實驗一至三
其中第二次分數實驗做了一項細緻的修正:先讓所有人不靠助手做簡單題,再按同樣的前測規則篩選。這樣,一個本來不會算的人,不容易僅僅因為助手在練習階段給出了答案就被留在 AI 組裡。對照組也有一個側欄,只展示先前見過的解法;兩組到了測試階段都收起側欄。這樣一來,“有一組突然少了半個界面”就不再是兩組表現不同的一個明顯理由。
結果也比“用了 AI 就不願思考”有意思。在納入分析的 585 人裡,看最後三道無輔助題,先前有 AI 的一組平均答對率是 71%,對照組是 77%。但說到跳過,兩組分別約為 10% 和 7%,這次差異沒有達到通常的顯著標準。閱讀實驗的跳過差異更清楚,但它把不到五秒就交答案也記作跳過。這是在測眼前這道題上有沒有投入嘗試,不是在給一個人的毅力打終身分。實驗二圖 2、實驗三的方法與圖 4
還有個容易吸引人的細節:練習時自稱主要向 AI 要答案的人,在隨後的測試中表現較弱。但研究者隨機安排的是有沒有助手,不是讓誰必須索要答案、誰必須追問原理。一個本就著急結束任務的人,可能既愛問答案,也更容易跳題。這個結果值得拿來設計下一項研究,卻不適合用來判斷某個孩子的學習態度。實驗在撤掉助手後很快就測了,並不知道這些參與者過幾天會怎樣。
也有相反的結果:學習新知識,不總像刷數學題
如果 AI 只是拿走了練習機會,允許使用它的人在獨立測驗裡就不該佔優勢。可有些任務還有另一面:讀一段陌生材料,可能卡在一個詞上;一句說得通的解釋,能讓你回到原文,繼續讀下去。少花時間猜術語和少花時間想解題方法,都叫“省時間”,省掉的卻不是同一種活動。
Contractor 和 Reyes 讓本科生在限定時間內學習不熟悉的主題,例如碳捕集,再寫一篇分析短文。練習階段,一組可以像平常那樣用 AI,另一組不能;之後的知識測驗按規定兩組都不能查資料。約一週後,學生再回來,在沒有工具的條件下答題。這裡不是複習老師剛在黑板上示範過的解法,而是要在陌生材料中找出值得理解的關係。作者預印本,2026 年 10 月修訂版,實驗設計
這次,獲准用 AI 的一組在即時知識測驗中,估計的平均正確率反而高出 7.2 個百分點。一週後差距估計仍為正,約 3.9 個百分點,但後者沒有達到常用的 5% 顯著標準。還有一個影響解讀的細節:第一次測驗雖禁止查資料,研究者記錄到有違規,不能把即時優勢一概說成已經內化的知識。與其摘一句“效果保持了一週”,不如保留這個更有用的判斷:有條件下幫助確實可能到達獨立測驗,能持續多久、幅度多大,還不夠確定。修訂版表 4、第 4.2 節與注 19
兩篇課堂研究並沒有在回答完全相同的問題。數學課裡,寫出運算過程往往就是練習本身;陌生主題寫作裡,一段術語解釋也許讓你讀懂原先讀不進去的材料。學生年齡、學習任務、對照條件和測試時間也不同。沒有把這些條件拉齊,不能斷言“文科用 AI 就好,數學用就壞”。有用的追問是:它替我做的那一步,今天到底是需要清除的障礙,還是我來這裡要練的本領?
用畢業答辯作個類比。一個學生讓助手解釋論文裡的生詞,再回原文挑出最關鍵的比較;另一個讓助手挑出“最關鍵的比較”,自己只負責改句子。兩個人都可能在規定時間交出一頁像樣的講稿。現在請評委不看講稿,只問:“刪掉這個對照組,你的結論還能成立嗎?”第一個人練過這樣的判斷,第二個人未必練過。這個設想不預言誰一定答得好,它只是把原先藏在漂亮講稿裡的能力單獨拿出來看。
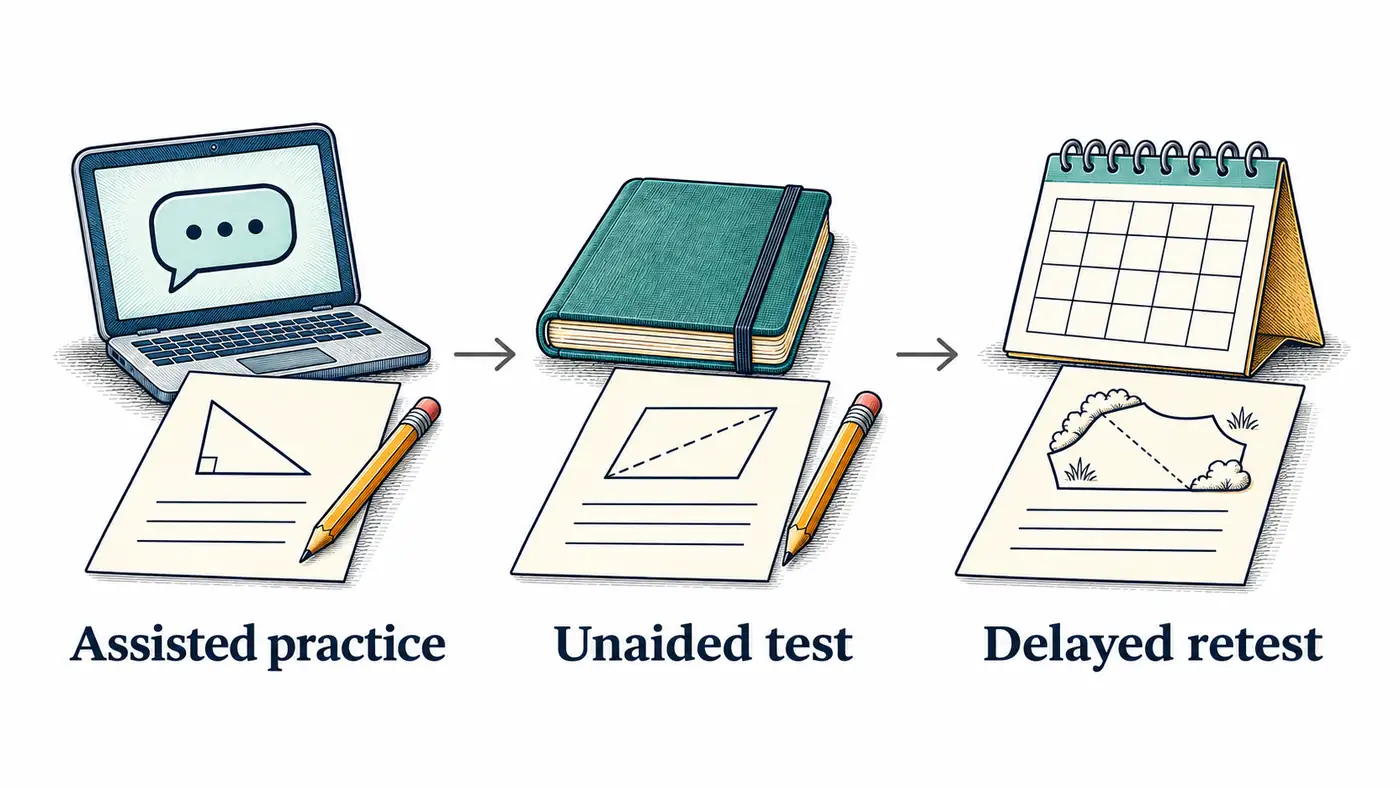
讀圖:從左到右是可以分別觀察的三個時點,不是三篇論文共同採用的流程。小紙張代表不同題目,箭頭只表示時間,不代表成績上升。
今晚可以怎麼試:保留一題,不讓 AI 看見
回到騎車題。兩段路程相等時,慢的那一程花的時間更長,所以全程平均速度更靠近慢速;如果花在兩種速度上的時間相等,兩種速度才各佔一半權重。你不必背兩個公式。下次只要能在動筆前問出“相等的是時間還是路程”,就抓住了決定方法的那個條件。這個例子是為了說明怎麼自查,不是上面任何一項實驗的原題。
一種可試的做法,是在打開聊天窗口前把練習分成兩份。一份可以問,另一份先折起來。對第一份,先寫下自己準備怎麼開始,哪怕只寫對了一個條件;真卡住了,把這句話給 AI 看:“我覺得去回的距離相等,所以兩個速度各佔一半。先別給答案,指出我把哪兩種量混在了一起。”等你能用自己的話回應,再請它反駁你一次。這裡有價值的不是某句萬能提示詞,而是你和它各自做過的判斷仍然分得清。
合上聊天窗口,再打開第二份。最好從課本或老師的題庫提前挑題,不拿模型剛照著例題改寫、順便暗示瞭解法的題。記三件事就夠了:能不能獨立寫出第一步;做錯時能不能定位是哪一個條件看反;隔天換一種問法,還能不能把道理講給別人聽。答不出來也有用,它告訴你應該回到哪一步,不必把整段標準答案重新抄一遍。偶爾連對兩題不是嚴密的個人實驗,別用它給自己貼“會了”或“離不開 AI”的標籤。
這套自查也有不必用的時候。明天就要交活動通知,你只想把集合地點和報名方式寫清楚,讓助手整理格式,再親自核實地址,是合理的分工;沒必要關掉電腦默寫通知來證明什麼。但如果今天練的是主持會議後獨立提煉要點,同一項代勞就跳過了你要學的事。可以在動手前把目標寫成一句話:“下次沒有它,我希望自己仍然能做的是……”寫不出這句話,先決定這次是在交一件成品,還是在學一項本領。
**給要設計研究的讀者:**比起再比一次“有 AI”和“沒 AI”,我更想看這樣的對照:用同一模型、同一套經核對的材料和相同練習時間,把學習者隨機分到直接解答、逐步提示和無助手三組。用未見過的獨立題做主要測量,另記跳過、做錯、答對;再隔一週,把表面情境換掉。如果提示組只在原題上佔優,就要考慮它教的是解題套路;如果獨立新題的表現也改善,才更支持學到了可遷移的東西。這是尚未執行的設計,不是本文新做的實驗。
所以,下次看到一份漂亮的 AI 作業,不必立刻問“這算不算作弊”,也不必把它當作教學成功的證明。換一道題,關掉窗口,把第一筆留給學習的人。那一筆比聊天記錄的長度更值得看。你最近一次請 AI 幫忙,有沒有哪一步是當時覺得懂了,後來才發現自己說不明白的?
參考資料
- Hamsa Bastani 等(2025),Generative AI without guardrails can harm learning: Evidence from high school mathematics,PNAS。實驗設計、主要結果及表 1。
- Grace Liu 等(2026),AI Assistance Reduces Persistence and Hurts Independent Performance,COLM 2026;作者全文 v6,第 2–4 節與侷限。
- Zara Contractor、Germán Reyes(2026),Experimental Evidence on the Learning Impact of Generative AI,arXiv 預印本 v2,10 月 4 日修訂;原文表 4 與研究設計。本文采用修訂版,不混用初稿數字。
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。