可信预测实验室:从模型置信度到可检验的拒答
给情感分类器八条带答案的影评,让它学一条规则,争取在以后的影评上把正确标签留在答案里。它给三百六十条审计影评一律同时返回正面和负面。再给它第九条校准影评,二百八十七条马上只剩一个答案。两次使用同一组模型输出,连最后一位小数都没有变。究竟是哪一步决定了可以排除一个标签?
先把这个现象拆成两个问题。第一,目标覆盖率定为九成时,八条能否给出有限的标准保形阈值?这个问题只要数位置就有答案。第二,拿到有限阈值后,有多少影评真的会少一个标签?这需要看模型、校准样本和审计样本的真实分数。把两个问题分开,才能判断哪些实验结果换一批数据仍可预言,哪些值得重新测量。
一张留给新样本的位置
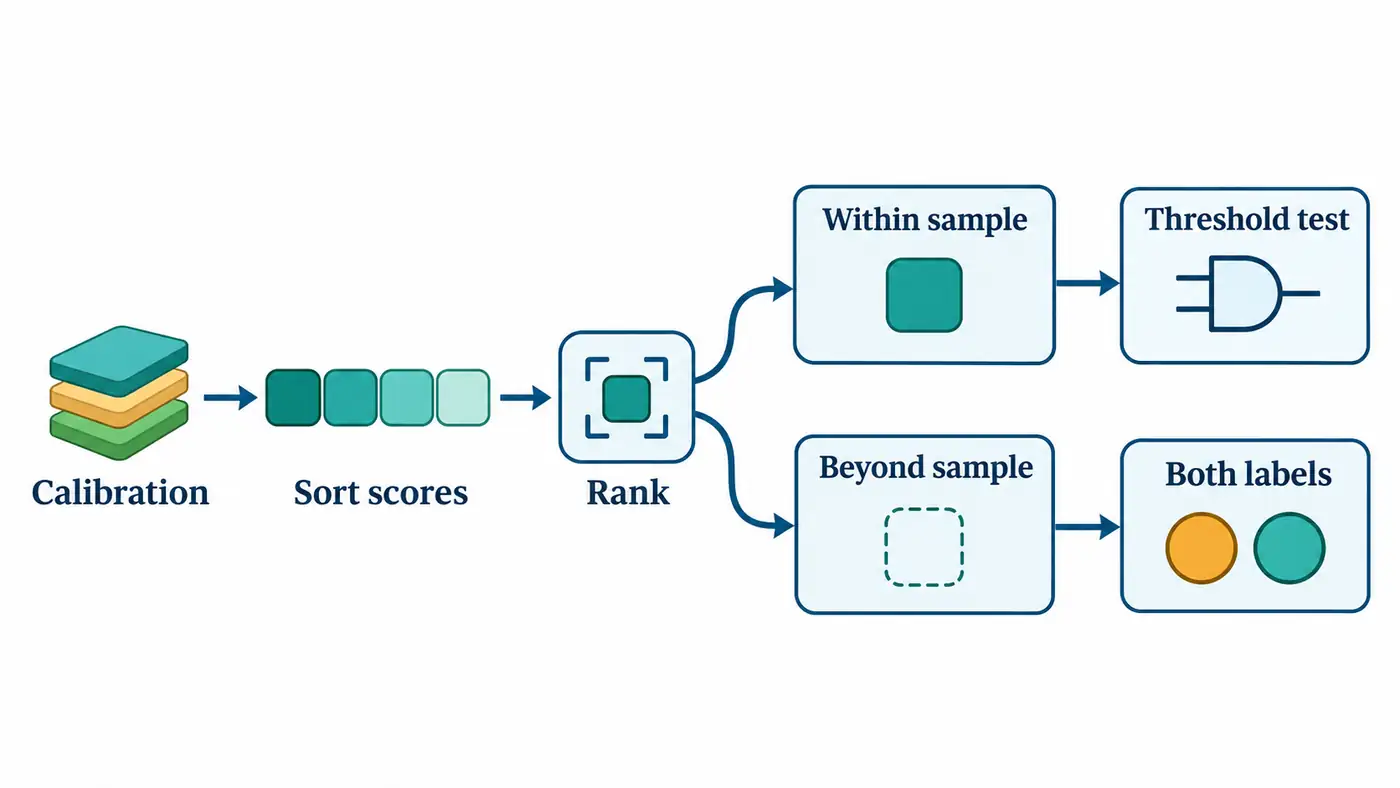
延续前文的分割保形预测。先固定已训练的分类器,把每个可能答案与输入之间的“不合适程度”写成分数。这里沿用 LAC,做法是从一减去模型给该标签的概率。用带标签的校准数据时,每句话只交出真标签对应的一个分数。预测新句子时,同时考察负面和正面两个候选,分数低于或等于阈值的都可以留下来。
这里 是输入影评, 是候选标签, 是两列模型输出经过归一化后分给该类的概率。 是带真标签的校准句数, 是允许的边际漏覆盖概率, 从一开始数,式中的上取整符号表示向上取整。阈值从小到大取第 个校准分数;如果这个位置超出校准表,就把阈值设成正无穷。这条规则对任何有限的候选分数都给出明确结果。
为什么要多算一个位置?在校准样本与下一条样本可交换、分数规则已经固定的条件下,可以想象先遮住哪一条是新来的,再把所有真标签分数一起排序。没有并列时,新样本在每个位置的机会相同。有并列时保留等号会把边界上的候选一起收下。覆盖定理约束的是对校准和未来样本共同取平均的概率;拿着已经抽出的八句话,无法从定理读出某条新影评的个体正确率。论文的论证也没有用到这三百六十条影评的观测频数。
八条校准分数加上一个新分数,一共九个可能位置。即使采用八条中最大的分数作阈值,在连续、可交换的理想情形下,也只能覆盖前八个位置,八除以九仍低于九成。为了够到目标必须把第九个位置也包括进来。校准表里没有第九个值,正无穷在这里有具体的操作含义,两个候选都会入集。改成九条校准时,共十个位置,只需覆盖前九个,取九条中的最大值就能做到。由此能预言阈值何时可以有限,却还不能预言集合会缩小多少。
最小实验与评测协议
上一次固定校准规模,改变样本划分,考察多次覆盖的分母。本次固定一个顺序,只逐步放宽可以看见多少条校准标签。沿用项目首次预测前登记的 SST-2 validation 身份清单。校准池有二百五十六条,协议审计池有三百六十条,二者身份无交集。前者保留原先按身份哈希排出的顺序。每一档都从头截取,所以九条那一档完整包含八条那一档;这种配对使两档之间新进来的是哪条记录可以追溯。
预先写入协议的规模为 4、8、9、10、18、19、20、32、64、128、256。九条检验首次能取有限阈值的位置,十九条检验从取最大值转为可以略过一个最大值的位置,大规模端点与系列早先的完整校准池结果接上。每档并排计算标准规则与一个故意写错的对照:当秩越界时,对照把它截到最后一个已有位置。这样两种方法拥有相同的输入、预算和评价样本,差异只能从边界处理传来。所有档位都保留,审计标签只用来计数。
输入来自公开的英文 SST-2 情感分类 DistilBERT 检查点。复用二百五十六条校准记录里保存的原始两列 logits,即归一化之前的分类头输出。审计侧先对八条做 CPU 试跑,再用同一固定模型对三百六十条重新分词和前向计算。每批至多十六句,输出形状为批大小乘二。正式重放与归档两列数值的最大绝对差为零。正式分批分词与前向循环共约 1.25 秒,进程峰值内存约 914 MiB。曾在旧轮和本轮多次使用 SST-2,此处属于历史数据上的方法审计。没有读取 IMDb 或增加人工语义标签。
覆盖的分母固定为全部审计句子,分子为返回集合包含原始真标签的句数。另记返回零个、一个、两个候选各有多少句,用候选总数除以三百六十得到平均集合大小。空集也进入这两个分母。若只对愿意作答的句子计算覆盖,分母已经变成条件样本,得出的数无法与保形目标直接比较。
本次实际验证
| 校准条数 | 目标秩 | 标准规则的空集/单标签/双标签 | 覆盖句数(共 360) |
|---|---|---|---|
| 4、8 | 分别为 5、9 | 0/0/360 | 360 |
| 9、10 | 分别为 9、10 | 0/287/73 | 350 |
| 18 | 18 | 0/242/118 | 353 |
| 19、20 | 分别为 18、19 | 0/287/73 | 350 |
| 32 | 30 | 0/335/25 | 339 |
| 64、128 | 分别为 59、117 | 0/337/23 | 338 |
| 256 | 232 | 0/351/9 | 333 |
从八条增加到九条,新增校准句的真类分数约为 0.993880,成为当时的最大值。把这个阈值交给审计集,仍有七十三句的两个候选一起通过,其余二百八十七句只有一个候选通过。三百五十句覆盖,意味着十个单标签集合排除了正确答案。以“双标签全部覆盖”作起点,这次变化的收益是给出更多单一答案,代价也可以精确定位到哪十句话。给第十条的结果与九条相同,因为取的仍是最大值,新条目没有刷新它。
有一个容易漏报的反向变化。从十条到十八条,平均大小从约 1.203 升到 1.328,双标签多了四十五句,却只多覆盖三句。在这段前缀上两端都取最大值,新增条目把最大值推高。再添第十九条时,第十八小成了倒数第二个位置,阈值回落。这解释了为什么校准集变大并不要求每一步的集合都变小。它也给比较曲线提出一个要求:标出每档实际取的是第几小,以及附近两条分数相距多远,光标样本数会遗漏变化的直接原因。
截断对照在八条时给出截然不同的结果。校准表中的最大值只有约 0.003028,候选要拿到约 0.996972 以上的概率才能入集。审计池中九十一句返回空集,二百六十九句返回单标签,覆盖二百六十一句,实际比例为 72.5%。其平均大小约为 0.747,比每句一个候选还小。若报表只用平均大小衡量“效率”,恰好会奖励最严重的漏覆盖。到了九条,两种实现的每一条决定都相同。在一份只用几十或几百条校准样本的回归测试里,这个实现错误可以一直不暴露。
官方代码阅读路线与失败排查
从 TorchCP 的 LAC 计分器开始,先找提供标签与不提供标签的两条取分路径。再读公共函数 calculate_conformal_value:检查校准数量与目标秩的关系,越界分支直接返回正无穷,其余情况才调用次序统计量函数。最后返回分割预测器,跟踪阈值如何用于测试候选。这三处的固定版本和具体行号都在源码地图里。本文用标准库独立实现取秩与选集,模型前向直接调用 Transformers 的官方分类类。
实现时最容易混淆三个细节。排序后的数组从零开始寻址,数学上的第九个元素在下标八处。概率方向也要核对,较高的真类概率对应较小的分数。最后,默认插值分位数可能选出两个观测之间的数,既改变了阈值,又可能掩盖越界。本文把十分之一写成精确分数来取整数秩。日志中用 JSON 空值专门编码无穷阈值,重读时需恢复为接纳全部候选的分支;若把它当成测量缺失并丢弃,最重要的两档会从结果表消失。
独立审计另走一条计算路径。对二分类,候选的不合适程度随“另一类输出减去该类输出”单调上升。针对一个审计候选,直接数校准真类中有几条差值严格比它小。计数小于目标秩时就接纳,恰好相等则候选已经越过那个位置。这样无需调用主程序的概率计算、排序和阈值函数,也能重建所有集合。脚本用归档审计 logits 检查二十二个条件、七千九百二十个集合及一万五千八百四十个成员决定,再回算大小分布与覆盖数。这里的证据是可执行的算术核对,原始情感标签取自数据集。
源码与复现入口
固定版本已公开,可从本篇源码目录进入,按复现说明运行,或对照公式与官方代码映射检查实现。
进入本篇源码目录执行:
python run.py
python audit.py
第一条命令从随包的真实预测重建结果表、逐句集合与输入摘要,第二条输出独立核对结果。希望检查某个端点时,先在结果表中按校准规模和规则定位,再用同样的键打开逐句集合,按原始样本身份对齐两次输出。需要重跑分类器时,复现说明给出了固定依赖、校验缓存、八条试跑和完整审计的命令。原始影评与模型权重通过各自的公开来源获取。
研究问题与总结
作者推断可以拆成两条可检验的预期。保持九成目标与当前非随机规则,换一个校准顺序,八条时依然会给所有句子两个标签。这一条在运行模型前就能判断。九条时单标签的数量则取决于新前缀的最大分数和审计候选分数,换序后未必还有二百八十七句。本实验只运行了预先登记的一条嵌套路径,表中差值没有重复抽样误差线。若要估计换序后单标签数的波动,应事先登记多组顺序并共享同一批审计句;不能拿这里的一次跳变充当波动范围。
读到一个看似完美的覆盖率,先问所有候选是否都被交回给了读者。再读一个很小的平均集合,先看空集有多少,真类被丢掉多少次。本次模型本身始终只产生两列相同的输出,决定集合是否有辨别力的,是目标秩能否落入校准表,以及落点附近实际有哪些分数。下一步才有理由把同一规则放到事先定义的子群中,检查总体覆盖掩盖了哪些差别。
参考资料
检索日期为 2026-11-14。
- Angelopoulos、Bates,《A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification》,2021 年首次公开。分割保形的构造与覆盖定理见第一节,有限样本下的秩论证见附录。作者全文
- SUSTech-ML,TorchCP,固定版本的有限样本取秩及越界处理。分位数实现
- Hugging Face,英文 SST-2 分类头与标签配置。模型固定版本
- Stanford NLP,SST-2,validation 划分与数据身份。数据固定版本
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。