复现目标:先把“够用”变成可检查的问题
校准集中正面影评很多,负面影评很少,一个温度还能同时照顾两类吗?直觉容易直接跳到“必须分类校准”。但在增加参数之前,需要先确认问题来自类别比例,而不是样本数量减少、难例偶然缺失,或者评价分布一起变了。本篇新增的受控问题是:总量固定时,仅调整校准样本的类别组成,同一个全局温度在固定审计集上的概率损失怎样变化?
上一篇比较温度缩放与保序回归,本篇不继续挑选方法,只使用已经固定的温度拟合程序。模型、原始分数、标签、截断长度和审计样本全部冻结。新增产物是六十组校准身份、温度搜索轨迹、总体及分类指标,以及独立复算脚本。这让一个容易被泛泛讨论的问题变成可以逐行追问的实验。
这里的“够用”只能按预先规定的指标回答。平均损失降低不等于每个类别都可靠,更不等于每条样本的概率都准确。我们也没有训练分类温度,因此不能声称全局温度胜过更复杂方法。最小实验首先测量敏感性,之后才有理由决定是否增加模型自由度。
核心思想:比例改变了谁对目标函数发言
温度缩放把模型输出的原始分数,也就是 logits,同时除以一个正数,再转为概率。对二分类,记两个分数之差为 ,有
这里 是样本, 是形状为二的分数向量, 是正面类别概率, 是全局温度。负面概率等于 。正温度不改变分数大小关系,因此分类结果应保持不变;它只改变概率的尖锐程度。这是本实验可以直接审计的不变量。
拟合使用负对数似然,简称 NLL:给真实类别较小概率会受到较大惩罚。设校准集中正面比例为 ,按真实标签分组的平均损失为 和 ,则
这条分解说明,增加正面比例会提高正面组在目标函数里的权重。然而本次采用真实样本子集,比例变化也会改变具体成员,所以组内经验损失并非完全固定。不能把全部变化都解释成抽象权重的纯因果效应。配对的类内排序能减少无关扰动,但不能消灭有限样本差异。
论文报告方面,Guo、Pleiss、Sun 与 Weinberger 的二〇一七年研究表明,温度缩放在其研究的多个数据集上有效。本篇没有复现那些完整基准,也不把论文结论扩大成类别不平衡下的普遍保证。下面的数字只来自本轮固定检查点和实际执行的子集实验。
数据边界与评测协议
沿用 DistilBERT 的 SST-2 英文情感分类检查点,模型 revision 为 714eb0fa89d2f80546fda750413ed43d93601a13;数据 revision 为 8d51e7e4887a4caaa95b3fbebbf53c0490b58bbb。校准池二百五十六条、协议审计池三百六十条,身份来自本轮开始时冻结的哈希划分。官方原始标签直接使用,没有新增语义标签或人工金标。
必须披露:SST-2 在历史研究中已经使用,审计池也在前几篇中报告过结果。因此这是复用数据的开发性方法实验,不能称为未见测试,更不能冒充最终确认。IMDb 三池本篇完全没有访问。模型的预训练文本是否包含这些公开句子,也没有经过污染排查。
正式分析前保存协议:每次恰好取一百条校准样本,正面数分别为十、五十、九十,负面数补足总量。采用二十个预定种子,每个种子在两类内部按样本身份哈希排序,再取前缀。三种比例共享同一类内顺序;不放回抽样,不复制少数类,不按模型错误筛选样本。共六十次拟合,全部报告。
主要指标是固定审计池的稳定 NLL,次要指标是两类求和形式的 Brier 分数、按真实标签分组的 NLL 和正确数。没有用审计指标挑选温度、种子或比例。二十次重复来自同一个有限池,下面的标准差是抽样敏感性,不是总体置信区间,也不是二十次独立收集数据得到的误差线。
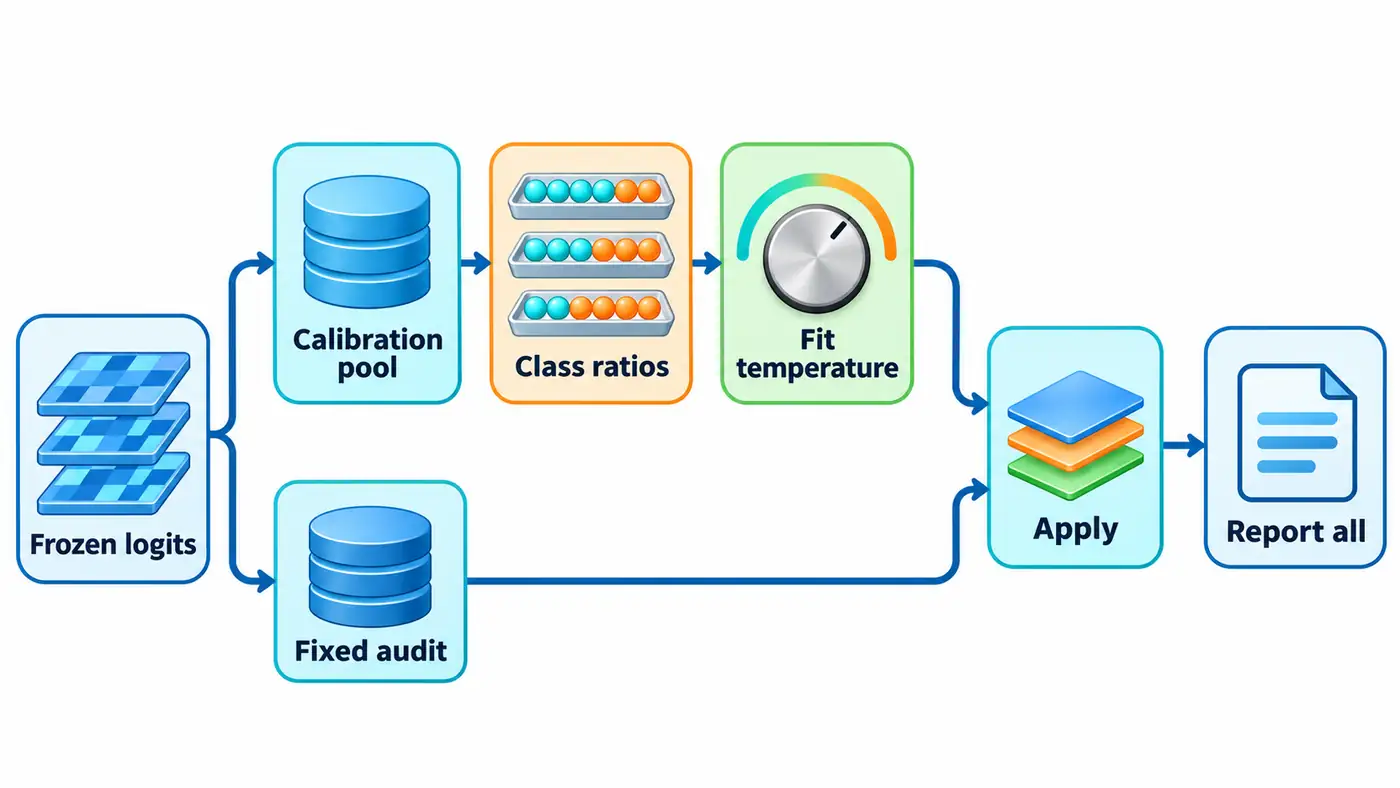
方法图只表达数据流,托盘颜色比例是概念示意,不是实验结果图。审计支路直接进入应用与报告,不能回流到拟合。
官方代码阅读路线与最小实现
阅读作者官方仓库时,先看 temperature_scale 对 logits 的除法,再看 set_temperature 如何收集校准分数、以交叉熵优化温度,最后才看误差分箱代码。本篇固定官方提交 ce1154ec7d5235eee046f28875c3dd8421f11d45,具体永久链接与许可证写入源码地图。
本地没有复制作者的优化器。为了保证温度为正且搜索过程易于检查,继承前篇的独立教学实现,优化逆温度 ,将它限制在 内。对目标导数做一百次二分搜索,并保存边界标志、导数和每步区间中点。这个实现差异必须公开:它验证同一种标量变换,不等于逐行运行论文训练脚本。
稳定计算也很关键。记 为真实标签,并令 ,则单样本损失为
这样不会先把概率舍入成零再取对数。Brier 则使用 ,取样本平均;系数二对应两类求和口径。它与只计算正面概率平方误差的口径相差一倍。公式中的指数、对数和标签映射都由另一个脚本独立检查。
本次实际验证:不平衡没有产生单调恶化
| 校准正面数/总数 | 温度均值±标准差 | 审计 NLL 均值±标准差 | 审计 Brier 均值 |
|---|---|---|---|
| 10/100 | 2.4957±0.2090 | 0.238421±0.002086 | 0.135443 |
| 50/100 | 2.4683±0.3352 | 0.240355±0.004107 | 0.136042 |
| 90/100 | 2.3981±0.2012 | 0.238230±0.001559 | 0.135769 |
原始审计 NLL 为零点三八四一一三,Brier 为零点一五四〇〇一。六十次正温度变换都保留三百三十条正确预测。就这组实验而言,三种组成的平均损失都低于未校准基线;平衡条件并没有给出最低的平均损失,也没有给出最小的温度波动。
这不是“不平衡有益”的证据。不同条件抽到的错误样本及其分数强度不同,二十个重复高度共享有限池中的样本,均值差距也很小。作者推断是:在这批数据里,类别比例本身不足以解释温度失效;高置信错误的组成可能同样重要。这个解释尚未经过单独干预,只能作为后续假设。
工程复算分两层执行。新增分析复用六百一十六条既有真实模型预测,并没有宣称重新推理全部样本;另外以同一模型、同一数据缓存做八条真实 CPU 试跑,检查推理链条仍然成立。试跑采用单精度、四线程和最长五百一十二 token,模型前向约零点〇六秒,导入之后总流程约零点五三秒。下载缓存经原登记哈希验证后复用,未重新下载权重。
独立脚本没有调用拟合器,而是用黄金分割搜索重新寻找目标最小值,并从原始分数复算身份、概率损失、Brier 和正确数。六十组全部通过,指标最大差异约为三点三乘十的负十六次方。这是自动确定性复算,不是人工语义审核;运行命令、退出码、输入哈希与输出均保留在交付记录中。
失败排查:先排除协议变化
如果复现出现准确率变化,应先检查标签映射、分数顺序、是否使用非正温度,以及相等分数时的判定规则。单一正温度不应改变分类边界。如果类别比例调整后总量也变化,就失去了本篇控制条件;如果少数类通过重复采样补足,应另行记录有效独立样本数,不能冒充本实验。
如果温度贴到搜索边界,需要报告边界而不是悄悄扩大区间。少量样本恰好没有错误时,优化目标可能鼓励极端自信;上一实验已经展示过这种失败路径。本次所有轨迹保留,读者可以自行检查是否触边,而不必依赖正文给出的均值。
最隐蔽的错误是用真实标签挑选“类别温度”后直接用于测试。推理时不知道真实类别,规则必须说明依赖预测类别还是对每个 logit 分别变换;两者都与当前标量温度不同,还可能改变决策边界。本文没有实施这些方法,不能凭直觉宣称它们能修复本次现象。
源码与复现入口
本篇源码已公开并核验固定提交:源码目录、README 与运行说明、SOURCE_MAP 源码地图。完整交付包含入口脚本、独立审计、冻结预测、协议、依赖、资源身份与源码地图。最小分析命令如下:
python run.py
python audit.py
预期产物是六十组逐次记录、汇总指标、资源耗时与独立审计结果。分析本身只需标准库;真实模型重放需按 README 安装固定依赖,并执行资源准备与八条试跑命令。原始 SST-2 句子不随源码分发,因为数据卡许可标记不明确;读者通过固定版本下载脚本获取,模型权重和缓存也不进入压缩包。
复算时还应保留每个真实标签组的分母。总体指标是各组损失按样本数加权后的结果;一个组改善较多,可能遮住另一个组的变化。源码逐次保存两个标签组的损失,允许读者核对这种抵消,但本文没有给这些分组结果附加总体显著性结论。原始标签分组也不能替代对讽刺、否定或复杂语义的人工判断。
另一个容易忽略的限制是校准池覆盖范围。人为抽取九成正面句子,只改变了当前公开短句池中的组成,没有制造新的语言风格或更长上下文。因此这项干预无法代表自然分布变化,更不能预测长影评上的迁移表现。保持审计分布不变是为了隔离问题,同时也限制了答案的适用范围。
研究问题与总结
下一步可以检查参数迁移,但不能直接拿本篇审计最低损失的温度当作赢家。新的比较必须先定义配对规则、估计对象和数据权限。若以后想检验“难例组成比标签比例更重要”,应先登记错误强度的操作定义,并明确使用哪些开发数据;不能看过最终确认结果之后反向补写假设。
本篇留下的可靠结论是有限而具体的:固定一百条校准总量、三种类别比例和同一审计分布时,全局温度的表现没有随不平衡程度单调恶化。它可以在总体概率损失上保持作用,但这些结果没有证明子群体可靠性,也没有证明更复杂校准不必要。可复查的协议与负结果,比一个过度整齐的结论更值得保留。
参考资料
检索日期:2026-11-05。论文主张、实现细节与本次测量分别陈述。
- Chuan Guo、Geoff Pleiss、Yu Sun、Kilian Q. Weinberger,2017,On Calibration of Modern Neural Networks,ICML/PMLR 70。
- 作者官方温度缩放实现,固定提交。
- DistilBERT SST-2 官方模型卡。
- Stanford NLP SST-2 数据卡。
作者作品推广
这里是作者自有产品推广。我也独立开发了两款日常小工具:日常收支小记用于记录收支、安排预算与储蓄目标,在 App Store 了解;一事微光帮助你按时间、精力选择小行动,并记录完成后的感受,在 App Store 了解。更多技术文章与个人作品欢迎访问个人网站。这些产品独立于本文实验,不代表论文作者或研究机构背书。