复现价值:从手动降温到隔离拟合
前面的实验已经说明,同一组分类答案可以保持完全不变,同时具有不同的概率质量。但把几个温度都试一遍,再挑出最好看的结果,并没有回答真正的研究问题:如果只允许使用一份事先隔离的校准数据,学到的温度能否改善另一份数据上的概率?本篇只改变这一个环节。模型权重、分词器、标签映射和推理配置全部冻结,新增的可审查产物是校准池预测、温度优化轨迹和审计池上的配对指标。
先说本次实际验证:固定的 DistilBERT 情感分类器,在二百五十六条校准样本上得到温度约二点四八。随后对三百六十条协议审计样本应用这个数,负对数似然和校准误差均下降,分类正确数保持三百三十。这个结果支持“一次隔离拟合能够改善本划分上的概率质量”,不支持“已经获得普遍可靠的置信度”,更不意味着模型学会了识别所有错误。
核心思想:只改变概率的尖锐程度
分类器先输出两个未经归一化的分数,称为 logits,再用 softmax 转成概率。温度缩放在归一化前把所有分数除以同一个正数:
这里样本编号为 ,类别编号为 ,类别数 ;一批输入的分数张量形状是 ,温度 是一个正标量。温度大于一时,两类概率向均匀分布靠近;小于一时,概率更加尖锐。它改变的是模型说话的力度,不改变类别分数的大小关系。
因此,只要保持正温度和一致的并列处理规则,最大概率对应的标签不会改变。原先判错的句子仍然判错。我们期待修复的是“错误答案却报出接近一的概率”,而不是情感理解本身。这里的概率针对固定的正负二分类任务,与上一文讨论的生成模型有限候选归一化分数不同,也不能直接解释为开放生成内容正确的概率。
拟合目标采用负对数似然,简称 NLL:
其中 是校准样本数, 是公开数据的原标签。对真实标签分配越小的概率,惩罚越大。选择规则在新池推理前写入协议;没有用审计误差挑温度,没有尝试多个范围后保留最优范围,也没有优化分箱误差。
论文报告与官方代码阅读路线
Guo、Pleiss、Sun 与 Weinberger 的 ICML 二〇一七年论文讨论现代神经网络的置信度校准,并在其研究的数据与模型中报告温度缩放的有效性。那是论文报告的证据范围。本篇使用的是另一个固定文本分类检查点与较小的探索划分,因此不复述原论文数值,也不把自己的结果称作完整论文基准复现。论文与出版信息
阅读作者代码时,可以先找 temperature_scale,确认除的是 logits,再看 set_temperature:先收集验证分数和标签,再以交叉熵优化单一温度。作者实现使用 GPU 与 LBFGS;本篇没有照搬整个训练栈,而是为二分类目标编写独立教学求解器。具体固定提交和函数定位均记录在源码地图中。作者实现
本地改写的理由是可审查性:令逆温度为 ,并记两类原始分数差为 ,则目标的一阶导数为:
其中 是 sigmoid 函数,标签编码为零或一。导数随逆温度单调不减,因此可以在预注册区间用二分法找零点;如果区间内没有零点,就报告边界解。本次固定执行一百次二分并保存每一步,不把迭代次数当作模型训练轮数。温度未碰到边界,最终梯度约为浮点精度下的零。
最小实验:先冻结身份,再打开分数
数据沿用官方 SST-2 validation 的八百七十二条记录。既有登记按样本编号与固定前缀计算哈希,再排序划为探索二百五十六条、校准二百五十六条、协议审计三百六十条。本次没有重新洗牌,没有从探索池挑选“更典型”的校准样本。三个池的身份清单在基线实验时就已保存,本次逐项验证不重叠。
必须披露:SST-2 在历史研究中已经使用过。新划分只能隔离本轮拟合的信息流,不能擦除历史观察,也不能叫作从未见过的测试集。协议审计池今后同样属于已观察开发证据,不能再被包装成独立最终确认。IMDb 三池本次未下载、未预测,最终确认池仍须遵守后续登记与使用规则。
模型是官方固定 revision 的 DistilBERT SST-2 检查点,权重、配置和词表都通过文件哈希核对;数据也核对固定 parquet 文件哈希。标签零为负面、一为正面。推理用 CPU、单精度、四线程、eager attention,批量十六、最多五百一十二个 token,并关闭训练模式。不更新任何网络权重,只优化后处理的一个数。
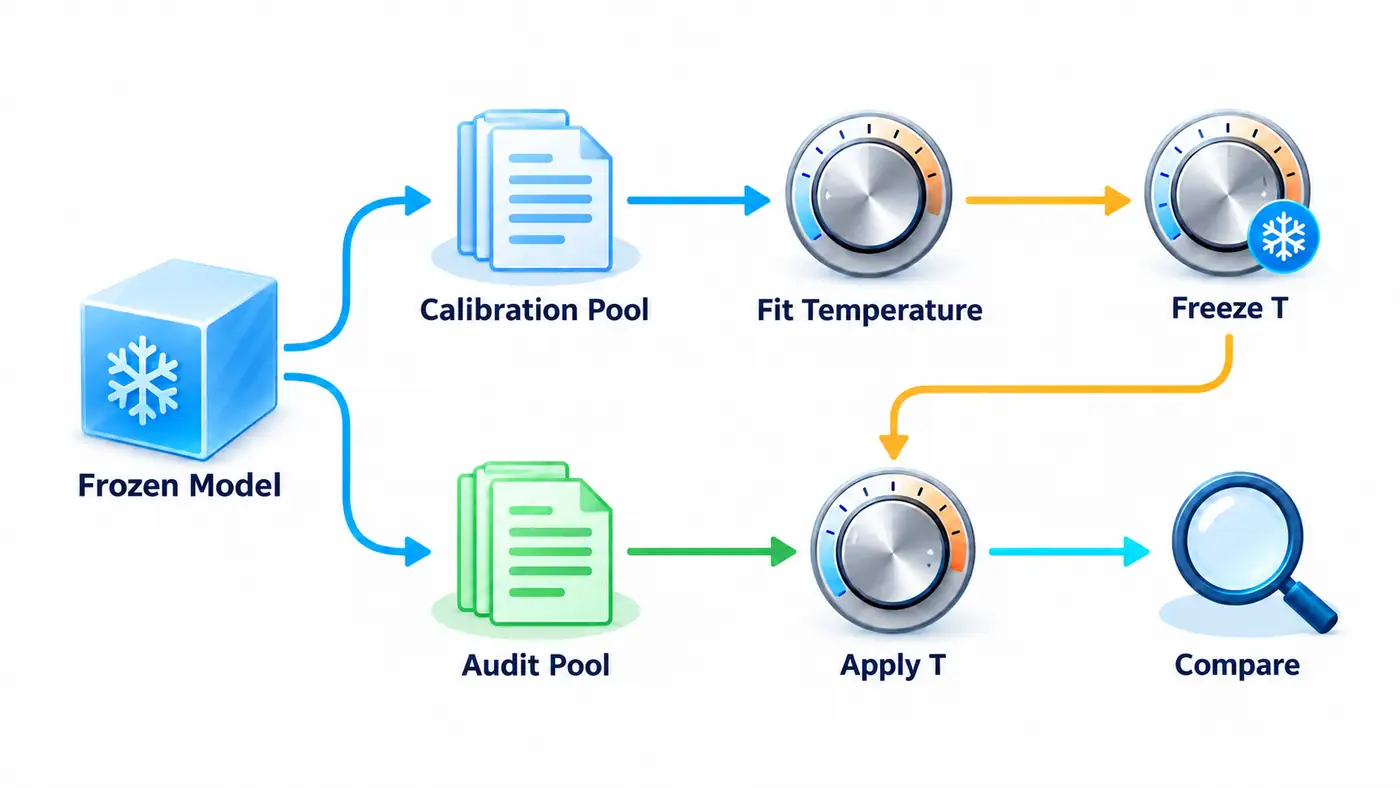
图中的两个 Pool 表示相应数据经过冻结模型后的分数集合。上路拟合温度并冻结,下路仅应用这个数后计算指标;审计结果没有回到拟合节点。先执行校准池前八条试跑,再运行完整校准池,落盘温度文件后才执行审计池。每个样本保存编号、文本哈希、原标签、两维 logits 和概率,不再分发原始语句。
评测协议与本次实际验证
主指标是审计池 NLL,辅助指标包括双类别求和形式的 Brier 分数、十个等宽箱的预期校准误差 ECE、平均置信度和准确率。Brier 是两类平方误差之和,量纲范围为零到二;不能与只对正类计算的单项版本混用。ECE 使用左闭右开箱,最后一个箱包含右端点,并保存每箱分母。
| 审计池指标,样本数360 | 原始概率 | 校准概率 |
|---|---|---|
| 正确数 | 330 | 330 |
| 准确率 | 0.916667 | 0.916667 |
| 平均置信度 | 0.982405 | 0.918592 |
| NLL | 0.384113 | 0.237136 |
| 双类 Brier | 0.154001 | 0.135151 |
| ECE10 | 0.073274 | 0.019900 |
拟合所得温度为 。校准池本身的 NLL 从零点四〇三七降至零点二四二六,但这不是独立的效果验证;真正需要关注的是冻结温度之后的审计结果。审计平均置信度与准确率之间的差缩小到约零点〇〇一九,仍不能仅凭这个总体均值声称所有概率区间都校准好了。
事先固定的九成阈值也揭示了边界:原始概率中三百四十三条达到阈值,其中二十三条错误;校准后只剩二百七十九条达到阈值,其中十条错误。接受集合变小、错误比例降低,但被保留的错误没有消失。这只是固定阈值的描述性统计,尚未构成拒答阈值选择实验,也没有校正反复观察产生的选择偏差。
本次完整推理的校准阶段约一点一五秒,审计阶段约一点三七秒;导入之后整个过程约二点八〇秒,进程峰值常驻内存约九点六八亿字节。依赖下载、初次导入和环境修复不包含在该耗时中;没有测量能耗、服务吞吐或硬件峰值显存。所有结果来自真实检查点前向计算,图示中的光束不是测量曲线。
独立复算与失败排查
独立审计脚本不导入主实验模块,用 sigmoid、稳定 softplus 和二分类 Brier 恒等式从 logits 重新计算全部指标;又用直接针对温度的黄金分割搜索复核优化结果。两种求解方法的温度差约二乘十的负八次方,指标最大差约八乘十的负十七次方。它验证确定性算术一致性,不称为真人审核,也不能代替语义标注质量判断。
环境恢复留下了真实失败记录:此前临时环境缺失 PyTorch;默认依赖缓存写入受限,首次联网安装也失败。工作区旧环境导入出现停滞,之后停止该任务进程,在隔离临时环境安装固定依赖并完成试跑。另一次启动把虚拟环境解释器软链接解析成基础解释器,导致依赖不可见;修正执行路径后继续,没有用合成数据顶替模型实验。
复现失败时,优先看资源哈希是否一致,再看标签映射、推理模式和 logits 形状。若温度变成负数、分类答案变化或优化结果落在边界,先排查实现和数据,不应直接解释成校准发现。若校准目标改善而审计目标变差,也应保留这份结果;重新调整范围后再报告同一审计池,会把审计数据逐步变成调参数据。
源码与复现入口
完整源码已公开:固定提交目录、README、SOURCE_MAP。匿名下载的二十六个文件与本地及压缩包逐一核对一致,公开副本的独立审计和真实八条试跑通过。配套包包含完整入口、依赖、资源锁、划分清单、协议、源码地图、两池逐样本结果和独立审计程序。读者取得公开源码后,在源码目录安装固定依赖,先执行资源获取,再运行真实模型:
python run.py prepare --cache .cache117
python run.py smoke --cache .cache117
python run.py run --cache .cache117
python audit.py
预期产物为两池预测文件、温度与优化轨迹、聚合指标、形状与环境记录、独立复算结果。已有固定资源可以复用校验后的缓存,无须反复下载模型。约二百七十兆字节模型权重通过官方入口获取,不打进源码包;数据许可信息不明确,包中只放身份哈希和派生数值,不含原始文本。
还有一个容易混淆的检查:独立求解器得到相近温度,不等于温度在重新抽样后也稳定。前者检查计算,后者检查数据变化带来的估计波动。本篇只完成前者,没有用反复抽样挑选更好结果。读者如果想比较不同机器,应先对齐输入身份、模型文件与概率计算精度,再比较逐样本分数;仅比较最终四舍五入后的指标,可能掩盖标签错位或文件混用。保存失败日志的意义也在这里:它让环境修复与科学选择可以分开追踪,避免把一次没跑通的命令写成已经验证的入口。
研究问题与总结
本篇最有价值的证据不是温度恰好等于多少,而是拟合和评测职责终于分开。一个标量在这个固定划分上明显改善了概率质量,且没有改变任何分类标签。这让“校准有用”成为可以独立复算的具体观察,同时也限定了它修复不了的部分:错误的语义决策、少量高置信错误,以及未观察分布上的可靠性。
下一步可以检验校准样本数变少时温度是否稳定,但必须先固定嵌套样本、随机种子与汇总规则,不能从审计集里挑出最顺眼的温度。另一个待检验假设是少数严重错误主导了 NLL 拟合;它需要预注册影响分析,不能仅从总体均值倒推出结论。本次没有做显著性检验,没有给出总体覆盖保证,也没有把单次效果推广为所有模型的规律。
参考资料
检索与实际访问日期:2026-11-02。
- Chuan Guo, Geoff Pleiss, Yu Sun, Kilian Q. Weinberger. 2017. On Calibration of Modern Neural Networks,ICML,PMLR 70,1321–1330。
- Geoff Pleiss 等作者代码:temperature_scaling.py 固定提交,MIT;本次阅读对照,求解器独立实现。
- Hugging Face:DistilBERT SST-2 固定模型卡。
- Stanford NLP:SST-2 固定数据卡。
- Hugging Face:Transformers 固定分类器实现,Apache-2.0。
作者作品推广
以下是作者自有产品推广。除了写科研博客,我也独立开发一些日常工具,欢迎按自己的需要了解:日常收支小记用于记录收支、安排预算和储蓄目标,前往 App Store;一事微光帮助你根据时间和精力选择小行动,并记录完成后的感受,前往 App Store。更多技术文章与个人作品见作者网站。这些介绍与本篇实验结论相互独立,不代表论文作者或机构的推荐。