可信预测实验室:从模型置信度到可检验的拒答
复现价值:把平均数拆成可以追查的样本
前一篇固定预测类别,只改变概率的温度,说明准确率相同也可能对应不同的概率质量。这次进一步追问:原始模型最有把握却答错的样本,是否聚集在某些可重复定义的组里?我们固定同一批真实预测,不训练、不校准,只改变观察它们的分组方式。目标不是找几个令人惊讶的句子,而是交付一份保留分母、身份和选择规则的错误审计表。
“最自信”有两种含义:可以指超过固定门槛,也可以指错误内部的排序。本文分别处理:主要统计使用置信度不低于零点九的集合;案例入口则按错误置信度降序保留前五条,同分按原始编号升序。规则在本次分组计算前登记,但此前整体准确率已经被观察,因此这仍是探索分析,不能冒充完全盲态的预注册研究。
核心思想:错误数量与错误率回答不同问题
这里的置信度是二分类概率中较大的一个。它不是模型对自己能力的自然语言评价,也不是开放生成答案真实无误的概率。Guo 等人的校准论文讨论概率与经验正确性的关系;本篇借用这个测量视角,新增的长度分组审计是独立教学实验,并非论文原实验的复刻。论文原文
假设某组包含大量样本,即使它的错误率很低,也可能贡献最多错误。反过来,只有少数样本的组可以出现很高比例,却不足以说明稳定规律。先看分母,再看比例,是从案例故事走向可检验问题的第一步。我们同时保存全部样本数、全部错误数、高置信样本数、高置信错误数;正文突出主要口径,源码保留完整十二行结果。
公式与分组:先写规则,再看结果
其中, 是第 条样本对类别 的分类分数;每批 logits 的形状为批大小乘二。 是归一化概率, 是置信度, 是最大概率类别, 是数据原始标签, 为错误指示量。本次直接复用已保存的双精度概率,并用原始 logits 独立复算验证。
表示一个预定组, 是该组高置信样本数, 是其中错误数, 是主要报告的条件错误率。当分母为零时输出空值,不能输出零风险。它描述当前这批样本,不自动拥有总体置信保证。
长度使用固定 tokenizer 得到的原始 token 数,包含特殊标记,边界为不超过十六、十七至三十二、超过三十二。它不是字符数,也不是人工判断的语言复杂度。另一个轴使用数据标签:零为负向、一为正向。先报告三个长度组和两个标签组,再报告两轴形成的六个交叉组,连同整体共十二行。我们没有扫描边界后挑选差异最大的切法。
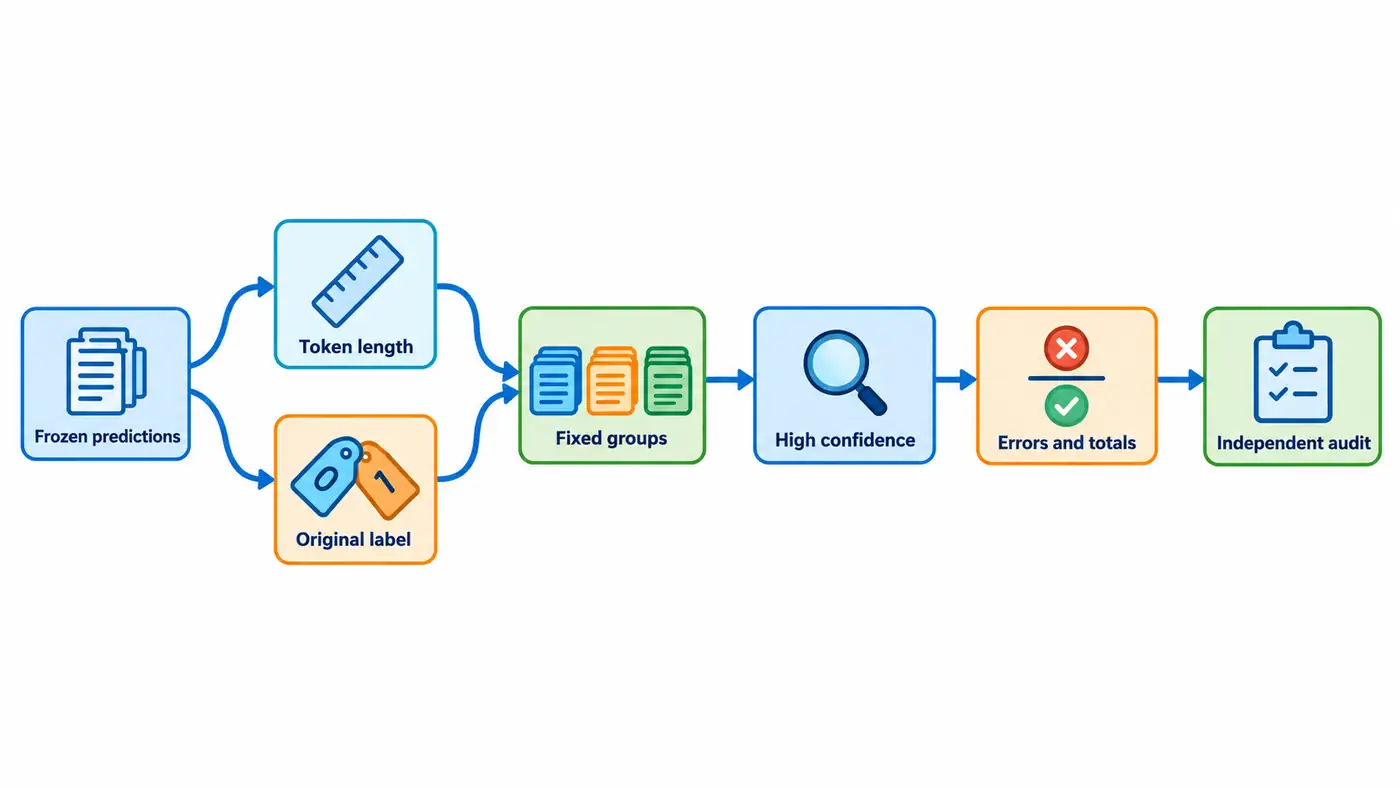
图中长度与原标签汇入固定分组,之后才执行高置信筛选和错误计数。它是方法示意图,不承载定量结果;分母包括筛选后的正确与错误样本,不能只保留红色错误标记。
官方代码阅读路线
先从官方模型卡确认这是英文 SST-2 情感分类检查点,再到固定 Transformers 提交的分类器实现。阅读顺序是模型输出、首位置隐藏状态、预分类线性层、激活、dropout 和最终分类头。评估模式关闭训练期随机 dropout;本篇没有把生成式语言模型的 token 概率拼成分类置信度。模型卡
代码地图固定 Transformers 提交、具体文件与行号,并标明 Apache 许可证。真实推理由官方库执行;分组脚本是独立实现,没有复制上游神经网络。独立审计脚本也不导入分组脚本,而是通过二分类 sigmoid 恒等式重建置信度,再逐组重算分子和分母。两套代码给出相同结果,比同一函数调用两遍更有检查价值。
最小实验与数据边界
模型固定为 DistilBERT SST-2,revision 为 714eb0fa89d2f80546fda750413ed43d93601a13;数据固定为 Stanford SST-2,revision 为 8d51e7e4887a4caaa95b3fbebbf53c0490b58bbb。validation 按预定身份哈希排序,前二百五十六条构成探索池。后续校准池与协议审计池没有在本篇推理,IMDb 也未读取预测。SST-2 在历史项目中已经使用,因此重新排列不能使它成为从未接触的测试集。
输入文件同时保存数据身份、文本哈希、原标签、logits、概率、预测类别、正确性和 token 长度。正式二百五十六条日志继承首篇固定版本;今天新增的是分组分析及八条真实模型复跑,不声称重新推理了全部样本。没有训练、阈值优化或按结果选择模型。原始语句不随源码打包,数据卡许可仍标记未知,读者通过固定版本下载并核对哈希。数据卡
本次八条复跑的模型前向用时约零点零六九秒,导入完成后总用时约零点四八九秒,峰值进程内存约七点九五亿字节;分组分析约零点零零二秒。它们是单次测量,不是性能排行榜。复跑使用 CPU、单精度模型与既定线程配置。缓存校验包含模型文件、tokenizer、数据文件、配置和代码身份,不能仅凭文件名相同就复用。正式分析还锁定预测文件哈希;若输入被替换,脚本应立即失败。耗时、峰值进程内存、系统与依赖版本写入运行记录,下载时间与历史正式推理时间不冒充今天的分析时间。
评测协议与实际结果
二百五十六条中有二百三十三条正确。高置信集合包含二百四十二条,其中十九条错误,条件错误率约百分之七点八五。这个数不能读成“每一条高置信样本都有同样的错误概率”,它只是这批集合的观测比例。
| 分组 | 全部样本 | 高置信样本 | 高置信错误 | 条件错误率 |
|---|---|---|---|---|
| 短 | 54 | 51 | 6 | 11.76% |
| 中 | 140 | 138 | 5 | 3.62% |
| 长 | 62 | 53 | 8 | 15.09% |
| 原负向标签 | 130 | 123 | 13 | 10.57% |
| 原正向标签 | 126 | 119 | 6 | 5.04% |
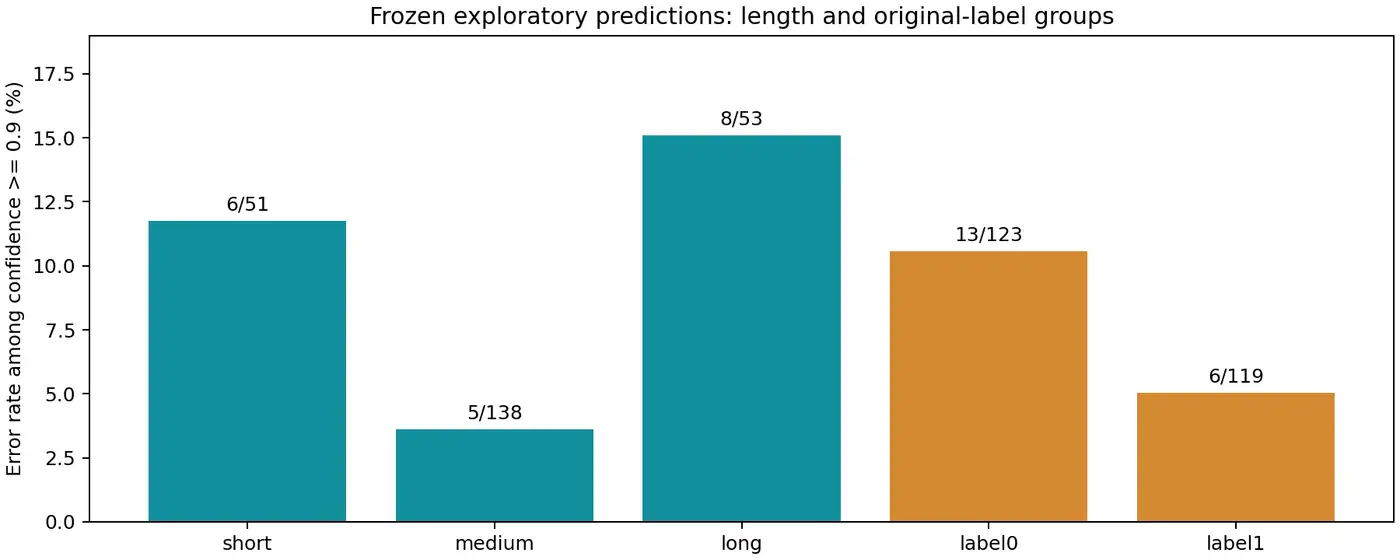
此图由 Matplotlib 读取保存的分组日志绘制,柱顶标出错误数与高置信分母;不绘制未经计算的误差线。
长度组之间互斥,标签组之间互斥;两种轴不能相加,否则会重复计算样本。本次实际验证显示,中等长度组样本最多,错误率却最低;短组和长组均较高。因此“错误率随长度单调增加”在这里不是合适的描述。长组贡献八个高置信错误,占十九个的约四成二,而它占高置信样本的约两成二,这才是“集中”的一个可检查含义。
交叉组进一步显示,短负向为四除二十九,短正向为二除二十二;中负向为四除六十四,中正向为一除七十四;长负向为五除三十,长正向为三除二十三。各格错误只有一至五个,一个样本就能显著改变百分比。我们不根据格子高低宣布显著差异,不从中选择需要拒答的子群体,也不把原始情感标签当作人口群体或安全标签。
最高置信错误的原始编号依次为七九一、二八二、九二、八二九、四九四,对应置信度约为零点九九九七九、零点九九八六八、零点九九八五二、零点九九八零零、零点九九七三七。长度覆盖十一至四十六 token,原标签两类都有。这个列表提供确定性回查入口,尚不构成“反讽”“否定”“标签噪声”等语义分类。
失败排查:不要把审计做成解释幻觉
第一类失败是把低置信样本从分母删除,却仍把指标叫整体错误率。第二类是先看错误句子,再发明只覆盖这些句子的类别;这会让组别定义吸收答案。第三类是把 token 长度说成信息量或理解难度:分词粒度、标点和专有词都可能改变长度,相关性不能直接归因于上下文能力。
另一类失败来自实现细节。长度边界必须写清等号归属,原标签与预测标签不能混用,最高置信错误的同分排序必须稳定。复算应同时核查身份与算术,否则把另一组样本的正确结果贴过来,也可能通过只比较均值的检查。这里对全部行重新计算类别和置信度,再检查每组错误编号,避免只校对最终百分数。
目前没有新增人工金标,也没有修改标签。若未来要说这些错误源于反讽或标注歧义,必须先制定语义指南、准备待审材料并取得真实审核结果,不能让自动生成的解释成为证据。本篇不需要这一步才能完成确定性分组,但也不借此越过语义判断的边界。
源码与复现入口
本篇已公开的固定版本:源码目录、README、SOURCE_MAP。公开副本与本地分发清单逐文件哈希一致,并已通过独立复算与真实模型试跑。
最小分析命令为 python analyze.py && python check_analysis.py,生成十二组统计、最高置信错误列表、独立审计记录和资源记录。真实模型复现入口为 python execute.py prepare --cache .cache112,之后执行 python execute.py smoke --cache .cache112;完整范围使用 formal 动作。依赖、资源锁、分割清单和基线推理模块均包含在配套源码中,不依赖作者机器的私有模块。
复现时建议分三层阅读产物。第一层检查资源锁与划分清单,确认拿到同一个数据版本和同一组编号;第二层核对逐样本概率、预测与长度,定位异常究竟来自分词、模型还是输入错位;第三层才比较分组汇总。如果第一层不同,即使最终错误率接近,也不能称为同一实验复算。这个顺序尤其适合刚开始做科研的读者:先让差异可定位,再讨论结果是否有意义。
还应区分“没有出现错误”与“已经证明可靠”。本次交叉组都出现了错误,但在更细分组中完全可能遇到零错误。小样本零错误不代表真实风险为零,不能因此把组别名单直接用于拒答决策。同样,若以后改变置信阈值,接受样本的组成会随之变化;新错误率对应新的条件集合,不能把两个百分比的差异全部归功于模型改进。本文冻结门槛,正是为了让今天的问题只落在观察分组这一处。
研究问题与总结
作者推断是:中间长度较低的错误率值得跟踪,但目前证据不能区分文本内容、类别构成与长度本身的作用。下一步若要检验长度解释,应先冻结配对或分层方案,在允许的独立数据上验证,而不是立即删除长样本,或重新寻找能让曲线单调的边界。当前列表只能生成假设,不能同时承担发现和确认。
本篇新增产物是一份能从真实 logits 独立还原的错误地图。模型接近满分的置信度仍可能对应错误;错误在不同组中的比例也并不一致。保留完整组别、分母、固定规则和历史接触说明,让这些现象成为后续研究可以挑战的对象,比把五个案例讲成模型的一般缺陷更可靠。
参考资料
检索日期:2026-10-31。论文报告、官方模型说明与本次实际分析分别标注,不引用动态榜单数字。
- Chuan Guo、Geoff Pleiss、Yu Sun、Kilian Q. Weinberger,2017,ICML:On Calibration of Modern Neural Networks。
- Hugging Face:DistilBERT SST-2 模型卡。
- Stanford NLP:SST-2 数据卡。
- Hugging Face:固定提交的分类器实现。
作者作品推广
以下是作者自有产品推广。除了写科研博客,我也独立开发让日常更有条理的小工具:日常收支小记用于记录收支、安排预算和储蓄目标,在 App Store 了解;一事微光帮助根据时间、精力选择日常小行动,并记录完成后的感受,在 App Store 了解。更多技术文章与个人作品,欢迎访问作者个人网站。这些产品介绍独立于本文实验和科研结论。