同一个温度,借给谁用
有一批带标签的短影评。分类器在这批数据上学到一个温度,能把过于尖锐的概率调柔和。如果让语言模型读同一批影评,回答同一道正负面选择题,能否省掉重新拟合,直接借用这个数?本次审计得到一个有方向的答案:把分类器的温度借给语言模型,两种模板的损失都下降了。把语言模型的温度借回分类器,两次都比保持原始概率更差。即便借用有效,用它给全部样本打出负面标签的问题也原封不动。
上一篇改变校准样本的类别构成。这次保留所有校准身份和标签,只改产生分数的接口,以及温度来自哪个接口。对每一种目标分数,都能逐条问两个问题:借来的温度比不处理好吗?与在目标接口上拟合温度相比又如何?两个参照不能混成一句“迁移成功”。最有辨识力的证据正是同一个参数在两种参照下会得到不同评价。
三个接口究竟给出什么分数
记分类器为 C。它是已经针对 SST-2 微调的 DistilBERT,每条影评产生两个未归一化分数,标签顺序固定为负面、正面。另两个接口 A 和 B 使用同一个 SmolLM2 指令检查点。我们给它一段原始英文提示,结尾固定为 Answer:,只给带前导空格的 negative 和 positive 两种续写计分。没有采样,没有聊天包装,也不把结束符算入答案。因而这里的温度是对已经得到的分数做后处理,和生成时调节采样温度是两种不同的实验操作。
两种模板只有提问中选项的顺序不同。A 问 “Is this review positive or negative?”,B 问 “Is this review negative or positive?”。实际取分时始终先取负面再取正面。这个细节值得写进配置:如果同时交换了输出数组的位置,却沿用旧的标签映射,两次方向相反的错误可能抵消,得到一个看起来很像正常值的汇总分数。
对一条样本,设两个分数为 ,差值为 。分类器直接提供这两个分数。语言模型给出的是两个候选词在完整词表下的对数概率。两者都可以用下面的式子算出正面的归一化概率:
这里 是正温度,分母里的指数只用到了两个候选的相对分数。对语言模型而言,共同的全词表归一化项在相减时消去;把两个词的概率重新归一化,也就放弃了关于其他续写的信息。即使两个候选在词表中的概率都很小,其中一个仍可能取得很高的条件概率。因此全文的正确性始终指公开标签下的二选一结果。这个数不能用来估计任意开放回答的事实正确率。
对正温度,差值的符号不会变。若两类分数相等,两边沿用同一个平局规则。如果只换温度却观察到预测标签翻转,应先停下来核对数值精度、类别维度和标签映射。另一方面,当温度很大,两类概率都会逼近一半。它能减少“自信地猜错”的代价,也可能削弱本来就对的高置信预测。两种影响谁占优势,要看目标接口分数和标签的联合分布。
把拟合和应用拆开
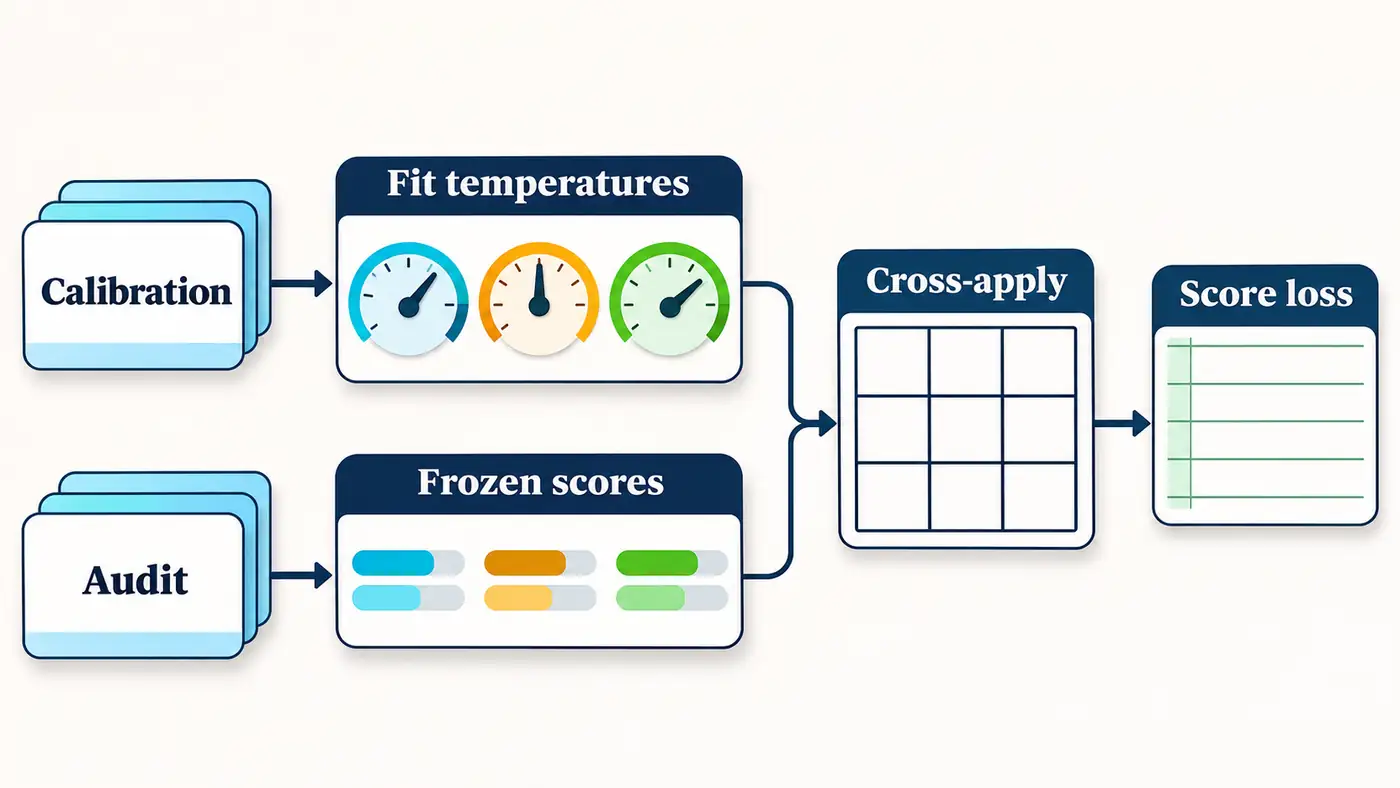
沿用事先登记的 SST-2 validation 划分。按稳定样本编号的哈希排序,跳过最初的二百五十六条探索样本,用接下来的二百五十六条拟合,最后三百六十条用于协议审计。两池身份分开。这个公开数据集此前用过,审计池的分类器结果也已在前文分析过,本次属于复用数据的受控实验。没有在审计集上选模板、边界或参数,没有读取 IMDb 确认池。模型预训练是否接触过某段公开文本也无法由这次实验排除。
每种接口在相同的校准标签上单独拟合一个数。主指标是平均负对数似然,简称 NLL。它按模型给真实类别的概率计费,给真类的概率越低,损失越大。用逆温度 写出校准目标:
这里 为校准条数, 取零或一, 是第 条样本的正负分数差。评分用自然对数。程序使用与上式等价的稳定写法,避免先算出接近零的概率再取对数。优化变量只有一个;其导数是各条分数差乘以正面概率与标签之差,再取平均。程序在预先指定的逆温度区间 0.05 到 20 内二分寻找导数的零点。这个区间也容许最优解在端点,不能把撞到边界的结果解释成找到了无约束最优解。本次三个解均在内部。
三个参数拟合完毕,每个都应用到三组冻结的审计分数,形成九个配对。另加每组的单位温度作为原始分数对照。表中每格都覆盖同样的三百六十条影评。不在十二个单元格中挑最低值当作新部署规则。独立脚本从逐条记录出发,直接在温度轴上按损失搜索,不调用主程序的梯度或指标函数,再核对每格的损失、预测正面数和正确数。
一张交叉表,先沿行读
| 接收温度的审计接口 | 不校准 | 用 C 的温度 | 用 A 的温度 | 用 B 的温度 | 正确数 |
|---|---|---|---|---|---|
| C 分类器 | 0.38411 | 0.23714 | 0.53831 | 0.52833 | 330/360 |
| A 正面先问 | 1.00483 | 0.73153 | 0.68979 | 0.68966 | 176/360 |
| B 负面先问 | 0.92897 | 0.72383 | 0.69136 | 0.69131 | 176/360 |
三个拟合温度依次为 2.48192、17.45244、16.23110。先沿第一行读,所有数字都来自相同的分类器输出。与不校准相比,自身温度把损失降低约 0.147;移植 A 温度反而增加约 0.154。把同一个数横向换到不同目标上,效果方向也换了。分类器在审计池答对了三百三十条,过度拉平会让许多原本给真类较高概率的样本一起受损。这是和数据一致的解释;要把作用大小归到特定语义类别,仍需另做分组实验。
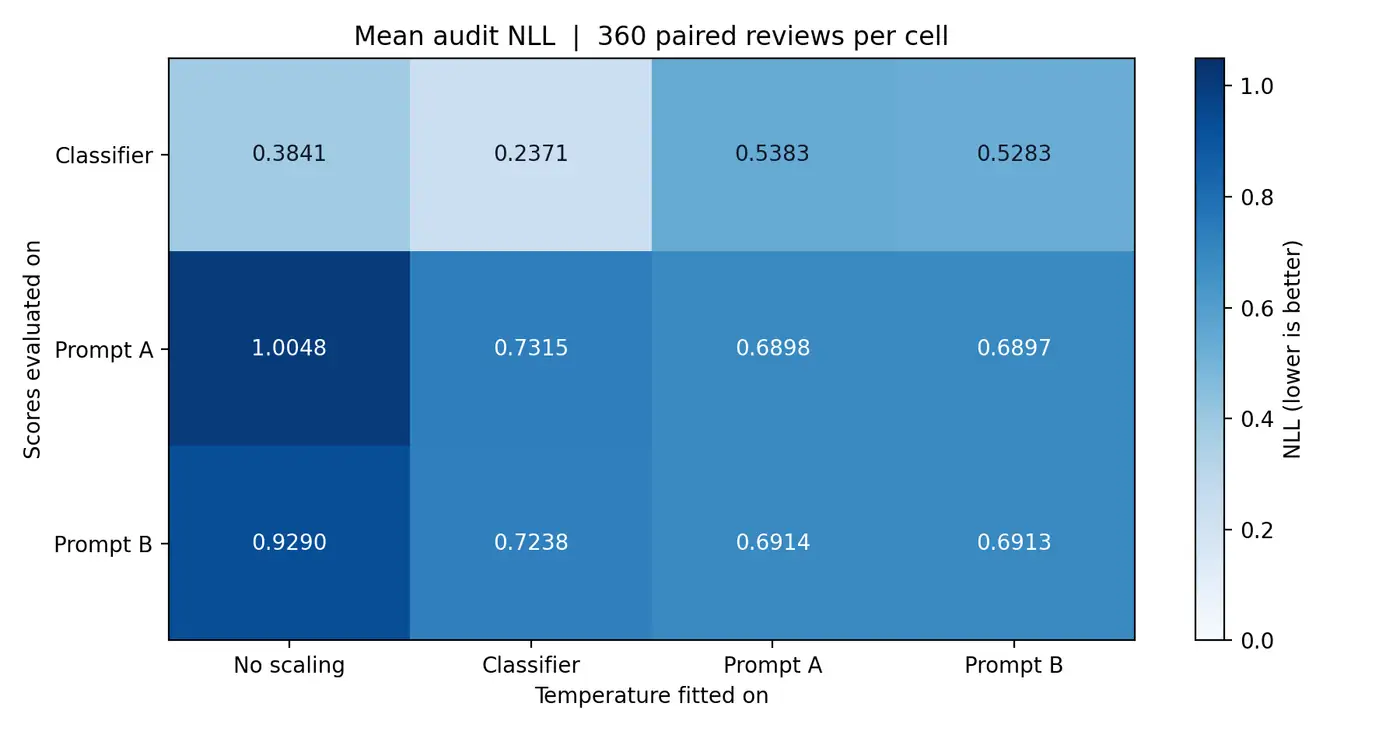
第二行说明两个参照为何都需要。分类器温度让 A 相比单位温度改善了约 0.273,但与 A 自身拟合相比仍多付约 0.042 的平均损失。借来的温度做对了方向,却不足以复现目标上的改善幅度。第三行也是同一方向。不能据此把两个模型的温度平均后当作通用参数,那个折中值没有经过本协议的拟合或验证。
模板之间则出现一个小反例:对 A 的分数,用 B 温度所得的损失甚至略低于用 A 自身温度,差约 0.00013。拟合最优性只针对校准样本,换一批样本后同源参数没有逐次获胜的保证。另一方面,这么小的差也支持不了“负面先问更适合校准”。本实验只有一个固定划分,没有给这种差异做总体显著性推断。只报到两位小数会藏掉这个现象,保留原始精度则容易让人高估它的意义;表格与逐样本文件分别承担展示和复算两种职责。
比损失更值得保留的失败记录
两种模板在三百六十条审计样本上都预测了零个正面,答对的一百七十六条全部来自负面标签。温度变大后,错误仍在,模型只是少给了错误答案一些把握。作为读数参照,对每条都给两类各一半时,平均损失为自然对数二,约 0.69315。两种接口的同源校准读数就在这个值附近。如果只报从一以上降到约零点六九,读者很容易误以为模型学会了区分影评。预测标签计数让这个解释站不住脚。
这也限定了跨模板实验能说多远。两种模板共用词表、参数和候选词,问句顺序改变后的原始损失确实不同,移植温度后却非常接近。作者推断,一个可能原因是两个接口都偏向负面,大温度把它们都推向接近均匀的区域。这里没有加入能产生多样预测的第三种模板,也没有测试同样大小的温度对其他任务的作用。下一项可检验假设是,在校准身份和候选词不变时,如果另一个事前固定的模板能同时预测两类,移植损失和同源损失的差距可能扩大。验证它要用独立的开发协议,不能现在翻看审计样本去挑提示。
官方代码怎么读,最小实验怎么跑
温度缩放的论文背景来自 Guo 等人的分类校准研究。他们报告过在所研究设置中单参数缩放很有效。作者仓库里先看 temperature_scale 对整行 logits 做同一除法,再看 set_temperature 如何用验证损失拟合参数。本文独立实现了有界的一维搜索。论文没有替我们验证这两个语言模型模板的迁移关系,表中的数字都出自本次运行。
读模型时先沿 Transformers 的 LlamaForCausalLM 看最后的词表投影。批大小为一时,输出有批次、上下文位置、词表三维,我们只读最后一个输入位置。每次都把提示和候选拼起来重新分词,检查前缀完全一致且尾部恰有一个词元。如果候选拆成多个词元,当前入口会停止,因为这时必须沿各词元的条件概率累加。分类器则读 DistilBertForSequenceClassification 的两维输出。已有分类器记录由哈希锁住,本次重复使用六百一十六组真实分数,没有把读取缓存计成新的前向。
先用八条影评、每条两个模板做冒烟运行,待身份、长度、词元和输出形状检查通过,再运行正式的两池。CPU 四线程、单精度、固定注意力实现;正式阶段得到一千二百三十二条新计分,含资源校验和载入约四十三秒,进程峰值常驻内存约一点六三 GB。该时间从框架导入之后开始,不能直接与包含下载和解释器启动的耗时相比。逐条记录含身份、标签、上下文长度、形状、候选词元和分数,未分发原句或模型权重。数据卡未明确给出许可证,读者按固定版本从原入口取数。
源码与复现入口
公开固定提交包含源码目录、README及公式与官方实现对照表 SOURCE_MAP。
在源码目录运行 python run.py && python audit.py,用归档的真实分数即可重建结果表和独立核对记录。若要检查神经网络本身,请在新副本中按 README 的下载、冒烟、正式计分顺序执行,再运行分析。固定版本和文件摘要分别保存在资源锁与协议中。重绘热图的入口是 plot.py,输入是由逐条日志汇总的 result.json。只运行分析时应报告“重算指标”,只有执行了模型入口才计入新前向。
排错时先看哪一层失配。如果样本身份或文本摘要变了,应回到数据版本与排序规则。若损失不同但标签完全一致,检查使用的是温度还是逆温度,以及是否忘记正负类顺序。若两个模板的输出逐条完全相同,先比较最终送入模型的词元序列,再检查缓存键是否包含模板与代码版本。最后才考虑优化器。不同机器的浮点尾数可能有差别,保存完整词元与分数能帮助区分数值扰动和接口错误。
总结
在这批影评上,能否借温度,要同时说清参数的来源、接收分数和比较基线。分类器借出的温度缓解了两种提示的过度自信,两种提示借回的温度则损害了分类器。两个提示之间几乎相同的校准损失,和它们共同漏掉全部正面标签的事实,应当一起报告。接下来研究拒答时,还要单独问:留下哪些样本,实际留下多少错误?这张概率损失表回答不了那个问题。
参考资料
检索于 2026-11-06。
- Guo、Pleiss、Sun、Weinberger,2017,分类概率校准的原始实验与温度缩放方法。ICML 论文页面
- Pleiss 等,温度除法与验证集拟合的作者实现。固定源码
- Hugging Face,分类检查点与指令模型固定版本。DistilBERT SST-2、SmolLM2-135M-Instruct
- Stanford NLP,影评二分类的官方标签与数据文件。SST-2 数据
- Transformers 4.49.0,语言模型前向与词表输出。Llama 实现
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。