可信预测实验室:从模型置信度到可检验的拒答
在 SST-2 的第 230 号样本上,模型给负面标签约 0.6403,给正面标签约 0.3597。只能交一个答案时,它选负面,官方标签却是正面。如果事先允许交一个标签集合,第二个标签有没有资格留下?同一批数据里的第 685 号也被错判为负面,可这次正面只拿到约 0.0013。两次错误在准确率表里各占一格,在集合预测里却有了不同的结局。
本篇用一条提前写定的规则处理这两个例子,也处理同一划分的其余所有句子。模型、文本、标签和推理预算沿用前篇,改变的是输出形式。把单个答案改成集合后,审计池多覆盖了三个真标签。代价可以逐句点清楚:九句话各多给了一个候选,其中六句话原本就答对了。
把问题写成一个可以计数的事件
前篇做拒答排序时,覆盖率的分子是模型愿意回答的句子数。这里的覆盖率有另一层含义。每个句子都交回一个集合,即使它为空,也占评测分母的一行。我们数其中有多少行包含官方标签。这样既能评价只交一个答案的分类器,也能评价同时保留正负两类的规则。真标签在两种输出中使用同一列,分母始终相同。
光盯着覆盖率会遇到一个很实际的问题。若每一行都填上正面和负面,任何来自这两个标签的答案都会被覆盖,却也失去了判断情感的用处。因此在登记主要指标时,我们还登记了空集、单元素集合、全集的个数与平均大小。对照组直接取同一个分类头较大的分数,每行恰有一个标签。两种读数共同回答一个受控问题:允许多选之后,额外返回了多少候选,又有多少错误因此得到覆盖?
用校准池中真标签的排名划线
先固定一个已经训练好的分类器。模型为每句话输出两个未经归一化的数,称为 logits;对同一行做 softmax,可得到加和为一的两列分数。为了让每个候选都能与同一条线比较,给候选标签定义不符合度,即它与当前模型判断不相符的程度。这里使用 LAC 的简单分数:
是一句影评, 可以是负面或正面, 是分类器在该列给出的分数。分数越大,候选越难被保留。校准阶段的每句话有官方标签,因而只查真标签所在的那一列。错判的校准样本尤其值得保留,因为真类可能恰恰落在很低的概率区间。若只收集预测正确的样本,门槛所依据的人群就变了;若总取最大概率,恰好把最需要观察的那列跳了过去。
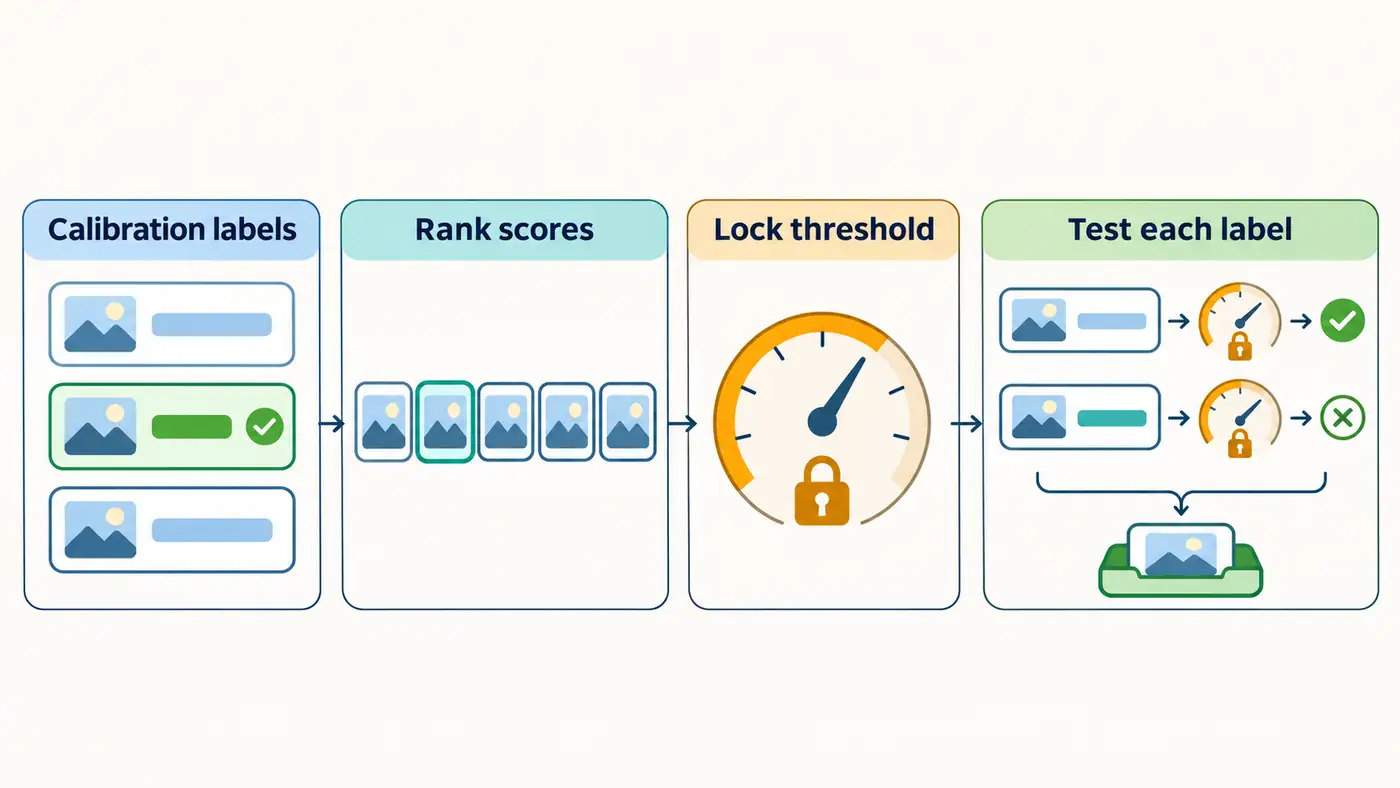
把校准池的真类不符合度从小到大排序,用一个有限样本的秩选出门槛。预测时分别试两个候选,达标的都收入集合:
是校准句子数, 是事先允许的边际漏覆盖概率, 指从一开始数的第 个观测值。若这个秩超出校准样本数,就把门槛视为正无穷。本篇固定 ,用二百五十六条校准样本,故应取第二百三十二小的分数;在程序的零基下标中取第二百三十一项。这样得到的门槛来自一个真实观测值,遇到相等的候选时予以保留。
为什么乘数里多一?可以想象把下一条新样本的真类分数暂时混进校准分数,一共会有二百五十七个位置。如果固定计分规则,且这些样本可交换,即调换顺序不会改变联合分布,那么在没有并列时,新样本落在每个秩上的机会相同。把最靠前的规定数量的位置留给可接受分数,便能在校准集与新样本共同的随机性下控制漏覆盖。并列按包含处理时可能更保守。这个论证并不需要事先承诺分类头的概率刻度已经完美。
最小实验与评测协议
数据来自 Stanford NLP 的 SST-2 validation。系列开始时就按样本编号的固定哈希排序登记了三份名单。最前面二百五十六条用于早期探索,接下来的二百五十六条用于校准,余下三百六十条用于协议审计。程序核对校准与审计的身份、顺序、唯一性和交集。SST-2 在历史研究中已经用过,这批审计样本的表现也在前文出现过,本次是复用公开数据的方法实验。IMDb 的开发、校准及最终确认样本均未参与。
模型采用固定 revision 的英文 DistilBERT SST-2 二分类头,标签零表示负面,标签一表示正面。校准沿用保存的真实 logits,撤去前篇实验特有的温度变换,使用原始尺度。校准步骤在分析程序打开审计预测文件前写出排序及门槛。协议只登记一个目标覆盖水平,没有根据审计结果选择分数、目标水平或空集处理办法。此次比较也没有新增语义标签;判定是否覆盖只需要把集合成员与数据集标签对照。
实际执行先验证缓存的权重、分词器和数据文件摘要,再在 CPU 上用八条句子试跑,核对分类头形状及标签方向。正式推理逐批读取全部审计句子,批量上限十六,长度上限五百一十二个 token,使用四线程与单精度前向。最后一维始终是两个类别,逐行的预测与原档对齐后才做集合分析。正式前向计时约 1.38 秒,进程峰值内存约 0.96 GB,计时不含包安装和权重下载。与存档相比,正式批次 logits 的最大绝对差为零。
九个双标签集合改变了什么
实测不符合度门槛为 0.718652,等价的概率门槛约为 0.281348。回到开头的两句话,第 230 号的两个候选都越过概率门槛,正面作为较小的一列被保留下来。第 685 号只有负面过线,模型曾经自信犯下的错误原样留在结果里。还有一个不同方向的例子:第 527 号的负面约为 0.5354,原本就选对,正面约为 0.4646,也进了集合。这次多给一个候选并没有新增一次覆盖。
| 同一批 360 条审计句子 | 空集 | 单元素 | 双元素 | 真类被覆盖 | 平均集合大小 |
|---|---|---|---|---|---|
| 最大分单标签 | 0 | 360 | 0 | 330/360(91.67%) | 1.000 |
| 固定门槛保形集 | 0 | 351 | 9 | 333/360(92.50%) | 1.025 |
这里可以不用看模型名字就做一次交叉检查。两个概率相加为一,较大者至少为二分之一。校准出来的概率线低于二分之一,所以每行至少有一个候选能过线,空集数必须为零。两个标签都能通过时才会出现全集,九个全集各贡献两个元素,其余各贡献一个,总数为三百六十九。把总数除以三百六十,正好得到表中的平均大小。若此时程序报告了任何空集,就应先排查计算。
九个全集包含所有可能的官方标签,剩余二十七次漏覆盖都发生在单元素集合里。虽然这一次每句话平均只多给了 0.025 个标签,新增的九个候选并非个个换来纠错。把表中的覆盖差解释成准确率提高会漏掉这笔成本:读者拿到双标签集合后仍需要决定如何使用它,而本实验只核验答案是否在里面。也没有用这九句话的文本推断困难来源,分数接近只描述模型给出的数值关系。
还可以换一个分母来定位读表错误。三百五十一句只给一个标签,其中三百二十四句的集合包含真类;把这三百二十四句和九个全集加起来,才得到总覆盖数。如果研究问题转回“只在给出唯一答案时才作答”,回答率应按三百五十一除以三百六十计算,回答中的错误率则按二十七除以三百五十一计算。这两项描述的是额外规定的答题政策,不能拿其中任何一项替换表里的经验覆盖率。
官方代码阅读路线与失败排查
可以沿着实际张量的形状读 TorchCP。先看 LAC 接收一个批次 logits 后如何沿最后一维归一化,再看传入标签时如何按行索引。取真类后,校准矩阵每行留下一个数;不给标签时,两列都保留。接下来读公共分位数函数,检查它如何计算向上取整的秩、如何处理样本不足,最后回到 split predictor,看它如何把整张候选分数矩阵交给集合生成函数。本篇使用独立的标准库实现,源码地图附上核对过的文件和行号,可以逐步对读。
一个常见失败是把九成分位数直接交给默认线性插值函数。读者即便看见两种实现打印出相近的小数,也应先比较取到的秩,再数有多少候选在两条线之间。另一个错误是把不符合度上界拿来当概率下界,代码仍会输出形式正常的集合。检查第 230 号即可区分这两种规则。最后检查评测分母;如果只在给出单元素答案时记分,就悄悄换成了另一项选择性分类实验。
独立复算脚本直接从存档的两列 logits 出发,计算候选列减去另一列的差值。二分类 softmax 下,这个差越大,该候选概率越高。脚本按真类差值从大到小排序,然后用入选位置上的差值逐项比较,绕开主程序的指数计算和概率筛选。两条路径在七百二十次候选判断上全部一致,同时核对了样本身份、官方标签、集合大小与单标签基线。这是可重复执行的算术检查,不涉及重新评断任何影评的情感。
研究问题与总结
论文给出的边际保证和表中某一批的覆盖比例有不同的随机对象。定理考虑重新取得校准样本和新样本时的概率;本次已经固定了一条门槛,数的是同一批三百六十句话里的命中数。观察到 92.50% 可以报告为这批的经验覆盖,单次超过九成不足以验证交换性,也不能据此承诺下一条短评、任一情感类别或换域后的长影评都至少九成可靠。
值得接着检验的是,若数据来源和计分器保持不变,只重新抽取校准名单,门槛的波动会在多大程度上传给审计覆盖?这需要预先写明重分次数并保留每次结果。今天留下的排序、门槛与逐句集合提供了一个可检查的起点。对这一次划分,最明确的结论是:模型仍有三十次单标签错误,九次多选只补回了其中三次,其余二十七次都能在逐行记录中定位。
源码与复现入口
固定版本已公开,可从本篇源码目录进入,按复现说明运行,或对照公式与官方代码映射检查实现。
在源码目录执行 python run.py,即可从随附的真实模型输出重建门槛、逐句集合和汇总表;再执行 python audit.py 检查计数。需要从原始文本开始的读者可按说明下载锁定资源并重放推理。源码包仅提供派生预测和样本身份,原始影评与模型权重由固定来源获取。
参考资料
检索日期为 2026-11-12。
- Angelopoulos、Bates,《A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification》,2021 年首次公开。分割保形的构造与覆盖定理见第一节。作者全文
- SUSTech-ML,TorchCP,固定版本的分类计分器。LAC 实现
- Hugging Face,英文 SST-2 分类头与标签配置。模型固定版本
- Stanford NLP,SST-2,validation 划分与数据身份。数据固定版本
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。