复现目标:校准集上更漂亮,能否带到下一组样本?
上一实验说明,几十条样本可能把温度推到搜索边界。本篇再增加一个受控问题:如果允许校准函数弯曲、形成平台,它是否比只有一个参数的温度缩放更可靠?我们固定模型、原始预测、校准身份和审计身份,只更换后处理方法,同时保留一个预先登记的小样本条件。
本次实际验证给出的答案是否定的,但范围有限:使用完整二百五十六条校准样本时,保序回归在拟合数据上损失更低,在三百六十条审计样本上却没有超过温度缩放;它还给七个错误答案分配了确定性的错误概率。这是一次可复算的方法实验,不是所有数据集上的方法排名,也不是开放生成可靠性的结论。
核心思想:一个旋钮与一条可以弯曲的曲线
温度缩放只改变两个类别分数之间的距离。正温度不会翻转大小关系,因此类别预测保持不变。保序回归则寻找一个非递减映射:原正类概率更大的样本,校准后的正类概率不能更小;但相邻样本可以落到同一平台。这里的“保序”允许并列,不等于严格保存全部排序,也不保证原来的分类阈值保持有效。
论文报告方面,Guo、Pleiss、Sun 与 Weinberger 在二〇一七年的研究中发现,单参数温度缩放在其多项实验中有效。这是选择简单对照的理由,不是本实验结果的替代证据。论文与会议记录
官方文档将保序回归定义为带单调约束的最小二乘问题,并提醒校准样本少时应注意过拟合。这里我们直接调用固定版本的官方实现,而不是把教学近似当作该库。保序回归文档、概率校准文档
公式与评测对象
对每个输入,模型产生两个原始分数,也就是 logits。记它们为 ,正类标签为 ,分数差为 。温度变换为:
这里 是正面情感类别的概率, 是在校准子集上拟合的一个标量;模型批量输出形状是 ,后处理概率向量形状是 。我们继承有界逆温度求解器,用校准集负对数似然确定参数,边界与迭代规则均不依赖审计结果。
保序回归使用原始正类概率 作为横坐标,寻找映射 :
是本次拟合样本数, 是该样本的校准概率。函数约束方向显式设为递增,不让程序根据相关性自动选择。两种方法优化目标不同,故这是常用方法整体比较,不能解释成只增加参数数量的纯因果实验。
主要指标为双类别求和 Brier 分数,即概率与标签之间的平方距离:
是评测样本数, 是某方法输出的正类概率;因子二来自两个类别的误差相加。辅助指标为负对数似然,即 NLL。对真正的零真类概率,数学上的损失是无穷大。为了仍能比较有限表格,协议另外预设 ,只在计算展示用 NLL 时将真类概率限制到 。拟合、Brier、分类与边界计数始终使用未截断概率。
官方代码阅读路线
先读固定提交中的 IsotonicRegression._build_y:排序、合并重复横坐标、进行带权保序拟合,再删去不影响预测的冗余平台点。随后读 _build_f 与 _transform:官方预测会在保留结点之间线性插值,超出校准横坐标范围时,本实验明确选择端点截取。因此“保序函数是阶梯”只是直观示意,不能据此自行实现为处处阶梯常数。固定源码
本次核验了版本一·六·一对应的真实提交,并逐字节确认安装的模块与官方文件一致。标签对象与提交对象不同,首次直接用带注释标签对象读取文件返回不存在,解析实际提交后成功;该失败保留在核验记录中。源码地图区分官方库调用、继承的自写温度求解器与独立复算脚本,许可证为官方 BSD 三条款及各继承模块记录的许可。
最小实验:同数据、同模型、不同映射
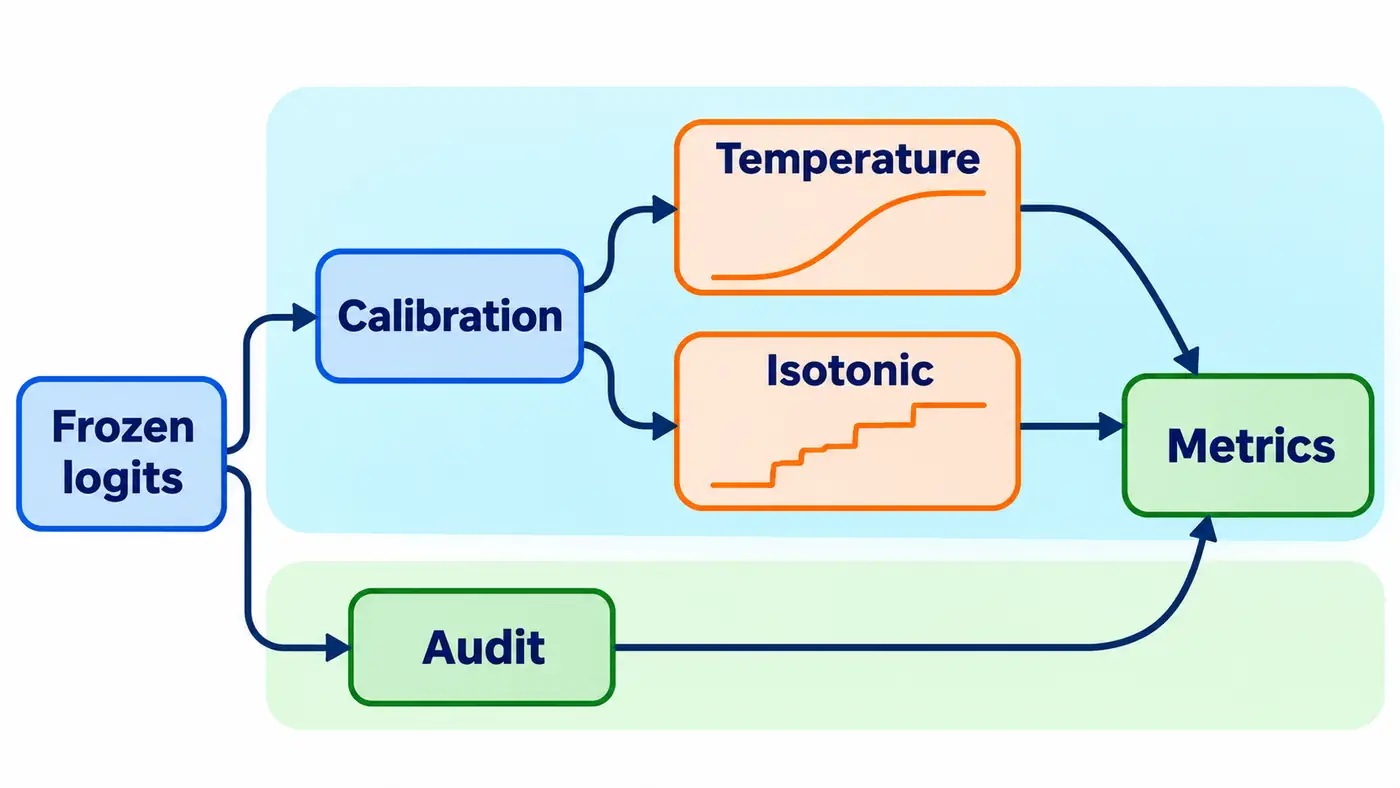
模型沿用固定 DistilBERT SST-2 检查点;数据沿用官方 validation 的身份清单。原始划分按身份哈希固定,探索池二百五十六条、校准池二百五十六条、协议审计池三百六十条互不相交。本篇只复用后两池在前篇保存的真实 logits,不重新筛选句子,不新增语义标注。
SST-2 已在历史实验中使用,审计结果也在前两篇被观察。因此这里的“独立”只指未进入当前校准拟合,不能写成从未见过的测试集。IMDb 三池本次均未推理,最终确认池保持未使用。
本篇预先冻结身份排序规则,取哈希前三十二条和完整二百五十六条形成嵌套条件。每个条件同时拟合温度与保序回归,完整输出原始概率对照。不换种子寻找更典型案例,不根据审计集选样本量、映射或截断参数。三十二条恰好全部预测正确,是执行后发现并保留的现象,不是挑出的“最佳校准集”。
运行使用已有固定模型缓存,先校验文件哈希,再执行八条真实 CPU 试跑,重新取得形状为八行两列的输出。正式方法比较复用六百一十六条历史模型预测;不能称为今天重新完成六百一十六次模型前向。本次新增分析实测约零点零二五秒,进程峰值内存约九十六 MiB;八条试跑前向约零点零七五秒,导入后的流程约零点五四八秒,完整环境与内存记录随源码保存。下载使用已校验缓存,本次不报告新的下载耗时。新增执行的是四次拟合、十二组评测以及独立算术核验,没有模型训练或付费计算。
结果:更低的拟合误差没有转化为更好的审计表现
下表均是三百六十条审计样本的实际结果。NLL 列使用预设截断规则,所有方法共享相同分母;未经截断的保序 NLL 在两种样本量下都为无穷大。
| 校准量 | 方法 | Brier | 截断 NLL | 正确数 |
|---|---|---|---|---|
| 不拟合 | 原始概率 | 0.154001 | 0.384113 | 330 |
| 32 | 温度缩放 | 0.166945 | 1.145233 | 330 |
| 32 | 保序回归 | 0.154905 | 0.614199 | 330 |
| 256 | 温度缩放 | 0.135151 | 0.237136 | 330 |
| 256 | 保序回归 | 0.137395 | 0.420606 | 329 |
完整校准池上,保序回归拟合 Brier 为零点一一五八六七,低于温度缩放的零点一四七三八五;审计集排序却反过来。其审计输出有二百四十九条处于零或一,其中七条把真实类别概率置零。温度为约二点四八一九时,输出没有边界概率。这说明不能只看校准集曲线是否贴合标签,也不能只报告被截断后的有限 NLL。
小样本条件更值得保留。三十二条全部正确,把温度推到零点零五的下界;保序回归则在拟合样本上取得零 Brier。二者到了审计集都比原始概率差。保序回归有十一条真类概率为零,但 Brier 只略微变差:平方损失有界,对数损失对绝对错误的确信极其敏感,两者回答的是不同问题。
温度的小样本结果还暴露了数值陷阱。有限 logits 与正温度在数学上不会产生精确零概率,但浮点 sigmoid 可以舍入到一,随后用一减它会得到零。因此新增一个明确标记的事后数值诊断:用稳定 softplus 直接从 logits 算未截断 NLL。该条件稳定未截断 NLL 为七点二七一三一四,仍然很差,但有限。它不改变预登记主指标、不重新选择温度,也不把舍入事件误报成数学上的无穷损失。
失败排查与独立复算
第一步应检查身份,不是调参数。确认两种方法使用完全相同的校准编号,校准与审计不重叠,输入文件哈希与协议一致。第二步检查概率对象:这里校准的是正类概率,不是最大类别置信度;混用二者会改变标签含义。第三步检查插值与外推规则,尤其是重复横坐标和校准范围之外的预测。
独立审计没有再次调用官方拟合器,而是用保序最小二乘的区间平均最小最大表述重建拟合值,再独立插值,逐项核对所有输出与指标。最大概率差约为一乘十的负十六次方。模型试跑另与历史八条输出按身份比较,允许有记录的浮点误差,但要求类别一致。算术审计不是人工标签审查;本篇未产生需要真人判断的新语义标签。
源码与复现入口
公开固定版本已核验:源码目录、README、SOURCE_MAP。配套包包含统一入口、官方模型下载与试跑脚本、固定依赖、配置、协议、源码地图、逐样本派生结果和审计脚本。最小运行命令为:
python -m pip install -r requirements.txt
python run.py
python audit.py
预期生成 results.json、analysis_environment.json 与 audit_result.json。模型缓存可用时另执行 python model_run.py smoke --cache .cache;首次使用先运行对应的 prepare 命令。下载约需二百七十兆模型资源,默认 CPU 四线程,预算三十分钟与六 GiB 内存。原始句子因数据卡许可不明确不随包分发,下载脚本固定官方 revision,已有缓存必须通过哈希检查。
还有一个容易混淆的地方是标签阈值。温度缩放仍以原始分数差的正负作分类,保序回归却可能移动概率跨越二分之一的位置,也会制造平台并列。本篇统一约定严格大于二分之一才预测正类,相等时预测负类。因此完整池条件下正确数从三百三十降到三百二十九,是实际映射及阈值共同产生的结果,不应将它悄悄改回原始类别后再报告准确率。
同样,审计样本量较大并不自动意味着比较可靠。两种方法共享审计样本,损失差是配对观测;本篇没有为差值构造区间,也没有对多组候选作显著性检验。零点零零二左右的 Brier 差只能作为本次固定样本的描述。边界错误更适合帮助提出下一步假设,不能替代跨划分、跨数据域的验证。
可检验的后续问题与总结
作者推断是:灵活映射在稀疏分数区域缺少错误观察时,更容易把局部纯净误当确定性。但当前只有一个固定小样本子集与一个完整池,不能估计这一现象的发生频率,更不能宣布方法普遍胜负。后续若要比较平滑保序、概率截断或更多校准样本,应另行登记候选与选择规则,不能拿本篇审计结果反复选出最好组合后继续称独立评测。
下一篇将改变校准集类别比例,检查全局温度能否同时照顾两类。本篇留下的可审查结论更克制:相同数据下,拟合误差下降不保证审计概率质量提高;边界概率与数值舍入必须分开;分类正确数、平方损失、对数损失也不能互相替代。这些失败本身就是连续研究需要保存的证据。
参考资料
检索与源码核验日期:2026-11-04。
- Guo, C., Pleiss, G., Sun, Y., Weinberger, K. Q. 2017. On Calibration of Modern Neural Networks,ICML / PMLR 70。
- scikit-learn 官方:Isotonic regression 与 Probability calibration。动态文档只作概念来源,实际执行版本固定为 1.6.1。
- scikit-learn 1.6.1:固定提交源码。
- DistilBERT 固定模型卡。
- SST-2 固定数据版本。
作者作品推广
以下是作者自有产品推广。除了科研博客,我也独立开发日常小工具:日常收支小记用于记录收支、安排预算与储蓄目标;一事微光帮助按时间、精力选择小行动,并记录完成后的感受。欢迎按自己的需要了解,也可以到个人网站阅读更多文章与作品介绍。这些产品与本文论文、实验结果及研究机构没有背书关系。