可信预测实验室:从模型置信度到可检验的拒答
如果只允许回答四分之三的影评,应当先留下哪些?上一篇用分类器的最大概率排队,保留了二百七十条,其中八条答错。一个自然的改进是换个打分规则。例如,用熵衡量模型在几个答案之间有多犹豫,或者直接看第一名领先第二名多少。今天的复现从一个更便宜的问题开始:在这个模型上,换一种规则,有没有可能换掉哪怕一条被接受的影评?
本次实际验证。 在固定的三百六十条 SST-2 预测里,三种规则给出的名单从第一名到最后一名完全相同。这个结果可以从二分类的数学结构推出,但程序仍然值得运行。证明讨论精确实数,实验要面对有限精度、分数方向、行序和标签映射。我们保存了每条样本的三个分数,可以找到两条紧挨着阈值的真实记录,查看一次看似无害的舍入会丢掉什么。
从两个输出看清排序的自由度
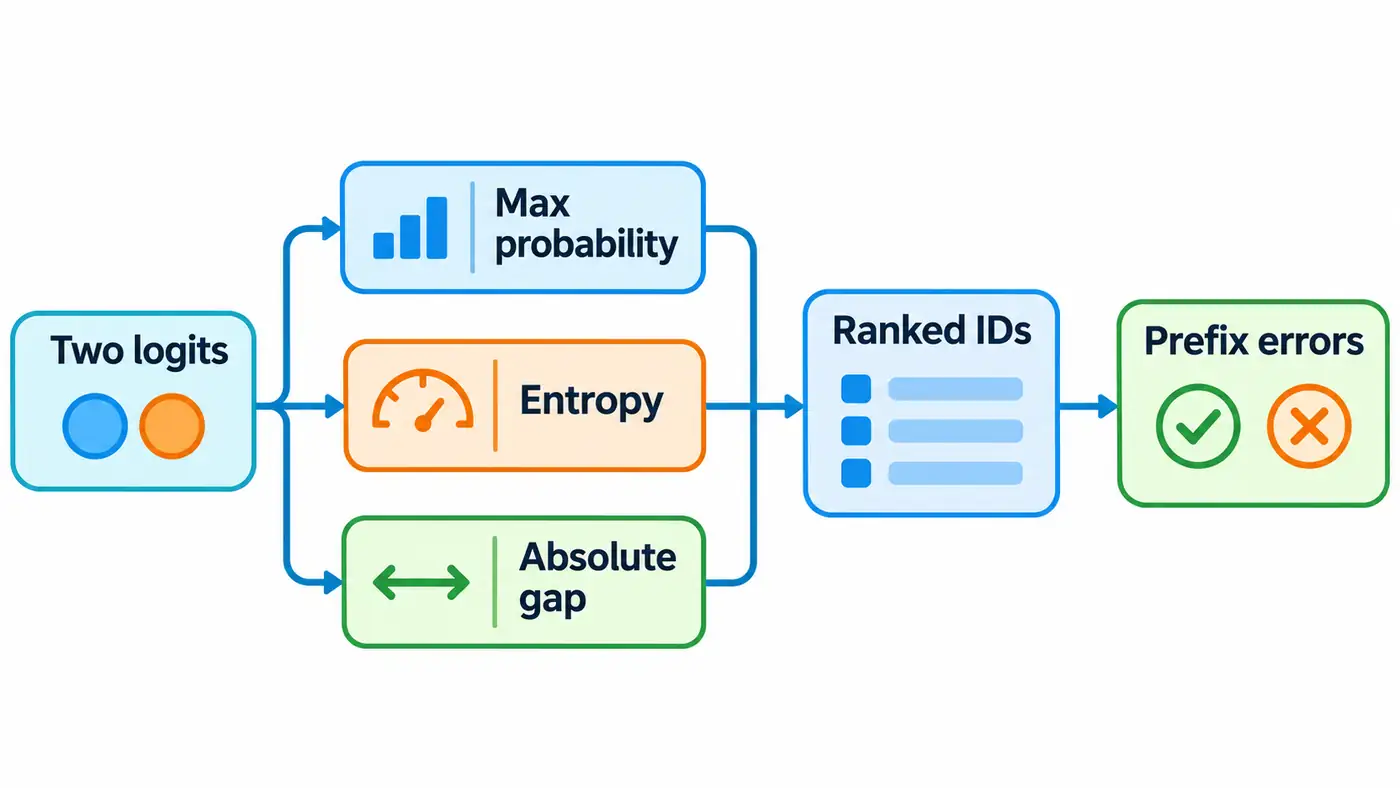
分类头为一条输入返回两个未经归一化的实数,称为 logits。分别记为 和 ,对应负面和正面。两个值都加上同一个常数,做 softmax 时,分子分母会同时乘上同一因子,概率不变。交换两个值会翻转预测类别,却不会改变模型对获胜类别的把握。去掉这两个与把握无关的因素,剩下的是两者离得有多远。
这里 是本文的“分数差”,具体取原始输出的绝对差。 是归一化后的两个概率, 是较大的那个。差距为零时两类平分概率;差距越大,获胜概率越接近一。因而按绝对差从大到小排队,与按最大概率从大到小排队,任意两条记录的先后关系都一样。如果习惯把“分数差”定义成前两名的概率差,也可以直接验算,二分类时它等于 。本次程序只实现前一种定义。
熵把整行概率都纳入计算。恰好在两类问题中,只要知道获胜概率,另一类的概率也就确定了。用自然对数,二元预测熵及其对获胜概率的导数为
描述一行预测分布的集中程度。只要 ,导数就小于零;端点二分之一对应最大熵,向右走函数严格下降。所以要先回答看起来最确定的样本,熵应当升序排列。三个分数的单位和数值各不相同,同一名次却可以互相换算。这个证明完全用不到情感标签。即使模型把某句影评很自信地判断错了,这句话也会同时骗过这三条规则。
把证明改写成一个可能失败的实验
论文报告。 Geifman 与 El-Yaniv 将选择性分类写成预测函数和选择函数的组合,并研究如何在风险约束下保留更多回答。我们沿用其中的覆盖率和选择性风险定义。本篇额外固定接受数量,在这一个数量下追踪被留下的样本身份。论文中的风险控制还需要相应的估计程序与假设,这里只报告有限样本上的实际错误。
实验的唯一变量是排序键。锁定 DistilBERT 的 SST-2 分类检查点、分词器、原始句子身份、推理配置与输出。上一篇已经观察过这批数据,知道总共有三十个错误,也看过最大概率的曲线。本篇在计算三路排序前写下比较规则,因而是已知背景上的方法核验。SST-2 在更早的系列中也使用过,本文不会从这批记录估计对从未接触数据的保证。IMDb 的开发、校准和最终确认池均未使用。
每一路都在原精度分数上排序,只有精确相等才按公开样本编号升序处理。在排序结束后才用原始情感标签计错。设总样本数为 ,取前 条,第 个名次的错误指示量为 ,预测错取一,正确取零。则覆盖率和接受风险分别为
的分母随接受数量而变。拒绝全部样本时,覆盖率为零,错误数也是零,但无法计算条件错误率;程序在该格写入空值。主要检验同时比较完整身份序列和从零到全收的每个前缀。只比风险数值会漏掉一种错误:把两条都答对的样本交换位置,风险曲线可以纹丝不动。只比一个百分位又会漏掉阈值两侧以外的错位。因此预先约定检查所有位置,并保留首个分歧的位置,方便失败时直接定位。
官方代码阅读路线与最小实验
先看模型卡的任务和分类标签,再读 Transformers 固定版本中 DistilBertForSequenceClassification 的 forward。它从编码器输出取首位置的表示,随后经过预分类层、激活、丢弃层和最终分类层,返回每类的原始分数。复现时设为评估模式,关闭丢弃层的随机性。从这里到拒答名单还有两步,分别是沿类别维归一化、沿样本维排序。前者在同一句的两个输出之间比较,后者才决定两句话谁先回答。混淆这两个维度,得到的数组在形状上仍可能十分整齐。
从固定资源缓存核对权重、词表与验证文件的摘要,按已登记的身份列表取历史审计池。抽取开头八条做真实试跑,核对原标签、文本摘要、预测类别以及输出形状,再以每批最多十六条重放全部三百六十条。批内使用填充,保留长度上限五百一十二;前向使用四个 CPU 线程和单精度,排序计算在 Python 浮点数上进行。八条属于正式集合,不能当成额外八个观测。没有训练、温度拟合或阈值搜索。
本次正式前向实测约 1.25 秒,进程峰值常驻内存为 963,903,488 字节。这里的前向计时包括逐批分词和收集记录,完整进程还有导入与模型加载开销。八条试跑与归档 logits 的最大绝对差约为 ,预测类别一致;按正式批次重放全部样本时最大差为零。为使不同文章共享同一个比较对象,排序入口读取已经锁定的归档,模型重放单独保存输出,避免新运行悄悄改写比较基准。
两条挨着接受线的影评
三路各得到三百六十个互不相同的分数,没有触发同分裁决。第 270 名是编号 382,最大概率约为 0.996946,熵约为 0.020737,绝对差约为 5.788205。紧随其后的编号 505,三项分别为 0.996938、0.020782、5.785638。先看第一项,前者略大;看第二项,前者略小;看第三项,前者又略大。三次比较都留下编号 382。如果把概率先显示成三位小数,两者看上去同为 0.997。复制报表上的数值重新排序,就把谁能入选的一部分决定权交给了同分规则。
| 接受条数 | 覆盖率 | 接受集错误数(三路相同) | 接受集错误率 |
|---|---|---|---|
| 180 | 50% | 3 | 1.67% |
| 270 | 75% | 8 | 2.96% |
| 324 | 90% | 17 | 5.25% |
| 360 | 100% | 30 | 8.33% |
按预先指定的四分之三覆盖率,留下的八个错误完全相同,另外二十二个错误进入拒答集。拒答的九十条中还包含六十八个原本能答对的例子。这笔代价在每一种表示下都要支付。增加覆盖率时,错误数只能持平或上升,但错误率可能回落:从第二百七十名继续接受下一条,分子依然是八,分母多了一。作图时分别写明纵轴是错误数还是错误率,否则一个向下的小台阶就可能被误读成数据异常。
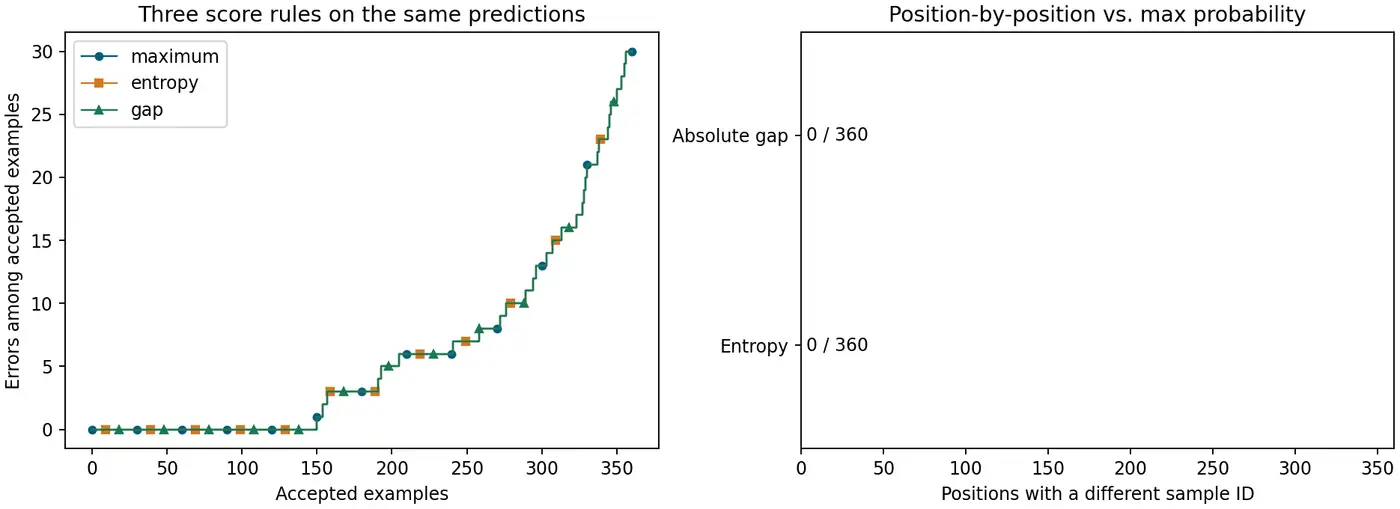
左图的标记位置错开,以便看见三路数据落在同一条阶梯上。右图单独问了更严格的问题:对照最大概率名单,熵和绝对差分别有几个位置排入了不同身份?两次都是零。把三条曲线的面积各报一遍不会增加独立证据,把三条曲线的离散程度当作算法稳定性更会低估不确定性。关于未来样本还有多少错误,信息量仍受这一次审计的样本数和错误数限制。
失败排查与独立复算
若复现得到熵明显更差,优先抽取排名首尾各一条,确认最高熵的记录落在哪一端。若绝对差把一种情感集中排到后面,检查是否直接使用了有符号的正类分数减负类分数。那样计算时,一个坚定的负面预测和一个犹豫的负面预测都会得到负值,方向跟着情感走。若只有少量名次不合,先查完整精度和排序的第二关键字,再对照文本摘要、批次和分词设置。凭曲线形状很难区分同分重排与拿错输入。
独立脚本从锁定文件重新读取两列原始输出,用六十位十进制运算计算较小概率,再以互补关系得到较大概率和熵。它逐行重建错误指示,逐路重排名次,对每个接受集合从头数错。主程序用普通浮点指数归一化和累计计数,两条计算路径可以暴露不同的程序错误。此次一千零八十个分数、三个身份序列、一千零八十三个前缀全部核对通过。脚本、输入摘要、命令、退出码和结果一起归档。这些是确定性的算术证据,标签直接取自公开划分,没有新增语义标注。
研究问题与总结
作者推断。 想在这里超越最大概率,需要一个在获胜概率相同时仍有机会提供新信息的信号。一个可检验的边界来自多分类:设两个三类预测都给第一类分配六成概率,其余四成可以几乎都给第二类,也可以由余下两类平分。此时最大概率相同,熵却随剩余概率的分配而变。这是说明证明依赖什么条件的构造,并非本次测得的多分类收益。另一种容易改变名单的情形是低精度量化把许多不同值压成同分,届时应单列并列规模和裁决规则。
本次实验把两个问题拆开了。谁先回答,在这个固定二分类头上可以由一个绝对差完全决定;留下多少错误,则要回到有标签的样本逐个计数。前一个问题有代数证明和程序核验,后一个问题在四分之三覆盖率下只观测到八次错误。下一步值得问的是,这么少的事件容许对拒答收益作多精确的判断。重复命名同一条排序提供不了新的观测。
源码与复现入口
固定版本已公开,可从本篇源码目录进入,按复现说明运行,或对照公式与官方代码映射检查实现。
从源码目录运行以下最小命令,使用归档的真实模型输出生成排名并独立复算。
python run.py && python audit.py
结果文件 ranking.json 包含逐行分数、三份完整身份列表和逐个前缀的错误数。希望从句子重新得到分数的读者可依照 README 准备固定资源,再执行八条试跑和完整审计池重放。源码地图给出了官方分类头的固定行号、许可证与本地入口,运行日志保留了每批的输入与输出形状。这样可以分别检查误差出现在分类头,还是发生在读出分数之后。
参考资料
检索日期为 2026-11-08。
- Geifman 与 El-Yaniv,Selective Classification for Deep Neural Networks,NeurIPS 2017
- Hugging Face,DistilBERT SST-2 固定检查点及词表
- Stanford NLP,SST-2 固定验证划分
- Transformers 4.49.0,DistilBERT 官方分类头固定源码
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。