可信預測實驗室:從模型置信度到可檢驗的拒答
如果只允許回答四分之三的影評,應當先留下哪些?上一篇用分類器的最大概率排隊,保留了二百七十條,其中八條答錯。一個自然的改進是換個打分規則。例如,用熵衡量模型在幾個答案之間有多猶豫,或者直接看第一名領先第二名多少。今天的復現從一個更便宜的問題開始:在這個模型上,換一種規則,有沒有可能換掉哪怕一條被接受的影評?
本次實際驗證。 在固定的三百六十條 SST-2 預測裡,三種規則給出的名單從第一名到最後一名完全相同。這個結果可以從二分類的數學結構推出,但程序仍然值得運行。證明討論精確實數,實驗要面對有限精度、分數方向、行序和標籤映射。我們保存了每條樣本的三個分數,可以找到兩條緊挨著閾值的真實記錄,查看一次看似無害的舍入會丟掉什麼。
從兩個輸出看清排序的自由度
分類頭為一條輸入返回兩個未經歸一化的實數,稱為 logits。分別記為 和 ,對應負面和正面。兩個值都加上同一個常數,做 softmax 時,分子分母會同時乘上同一因子,概率不變。交換兩個值會翻轉預測類別,卻不會改變模型對獲勝類別的把握。去掉這兩個與把握無關的因素,剩下的是兩者離得有多遠。
這裡 是本文的“分數差”,具體取原始輸出的絕對差。 是歸一化後的兩個概率, 是較大的那個。差距為零時兩類平分概率;差距越大,獲勝概率越接近一。因而按絕對差從大到小排隊,與按最大概率從大到小排隊,任意兩條記錄的先後關係都一樣。如果習慣把“分數差”定義成前兩名的概率差,也可以直接驗算,二分類時它等於 。本次程序只實現前一種定義。
熵把整行概率都納入計算。恰好在兩類問題中,只要知道獲勝概率,另一類的概率也就確定了。用自然對數,二元預測熵及其對獲勝概率的導數為
描述一行預測分佈的集中程度。只要 ,導數就小於零;端點二分之一對應最大熵,向右走函數嚴格下降。所以要先回答看起來最確定的樣本,熵應當升序排列。三個分數的單位和數值各不相同,同一名次卻可以互相換算。這個證明完全用不到情感標籤。即使模型把某句影評很自信地判斷錯了,這句話也會同時騙過這三條規則。
把證明改寫成一個可能失敗的實驗
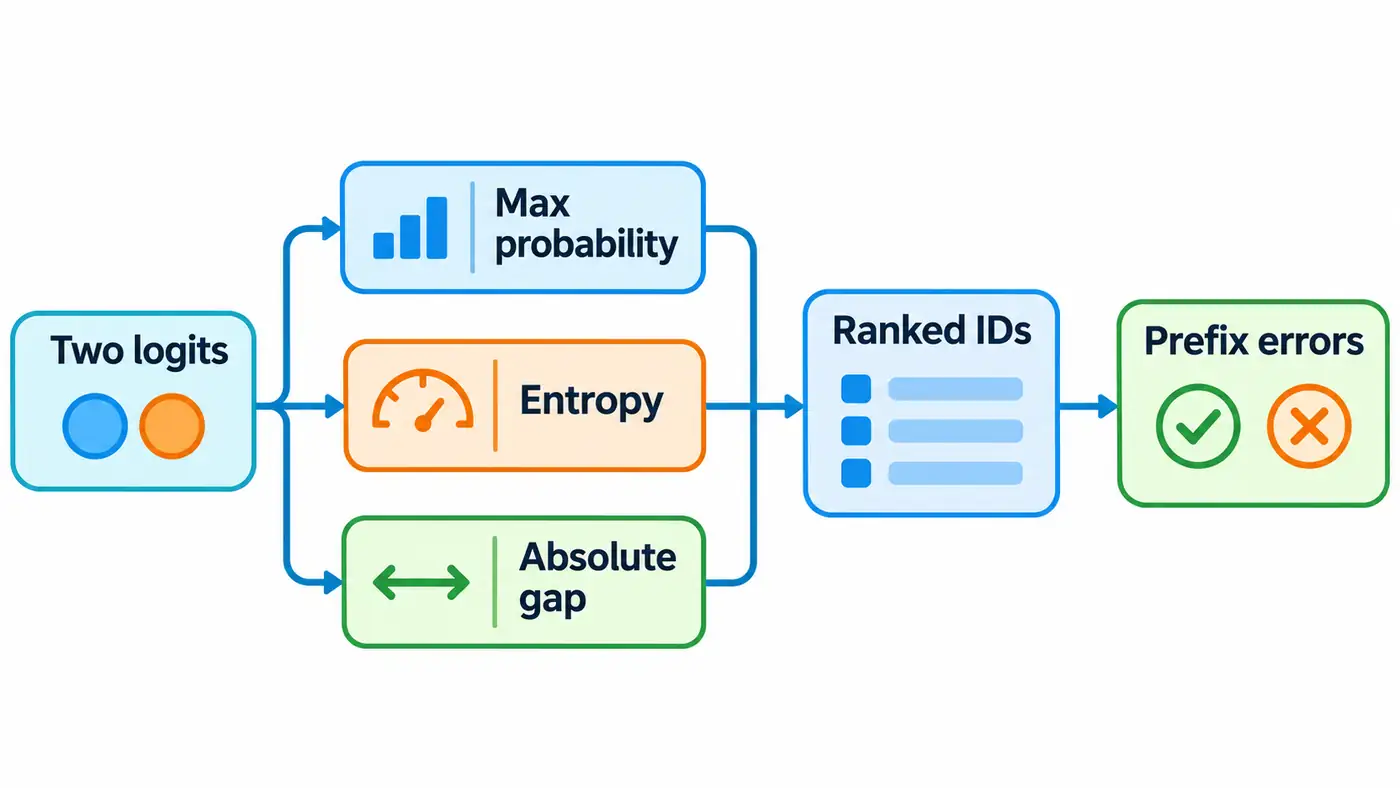
論文報告。 Geifman 與 El-Yaniv 將選擇性分類寫成預測函數和選擇函數的組合,並研究如何在風險約束下保留更多回答。我們沿用其中的覆蓋率和選擇性風險定義。本篇額外固定接受數量,在這一個數量下追蹤被留下的樣本身份。論文中的風險控制還需要相應的估計程序與假設,這裡只報告有限樣本上的實際錯誤。
實驗的唯一變量是排序鍵。鎖定 DistilBERT 的 SST-2 分類檢查點、分詞器、原始句子身份、推理配置與輸出。上一篇已經觀察過這批數據,知道總共有三十個錯誤,也看過最大概率的曲線。本篇在計算三路排序前寫下比較規則,因而是已知背景上的方法核驗。SST-2 在更早的系列中也使用過,本文不會從這批記錄估計對從未接觸數據的保證。IMDb 的開發、校準和最終確認池均未使用。
每一路都在原精度分數上排序,只有精確相等才按公開樣本編號升序處理。在排序結束後才用原始情感標籤計錯。設總樣本數為 ,取前 條,第 個名次的錯誤指示量為 ,預測錯取一,正確取零。則覆蓋率和接受風險分別為
的分母隨接受數量而變。拒絕全部樣本時,覆蓋率為零,錯誤數也是零,但無法計算條件錯誤率;程序在該格寫入空值。主要檢驗同時比較完整身份序列和從零到全收的每個前綴。只比風險數值會漏掉一種錯誤:把兩條都答對的樣本交換位置,風險曲線可以紋絲不動。只比一個百分位又會漏掉閾值兩側以外的錯位。因此預先約定檢查所有位置,並保留首個分歧的位置,方便失敗時直接定位。
官方代碼閱讀路線與最小實驗
先看模型卡的任務和分類標籤,再讀 Transformers 固定版本中 DistilBertForSequenceClassification 的 forward。它從編碼器輸出取首位置的表示,隨後經過預分類層、激活、丟棄層和最終分類層,返回每類的原始分數。復現時設為評估模式,關閉丟棄層的隨機性。從這裡到拒答名單還有兩步,分別是沿類別維歸一化、沿樣本維排序。前者在同一句的兩個輸出之間比較,後者才決定兩句話誰先回答。混淆這兩個維度,得到的數組在形狀上仍可能十分整齊。
從固定資源緩存核對權重、詞表與驗證文件的摘要,按已登記的身份列表取歷史審計池。抽取開頭八條做真實試跑,核對原標籤、文本摘要、預測類別以及輸出形狀,再以每批最多十六條重放全部三百六十條。批內使用填充,保留長度上限五百一十二;前向使用四個 CPU 線程和單精度,排序計算在 Python 浮點數上進行。八條屬於正式集合,不能當成額外八個觀測。沒有訓練、溫度擬合或閾值搜索。
本次正式前向實測約 1.25 秒,進程峰值常駐內存為 963,903,488 字節。這裡的前向計時包括逐批分詞和收集記錄,完整進程還有導入與模型加載開銷。八條試跑與歸檔 logits 的最大絕對差約為 ,預測類別一致;按正式批次重放全部樣本時最大差為零。為使不同文章共享同一個比較對象,排序入口讀取已經鎖定的歸檔,模型重放單獨保存輸出,避免新運行悄悄改寫比較基準。
兩條挨著接受線的影評
三路各得到三百六十個互不相同的分數,沒有觸發同分裁決。第 270 名是編號 382,最大概率約為 0.996946,熵約為 0.020737,絕對差約為 5.788205。緊隨其後的編號 505,三項分別為 0.996938、0.020782、5.785638。先看第一項,前者略大;看第二項,前者略小;看第三項,前者又略大。三次比較都留下編號 382。如果把概率先顯示成三位小數,兩者看上去同為 0.997。複製報表上的數值重新排序,就把誰能入選的一部分決定權交給了同分規則。
| 接受條數 | 覆蓋率 | 接受集錯誤數(三路相同) | 接受集錯誤率 |
|---|---|---|---|
| 180 | 50% | 3 | 1.67% |
| 270 | 75% | 8 | 2.96% |
| 324 | 90% | 17 | 5.25% |
| 360 | 100% | 30 | 8.33% |
按預先指定的四分之三覆蓋率,留下的八個錯誤完全相同,另外二十二個錯誤進入拒答集。拒答的九十條中還包含六十八個原本能答對的例子。這筆代價在每一種表示下都要支付。增加覆蓋率時,錯誤數只能持平或上升,但錯誤率可能回落:從第二百七十名繼續接受下一條,分子依然是八,分母多了一。作圖時分別寫明縱軸是錯誤數還是錯誤率,否則一個向下的小臺階就可能被誤讀成數據異常。
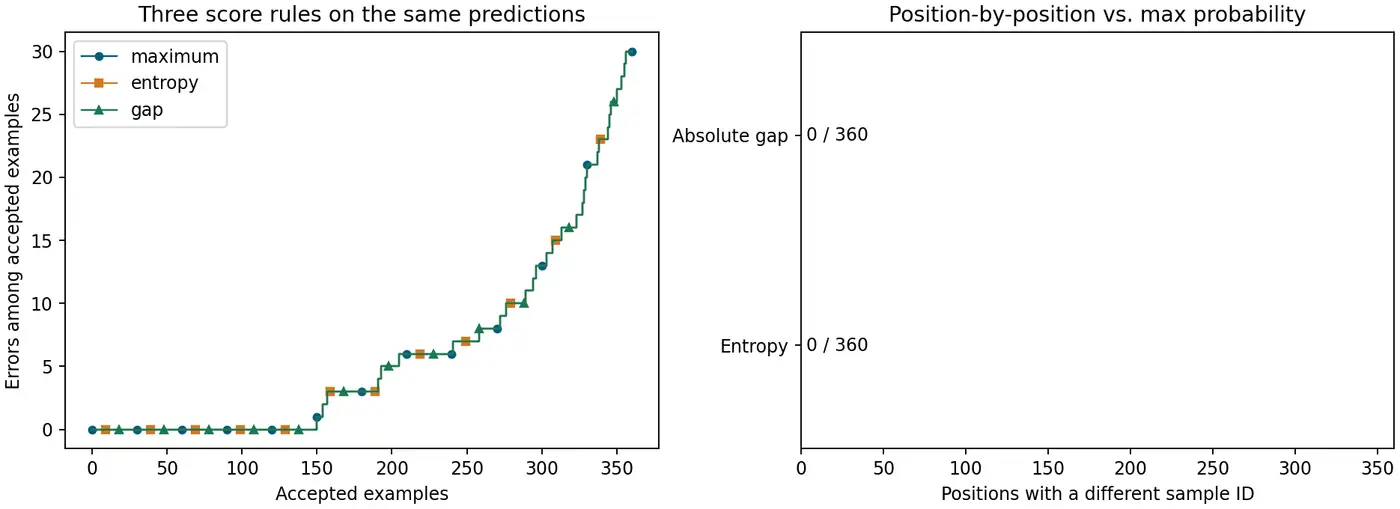
左圖的標記位置錯開,以便看見三路數據落在同一條階梯上。右圖單獨問了更嚴格的問題:對照最大概率名單,熵和絕對差分別有幾個位置排入了不同身份?兩次都是零。把三條曲線的面積各報一遍不會增加獨立證據,把三條曲線的離散程度當作算法穩定性更會低估不確定性。關於未來樣本還有多少錯誤,信息量仍受這一次審計的樣本數和錯誤數限制。
失敗排查與獨立復算
若復現得到熵明顯更差,優先抽取排名首尾各一條,確認最高熵的記錄落在哪一端。若絕對差把一種情感集中排到後面,檢查是否直接使用了有符號的正類分數減負類分數。那樣計算時,一個堅定的負面預測和一個猶豫的負面預測都會得到負值,方向跟著情感走。若只有少量名次不合,先查完整精度和排序的第二關鍵字,再對照文本摘要、批次和分詞設置。憑曲線形狀很難區分同分重排與拿錯輸入。
獨立腳本從鎖定文件重新讀取兩列原始輸出,用六十位十進制運算計算較小概率,再以互補關係得到較大概率和熵。它逐行重建錯誤指示,逐路重排名次,對每個接受集合從頭數錯。主程序用普通浮點指數歸一化和累計計數,兩條計算路徑可以暴露不同的程序錯誤。此次一千零八十個分數、三個身份序列、一千零八十三個前綴全部核對通過。腳本、輸入摘要、命令、退出碼和結果一起歸檔。這些是確定性的算術證據,標籤直接取自公開劃分,沒有新增語義標註。
研究問題與總結
作者推斷。 想在這裡超越最大概率,需要一個在獲勝概率相同時仍有機會提供新信息的信號。一個可檢驗的邊界來自多分類:設兩個三類預測都給第一類分配六成概率,其餘四成可以幾乎都給第二類,也可以由余下兩類平分。此時最大概率相同,熵卻隨剩餘概率的分配而變。這是說明證明依賴什麼條件的構造,並非本次測得的多分類收益。另一種容易改變名單的情形是低精度量化把許多不同值壓成同分,屆時應單列並列規模和裁決規則。
本次實驗把兩個問題拆開了。誰先回答,在這個固定二分類頭上可以由一個絕對差完全決定;留下多少錯誤,則要回到有標籤的樣本逐個計數。前一個問題有代數證明和程序核驗,後一個問題在四分之三覆蓋率下只觀測到八次錯誤。下一步值得問的是,這麼少的事件容許對拒答收益作多精確的判斷。重複命名同一條排序提供不了新的觀測。
源碼與復現入口
固定版本已公開,可從本篇源碼目錄進入,按復現說明運行,或對照公式與官方代碼映射檢查實現。
從源碼目錄運行以下最小命令,使用歸檔的真實模型輸出生成排名並獨立復算。
python run.py && python audit.py
結果文件 ranking.json 包含逐行分數、三份完整身份列表和逐個前綴的錯誤數。希望從句子重新得到分數的讀者可依照 README 準備固定資源,再執行八條試跑和完整審計池重放。源碼地圖給出了官方分類頭的固定行號、許可證與本地入口,運行日誌保留了每批的輸入與輸出形狀。這樣可以分別檢查誤差出現在分類頭,還是發生在讀出分數之後。
參考資料
檢索日期為 2026-11-08。
- Geifman 與 El-Yaniv,Selective Classification for Deep Neural Networks,NeurIPS 2017
- Hugging Face,DistilBERT SST-2 固定檢查點及詞表
- Stanford NLP,SST-2 固定驗證劃分
- Transformers 4.49.0,DistilBERT 官方分類頭固定源碼
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。