本篇实际完成:固定公开DistilBERT检查点,对SST-2的256条开发样本重新推理,保存逐条分数并独立复算。没有训练、没有拟合校准参数,也不把分类概率解释成开放问答的事实可靠性。
一、为什么答对了多少,还不是完整答案
看到一个模型准确率超过九成,我们很容易觉得它已经足够可靠。但研究中还有另一个问题:模型自己给出的把握程度,和实际表现相符吗?
如果一个模型对大量答案都接近百分之百确信,而实际仍然经常出错,那么它的分类能力和概率表达就是两件需要分别检查的事。前者回答“选对了没有”,后者关心“分数能否被当成可信的概率”。一个漂亮的准确率,不能自动证明第二点。
这不是先给模型贴上“不可信”的标签。本篇先建立一套可以被别人复算的观测:固定模型、固定输入、保留原始分数,再比较置信度和正确性。等基线站稳,后续才讨论校准、拒答和统计保证。否则,连问题出在哪一层都没有确定,直接尝试新方法,很容易把评分方式的变化误认为能力进步。
今天的结果有一个值得追问的反差:模型答对了233条,准确率为91.02%;同一批样本的平均置信度却是98.17%。这两项都是本次真实运行的结果,不是模型卡上的数字,也不是从别人的论文表格摘来的结论。
二、研究对象要小,问题边界要清楚
我们选择Hugging Face发布的DistilBERT SST-2情感分类检查点。输入是一段英文影评文本,输出是负向和正向两个类别的分数。它属于经过情感任务微调的预训练编码器,不是聊天模型;模型卡明确描述了任务与语言范围。模型卡
选择它不是为了追逐最新排行榜,而是为了把研究变量控制住。标签空间只有两个,官方标签可直接核对,模型可以在本机运行。我们先研究一个能审计清楚的概率问题,再考虑复杂的生成场景。
这也划出了结论边界:英文影评分类上的过度自信,不能直接推出中文科研问答同样失准,更不能据此估算大语言模型的幻觉率。开放生成的答案空间、正确性定义和评分方法都不同。后面比较生成式模型时,必须重新说明分数代表什么,而不能只因为两个数都落在零到一之间,就把它们放进同一张排行榜。
数据来自Stanford NLP发布的SST-2验证划分,共872条。它的研究背景可以追溯到情感树库,但本篇使用的是现成二分类任务,不复现原论文的递归模型。数据入口;原始论文
还有一项必须提前披露:这个数据集在前面的博客中已经出现,检查点作者也报告过验证集表现。因此,本篇是复用公开开发数据的探索性实验,不是“从未见过的测试集”,更没有证明训练数据零污染。重新打乱数据的编号,并不会抹掉这些历史。
三、置信度从哪里来
一次批量推理得到形状为的logits,是批量样本数,两个分量对应负向与正向。logit是未经归一化的模型分数。我们用softmax转换成两项概率,再取较大的一项作为预测置信度:
这里,是第条样本对类别的分数,是归一化概率,是预测类别,是最大类别概率。实际计算使用稳定的log-softmax,避免先指数化造成数值问题。
注意,softmax保证的是两项非负且相加为一,并没有额外证明“这些概率一定符合真实正确率”。模型输出了0.99,不等于研究者已经验证了百分之九十九的可靠性。
Guo等人的经典校准论文将问题表述为:具有相同置信度的一组预测,其正确比例是否与该置信度相符。本文借用这个测量框架,而不声称重现论文的全部模型、数据集或温度缩放结果。论文第2节
四、先冻结协议,再看结果
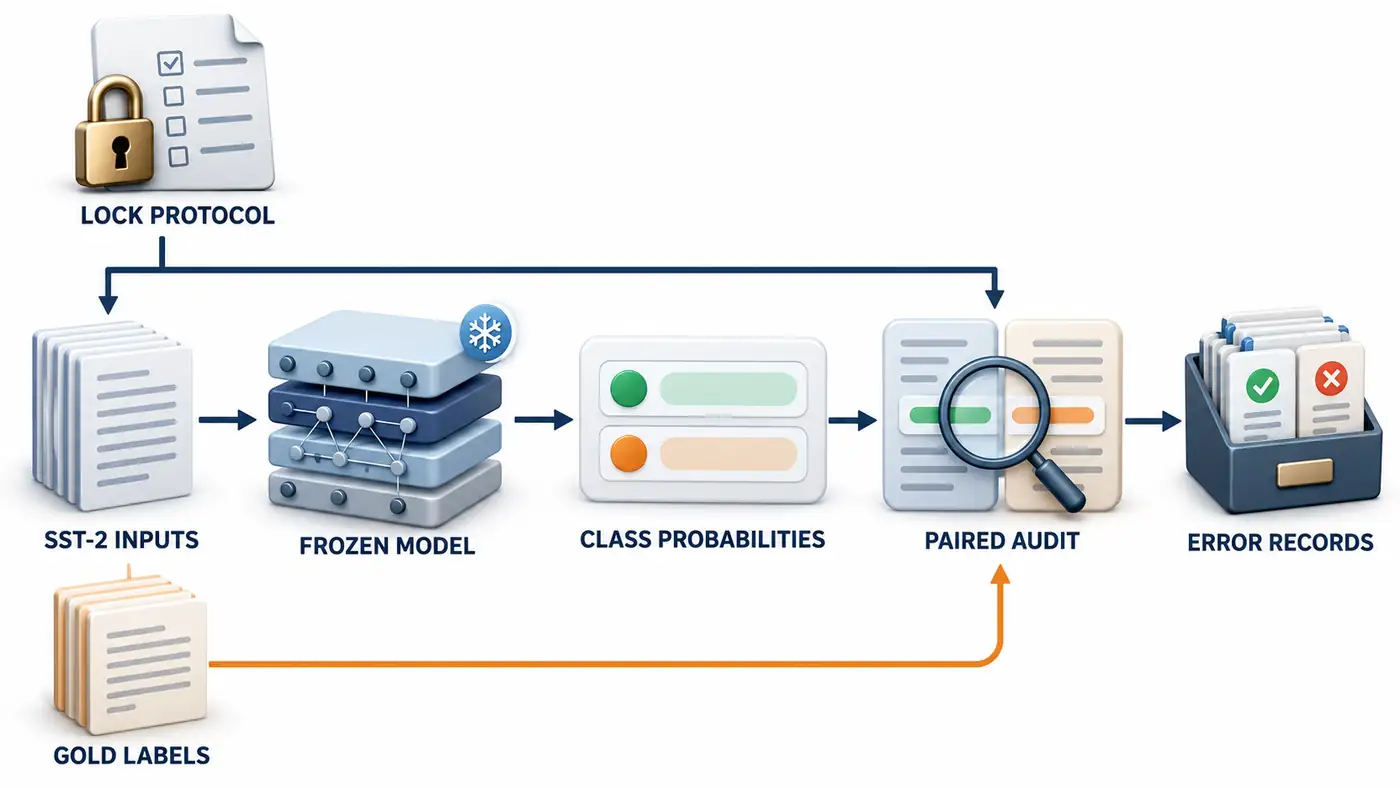
上图是流程示意,不包含实验测量值。尤其要注意底部的标签路径:标准答案只进入评测环节,不作为模型推理输入。图中的概率容器也只是概念图,不代表任何实际比例。
本轮按样本原始编号构造哈希排序,规则为对字符串“cycle7:编号”计算SHA-256并升序排列。前256条用于本篇探索,接下来256条留作校准池,其余360条作协议审计池。三个集合的编号在首次推理之前保存;今天没有生成后两个池的模型预测。
这样做首先为了可追溯,而不是让随机划分带来神奇的独立性。它能防止看到结果后挑样本,却不能解决数据历史复用、模型作者可能用过验证集、同源文本相关性等问题。后续域内实验仍会注明探索性质。
本篇冻结的条件包括:模型与分词器固定revision,最大长度512,批量16,CPU单精度,四个计算线程,固定随机种子112,关闭训练态dropout,使用eager注意力。没有尝试不同提示词,没有训练新权重,也没有按结果调阈值。
正式运行前先做8条试跑,只检查链路和资源。试跑来自同一开发池,因此不另算一次独立测试。之后完整处理预先选好的256条,不因为试跑看起来好或坏而更换样本。
五、真实结果:分数很高,错误仍然存在
| 指标 | 本次结果 | 应如何理解 |
|---|---|---|
| 正确数与准确率 | 233/256,91.02% | 这256条上的分类表现 |
| 平均最大类别概率 | 98.17% | 模型对自己所选类别的平均把握 |
| 平均置信度减准确率 | 7.16个百分点 | 整体方向性的差距,不是完整校准度量 |
| 十等宽分箱ECE | 0.083705 | 本文固定分箱口径下的描述量 |
| 平均负对数似然NLL | 0.385259 | 使用自然对数计算的概率损失 |
| 双类别求和Brier分数 | 0.169913 | 两个类别的平方误差之和再取平均 |
最容易误读的是“九成以上”这个区间。固定阈值0.9筛出242条,其中223条正确,正确率是92.15%。乍看之下,它似乎已经超过九成,为什么还说有过度自信的现象?
因为这组样本的平均置信度不是90%,而是99.45%。判断概率是否匹配,应当比较这组实际报出的概率和实际正确性,而不是只拿分箱左端点作参照。这242条里仍然有19条错误,不能因为统一贴上“高置信”标签就忽略它们。
低置信区间则提醒我们不要急着讲故事。0.5到0.6之间只有1条,0.6到0.7之间只有3条,而且都答对了。这不是证明“模型越没把握越正确”,而是样本太少,不足以支持这种规律。每箱人数必须和正确率一起报告,空箱也不能被画成零错误率。
全部样本都没有触发长度截断。正式批次循环约耗时1.13秒;依赖导入后的实验流程约1.38秒,包含资源校验和模型加载;含Python启动和导入的进程总时长约3.29秒。峰值常驻内存约831MiB。下载与首次环境准备不包含在这些计时中,也没有测量GPU显存。这些是本机、该批量与该输入长度下的测量,不是通用性能承诺。
六、为什么不能只报一个ECE
ECE把样本按置信度分箱,再按每箱人数加权计算平均置信度与正确率之差的绝对值:
是箱数,是落入第个箱的样本集合,是总样本数。本文预先固定十个等宽箱,空箱贡献为零,但其正确率保留为空值。完整分箱表随结果文件一起保存,读者不必相信一个孤立的汇总数字。
平均置信度减准确率允许不同区间的高估与低估互相抵消;ECE先在箱内取绝对差,因此二者不必相等。本次7.16个百分点和8.37个百分点的差异不矛盾。下一篇会固定预测,只改变分箱方案,检查测量口径有多敏感,而不是重新训练模型寻找漂亮结果。
我们还保留NLL与Brier。前者关注给真实类别分配的概率,对非常确信却答错的情况惩罚较重;后者用平方误差检查完整概率向量。本篇Brier是两个类别求和的版本,不能与只计算正类概率误差的版本直接混比。这些量补充了不同视角,但都不能凭单次开发实验获得总体可靠性保证。
七、从官方代码读到独立核验
官方分类器不是凭空产生一个“可信度头”。沿着固定版本的实现,先看编码器输出,再看首位置隐藏状态、线性层、ReLU、dropout以及最终两类别分类层。随后,本地脚本才把logits转换成用于审计的概率。官方实现
本次将实际加载的模型源码与官方固定提交逐字节比较,模型权重也核对了官方文件哈希。保存的每条结果包含原始样本编号、文本哈希、标签、两个logit、概率、预测和token长度。原始句子不随源码再分发,因为数据卡没有提供明确的许可标记;读者从官方入口获取并验证数据身份。
独立审计脚本不导入主程序的指标函数,而是用标准库重新从logits计算概率和所有汇总值。另一项输入核验重新读取数据,检查标签、文本哈希、样本顺序与三个集合不重叠。我们还故意损坏编号、标签、预测、正确性、置信度和损失,确认六种错误都会被拒绝。自动复算不是人工语义审核,二者不会混称。
过程中确实遇到失败:本机原网络代理一度不可用,云盘上的旧依赖目录也卡在导入阶段。两次导入试跑在预测前被终止,记录保留。最终使用同版本的独立本地环境完成实验,没有换模型、换样本或删掉失败结果来冒充一次顺利运行。
八、源码与复现入口
配套源码已经公开,并按固定提交逐文件核验。读者可从完整源码目录进入,先读运行说明,再对照公式与官方实现地图。32个公开文件与本地代码包一致;下载副本的独立复算和8条真实模型试跑也已通过。
取得源码目录并安装依赖后,先下载固定资源,再执行真实模型试跑与正式实验:
python execute.py prepare --cache .cache112
python execute.py smoke --cache .cache112
python execute.py formal --cache .cache112
python execute.py audit
python verify_inputs.py --cache .cache112
入口将生成逐条预测、汇总指标、输入核验和执行日志。复用缓存时仍会核对哈希,不依赖作者机器上的隐含路径。只想检查算术的读者可以直接审计随包保存的结果;这与重新运行神经网络是两种不同层级的复现,不能混为一谈。
九、下一步研究什么
当前证据支持一个有限判断:在这256条开发样本和固定协议下,模型的平均最大类别概率明显高于经验准确率。它没有回答温度缩放一定有用、拒答一定能提高可靠性,或换领域后会发生什么。
后续最值得检验的不是“怎样证明模型不可靠”,而是几种竞争解释:差距是否对分箱口径敏感?简单概率变换能否改善损失?这种改善是否同时改变错误排序?迁移之后,原来拟合的参数还能否沿用?
近期关于推理配置变化与保形预测的研究,也把配置本身视作需要检查的实验变量。本次仅核对了该工作的摘要与版本,尚未复现其结果,因此只把它作为后续阅读线索。2026年研究入口
第一篇最重要的产物,不是一个“已解决可信AI”的结论,而是一份之后可以公平修改、独立复算、保留负结果的基线。有了它,校准和拒答才成为可以做实验的问题,而不只是听起来合理的建议。
参考资料
检索与访问日期:2026-10-28。方法论文、模型来源、代码来源和本次实验结果分别标明;下列论文数字未被挪作本次测量结果。
- Guo, C., Pleiss, G., Sun, Y., Weinberger, K. Q. 2017. On Calibration of Modern Neural Networks. ICML,本文核对定义与公式,不声称完成整篇复现。
- Geoff Pleiss. 作者校准代码,固定提交。已读ECE实现;本文独立实现采用明确不同的分箱端点约定,本次样本无精确边界命中。
- Hugging Face. DistilBERT SST-2固定模型版本。
- Stanford NLP. SST-2数据卡;Socher等,2013,原始情感树库论文。
- Hugging Face. Transformers分类器固定源码。
- Doula, A., Mühlhäuser, M. 2026. Auditing Conformal Prediction for Language Models Under Inference-Time Model Shift。arXiv v1,2026-10-20;本次仅阅读摘要,不依据摘要复述实验细节。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。