可信预测实验室:从模型置信度到可检验的拒答
同一个样本,两个看似矛盾的结果
在这次审计中,编号 382 的短评排在第 270 位。模型原先给自己的答案打了 0.99695 分,做过温度缩放后只打了 0.91150 分。如果只接受置信度达到 0.99 的回答,这条短评会从接受变成拒答。如果要求模型恰好回答四分之三的问题,它两次都会入选,而且两次都是最后一个入选。数据、答案和标签都相同,究竟该说拒答策略变了多少?
这个区别值得单独做一次实验。上一篇在校准池锁定阈值,再去审计池看它实际接住多少错误。这一篇把阈值放到一边,先给两组完全相同的回答名额,逐个检查名额交给了谁。研究问题很窄:对于同一个二分类器,一个从其他样本上学到的全局温度,能否把更可能答错的句子往队尾多推几位?如果真能,读者应该可以指出第一个交换了位置的样本。
两种读数测的是什么
置信度是预测类别得到的概率。校准考察概率的数值是否与长期频率相称。假如一批难度不同的题都得到九成把握,可以观察这批题实际答对的比例。单独拆出一道题,只能看到一次对或错。换一个问题,给一叠答卷排队,只取队首的一部分,希望拿到的错题越少越好。这时把每个分数都写得更保守,未必改变队伍的先后。
Guo、Pleiss、Sun 和 Weinberger 在现代神经网络的校准研究中报告,训练完成后再拟合单个温度,可以改善他们测试的多种网络的概率估计。本篇借用其变换形式,在已存档的情感分类器上测两个具体读数。负对数似然取每条样本真实类别概率的负对数再平均,模型越自信地答错,代价越大。另一个读数是期望校准误差的分箱估计:在概率轴上均分十箱,每箱比较平均置信度和实际正确率,取差的绝对值后按箱人数加权。空箱贡献为零。两者衡量的性质不同,本文按预设口径一起报告。
选择性分类则给模型配一条接受规则。按照 Geifman 和 El-Yaniv 的定义,覆盖率是在全部待答样本中接受的比例,选择性风险是在接受样本上计算的损失。本文用错一条记一分的损失,它就是条件错误率。只接一道题时,错一道对应百分之百的风险;全都拒绝时分母为零。画图时把后一种情况留空,才不会把完全不作答画成完美成绩。
为什么二分类可以预言整条曲线
分类头对每个句子输出两个尚未归一化的实数,称为 logits。用两个数的差表示证据偏向哪一侧,再用温度调整两侧的相对强度。取概率较大的类别,它的置信度可以写成
这里 是样本编号, 和 分别属于负面和正面类, 是不带方向的分差, 是所有样本共用的正温度。把两项都除以正数不会交换它们的大小,预测标签保持。更重要的是,如果甲的分差大于乙,把两者除以同一个正数后,甲的分差仍然更大。代入上式,甲的置信度也仍然更大。两条分差刚好相等时,两种温度下都是平手;本实验约定平手按样本编号升序。
从这个关系到拒答,只差一步。对任意给定的名额数,把原始队列和新队列各截取同样长的前缀。两段包含相同的身份,每个身份的预测类别也没有变,逐条对照官方标签,错误总数就相同。即使某个前缀恰好没有错误,这个推理也成立。它预言的是所有名额数上的一致性,检查某个好看的点或比较两条曲线的平均值,都不足以代替这一检验。
数据登记与最小实验
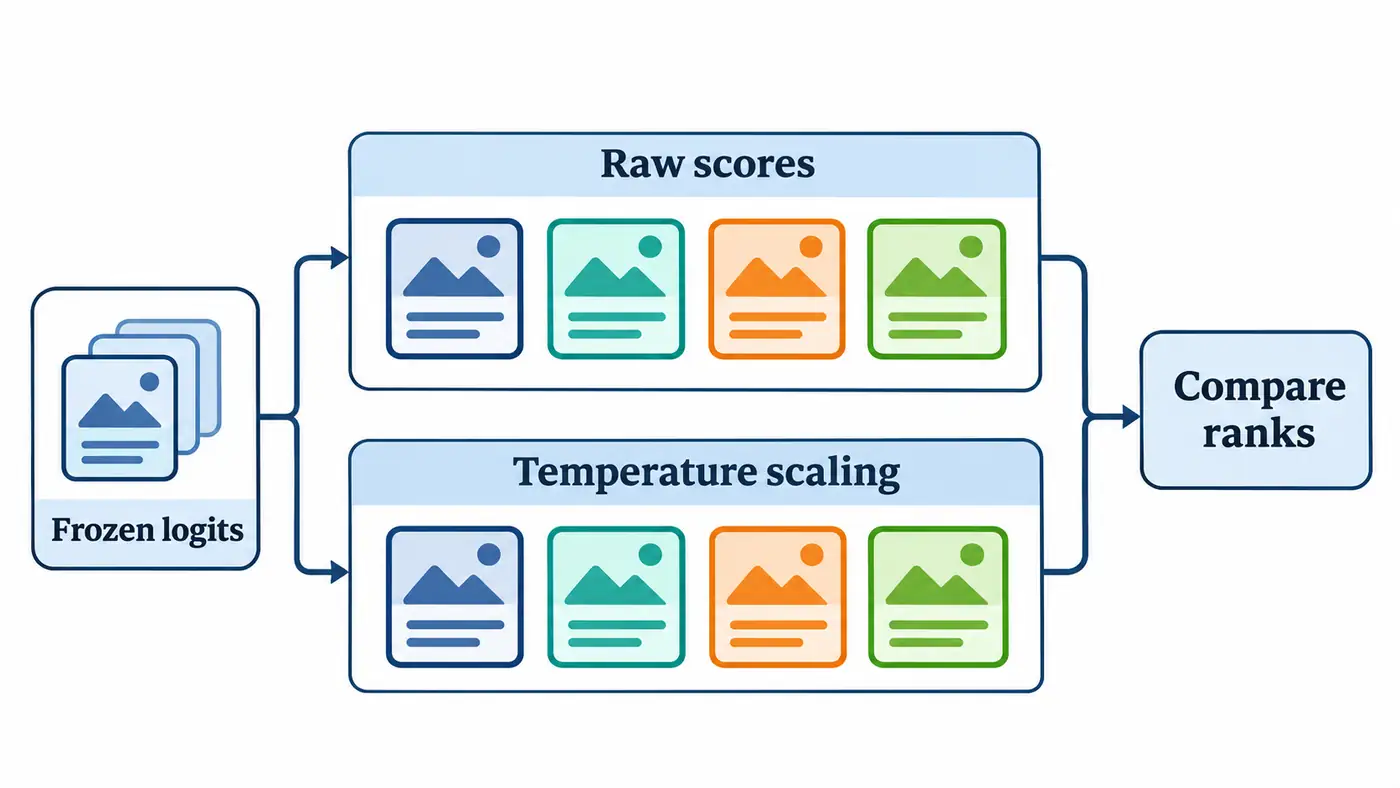
输入是固定版本的 DistilBERT 英文 SST-2 情感分类检查点,类别零为负面、一为正面。系列开始时已按样本身份的哈希顺序登记验证集,前二百五十六条用于探索,随后二百五十六条用于校准,剩余三百六十条用于协议审计。整个验证集在历史系列中已有接触,审计池也已在前文观察过。这些数据适合核查明确的数学预言,不能承担独立确认一个新发现的角色。此次没有访问 IMDb,也没有引入需要真人判断的新标签。
预先锁定两组温度:原始组取一,缩放组直接读取先前用校准池最小化平均负对数似然得到的 2.481924。审计标签只在判断答对与否和计算损失时使用。程序另行核对两池身份互斥、温度文件内的校准预测哈希,并从校准样本重算逆温度处的目标函数梯度。这样可以区分“读到了同一个参数文件”和“这个文件里的数值与这批校准数据相符”。全篇没有搜索一个能让审计曲线最好看的温度。
真实模型先在中央处理器重放八句,检查标签映射、张量形状、输出有限性和资源占用,再按每批十六句重放全部审计样本。固定四线程、单精度、评估模式及五百一十二个词元的截断上限,使用同一份词表和模型权重。每批分类头输出的列数必须是二;末批只有八行,按实际行数计数。正式批次前向及逐条整理共耗时约 1.29 秒,进程峰值内存约 899 MiB。这里的计时从模型装载后开始,不能当作首次下载和启动的总耗时。
实测结果:先对齐名额,再看阈值
| 审计指标 | 原始分数 | 温度缩放后 |
|---|---|---|
| 平均负对数似然 | 0.38411 | 0.23714 |
| 十箱校准误差 | 0.07327 | 0.01990 |
| 固定接受 270 条时的错误数 | 8 | 8 |
| 所有非空前缀的平均风险 | 0.02124 | 0.02124 |
| 固定 0.99 门槛时的接受数 | 304 | 0 |
这三百六十个位置没有一处交换,两组都没有同分。逐个核对所有非空前缀,累计错误数在每一处都一致。全收时均错三十条,四分之三覆盖时均错八条。后一个结果的分母是二百七十,对应约百分之二点九六。它还告诉我们,被留在队尾的九十条里有二十二个错误。校准后的队伍保留了这项筛分能力,也保留了排在前面的八个错误。
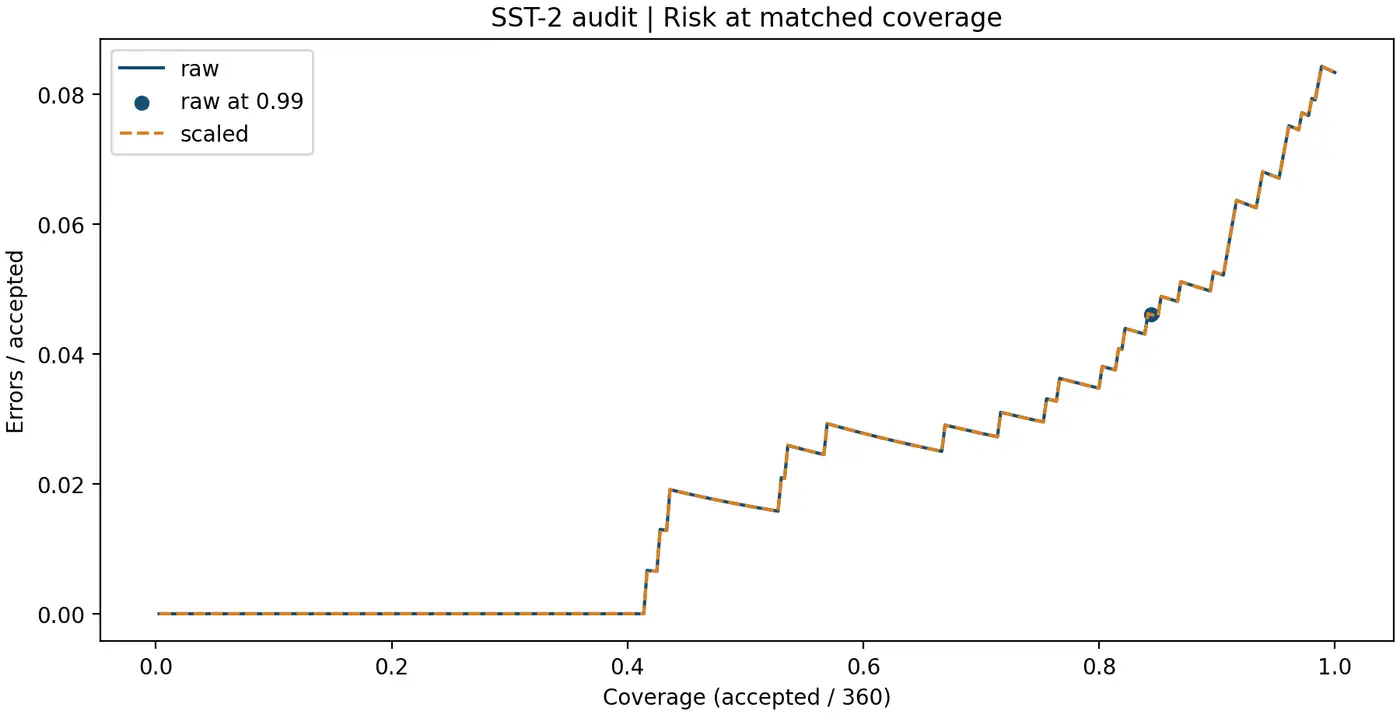
图中横轴是回答比例,纵轴是已回答部分的错题比例。蓝色实线和橙色虚线叠在同一条轨迹上。原始组达到 0.99 的位置用点标出;缩放组最靠前的样本只有 0.97551,没人达到这条线,因此没有可画的风险点。原始门槛下十四个错误除以三百零四约为百分之四点六一。把它与缩放组的零个接受错误直接比较,会悄悄丢掉分母,也会得到一个无法兑现的改进。
在本次实际验证中,较低的负对数似然说明真实类别获得的对数概率平均提高;较小的十箱误差说明这次分箱下频率与置信度更接近。这两句都只谈全体样本的汇总。回到开头那条预测正确的短评,给正确答案降分会使它自己的负对数似然上升。整体改善可以伴随个体变差,正如平均风险相同也不足以单独证明每个样本的名次一样。逐样本记录让两种推断都可以直接检查。
官方代码阅读路线与失败排查
先读官方分类头的前向函数,看首词元表示怎样经过线性层、激活、丢弃层和最后的分类层。再读校准论文作者实现的温度缩放函数,它把温度扩展到与输出相容的形状,再逐元素相除。最后才看本地评测脚本:从每行减去最大值以稳定指数运算,归一化得到两类概率,按未舍入的最大概率排序。这个先后顺序可以防止把最大原始输出误当成置信度。给一句话的两个原始输出同时加上相同常数,概率不变,最大原始输出却会变。
如果复算得到名次变化,先找两队列第一次分叉的身份,把两行原始差值和保存的分数打印到足够多的小数位。只保留两位小数会使许多接近一的概率看上去相等,随后按身份破平手就可能改变次序。进一步检查是否在缩放后先转成低精度,或让两组使用了不同的分词上限。前者会制造数值平手,后者会改变原始输入证据。两者都可以成为另一个有趣实验,却不能用来推翻这里共享实数变换的推导。
本次八句试跑与归档输出的最大绝对差约为 ,正式批次与归档逐值相同。小批次的数值偏差记录在环境文件中,验收时还逐条检查预测类别、身份和文本摘要。独立复算改用高精度十进制运算,从绝对分差直接求置信度,核查七百二十个分数与两组各三百六十一个前缀记录。原始句子没有随包分发,下载器会对数据文件和权重逐件检查摘要;核验失败时应先查版本,不能换一份同名数据继续算。
研究问题与总结
哪些修改值得在下一次实验里认真辨别?首先是每个样本使用不同温度的情形。两个分差原本只差一点,如果较大分差恰好被更大的温度相除,它有可能落到后面。其次是三个及以上类别的任务。此时最大类的概率还取决于所有竞争类的相对位置,单靠第一名和第二名的距离已无法还原分母。这是推导适用边界提出的假设,本文没有运行这些条件,也没有根据审计池选出替代方案。
对希望复用旧阈值的研究者,还有一个可以用纸笔检验的问题。把旧概率门槛换算为所需的最小原始分差,再用新温度把该分差换算回概率,就能在理想数值精度下保留相同的接受集合。这种换算只保持决定的一致性,新的样本分布仍可能改变所接问题的风险。读实验报告时,可以先找横轴到底固定了什么,再问接受集合是否变化,最后才解释概率质量的变化。本次的结论落在同一个二分类器、共享正温度和等覆盖比较这三个条件上。
源码与复现入口
固定版本已公开,可从本篇源码目录进入,按复现说明运行,或对照公式与官方代码映射检查实现。
在本篇源码目录执行 python run.py,可从固定预测重新生成逐样本双列分数、全部前缀和指标汇总;接着执行 python audit.py 走独立复算路径。要从权重开始重放,按说明先准备官方资源,再执行八句试跑和三百六十句正式运行。两条路径在本次均已执行,下载阶段复用了逐件校验过的缓存。
参考资料
检索与版本核对日期为 2026-11-11。
- Guo 等,On Calibration of Modern Neural Networks,ICML 2017
- DistilBERT SST-2 官方模型卡与固定版本
- Stanford NLP,SST-2 数据集固定版本
- Hugging Face Transformers v4.49.0,DistilBERT 分类头
- Geifman 与 El-Yaniv,Selective Classification for Deep Neural Networks,NeurIPS 2017
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。