一个温度,换一批读者来信
假设你有一把量表,在电影短评上把模型的“几乎确定”调成了“比较有把握”。今天收到的却是整段影评:开头称赞表演,中间批评剪辑,末尾才给出总评。这时最容易犯的实验错误,是先用几篇长评把量表再调一遍,然后宣布它可以迁移。本文问一个可以用数字否定的问题:一丝不动地带走短句上学到的温度,模型给长影评真实标签分配的概率,平均而言还会变好吗?
答案有两层。在本次登记的一千条 IMDb 探索影评上,固定温度让平均负对数似然从 0.4410 降到 0.2863,方向与短句审计池一致;但长评上的损失仍高于短句,固定门槛接收的比例也变了。换句话说,可以带走的是这批样本上相对于原始分数的改善。不能一起带走的,是“换了语料,每个置信度仍对应原来的正确率”这句更强的承诺。下面把这两个判断拆开检验。
什么被冻结,什么发生了变化
上一篇在同一批短句上更换集合构造方法,观察哪些标签会被纳入。本篇把模型固定为在 SST-2 上微调的英文 DistilBERT 二分类器,换评测语料,不更换模型、分词器、推理精度或截断上限。标签仍为负面与正面;沿用数据作者提供的标签,没有根据模型回答再挑一组“看起来对”的影评。两套语料都谈电影,这让任务相近,却不意味着短句的标签形成过程与整篇影评的评分机制相同。
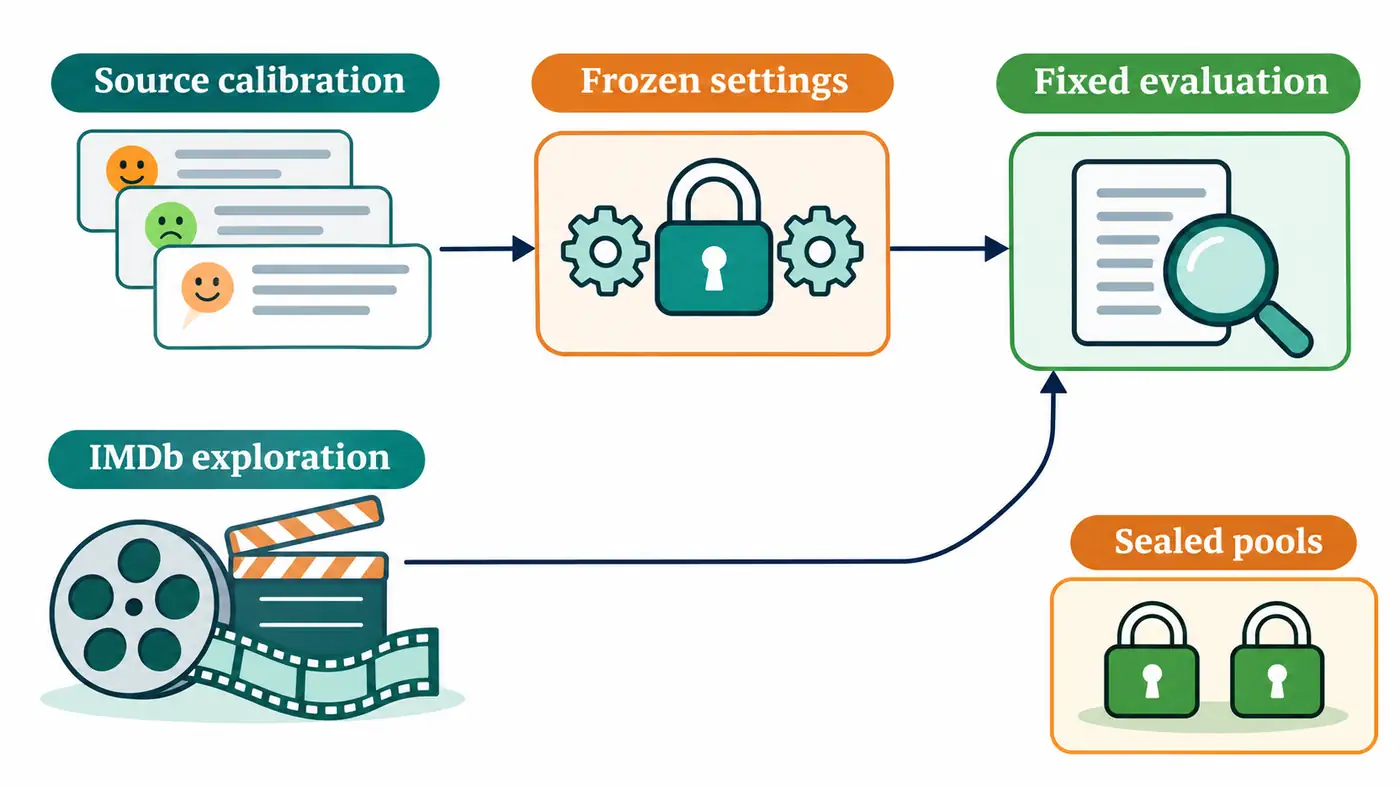
源域指用来学这个温度的语料环境。历史 SST-2 验证划分中,用隔离的二百五十六条校准样本得到温度 2.481924;比较用的是另外三百六十条协议审计样本。它们不是第一次出现在本系列,不能包装成未见测试。此次直接读冻结的温度和审计输出,不重新训练,也不把以往文章的模型前向运行计作今日开销。目标域指要迁入的环境,本次只新增 IMDb 的模型前向计算。
IMDb 原论文介绍的是影评情感分类数据。官方测试划分有二万五千条,不代表这里需要把它们都送进模型。为了防止同一部电影的多篇评价落进不同研究阶段,我们先取归档内的电影网址索引,将其与文件序号对齐;同一影片至多贡献一个样本。另把正文的换行标记、大小写、空白和字符规范化后求摘要,重复文本也至多保留一份。规范化只用于查重,真正送给模型的是原始文本。它不能识别所有改写,更不能判断两篇评论是否表达了同一个意思。
实现时先按文件身份的加盐哈希排序,依次保留影片和文本均未被占用的候选。依序取三段,每段一千个身份,分别作开发探索、目标域校准和最终确认。在任何一次模型预测之前写出同一份三池清单。入选依据没有用模型分数,也没有按目标标签配平。这里的估计对象是这种抽样规则下的影评;按影片限额会改变热门影片的权重,不能用这组分数冒充官方全量成绩。确认池只登记身份,不预测、不看输出、不挑案例。
怎样量出“还有效”
模型给每条输入输出两个未经归一化的分数,叫作 logits。温度缩放指把两个分数都除以同一个正数,再归一化为两类概率。设一批分数矩阵的形状为 ,其中 是批大小。对一个样本,第 类的概率为:
这里的 是该类原始分数, 是固定温度。温度大于一会缩小分数差,让原本接近零或一的概率向中间移动。两个分数的大小次序不变,最高分标签也就不变。这既给出一个实现检查,也解释了为什么改善概率质量不需要多答对一道题。比如同一次错误预测,给正确标签百分之一和给它百分之十,在准确率里都只算一个错;在需要相信这个概率的任务里,二者代价不同。
预先指定的主要指标是负对数似然,简称 NLL。它是模型给真实标签的概率取负自然对数,再在样本间平均。对每个语料分别计算:
其中 是该池样本数, 是第 条的原标签, 是相同样本上两种温度的损失差,负值表示改善。先在各域内部作差,再比较方向;不要把两组不同影评按行号配成对。辅助指标有两类概率的平方误差之和,即类别求和的 Brier 分数,以及十个等宽置信度区间的校准误差 ECE。后者按箱内样本数加权,比较箱内平均置信度和正确率,空箱权重为零。固定分箱后仍可能有箱内抵消,不能把一个小数点后的变化当成校准证明。
最小实验与官方代码阅读路线
先看官方分类头如何从最后一层的首个位置取表示,经线性层、激活和分类层得到两个分数。这里并未让模型生成“正面”或“负面”两个词,更没有对开放回答的真实性计分。然后看配套入口里三段相接的代码:登记函数只生成身份;前向分支只允许探索清单内的身份;评分函数读取固定分数和标签,才计算概率、损失和接收数量。这个顺序的好处是容易排查:如果只改温度就改了预测类别,先检查列与标签的对应,不要急着解释领域偏移。
模型切到评估模式,关闭梯度,使用四线程 CPU、单精度、右侧截断。每批最多十六条,补齐到当批最长输入,上限为含特殊符号的五百一十二个分词单元。先用探索池开头八条做真实试跑,检查输出两列、数值有限,再跑整个一千条。八条试跑包含在正式清单中,不能合并说成一千零八个不同样本。正式前向循环含分词及批处理用时 58.99 秒;从参数读取后到保存结果约 65.11 秒,进程峰值常驻内存约 2.14 GB。此处给出量级是为了让读者估预算,并非跨硬件速度比较。
结果:改善迁移了,门槛的含义变了
| 语料与温度 | 正确数 | NLL | Brier | ECE | 九成门槛:错误数/接收数 |
|---|---|---|---|---|---|
| SST-2 原始 | 330/360 | 0.3841 | 0.1540 | 0.0733 | 23/343 |
| SST-2 固定温度 | 330/360 | 0.2371 | 0.1352 | 0.0199 | 10/279 |
| IMDb 原始 | 890/1000 | 0.4410 | 0.1955 | 0.0891 | 89/945 |
| IMDb 固定温度 | 890/1000 | 0.2863 | 0.1693 | 0.0285 | 23/634 |
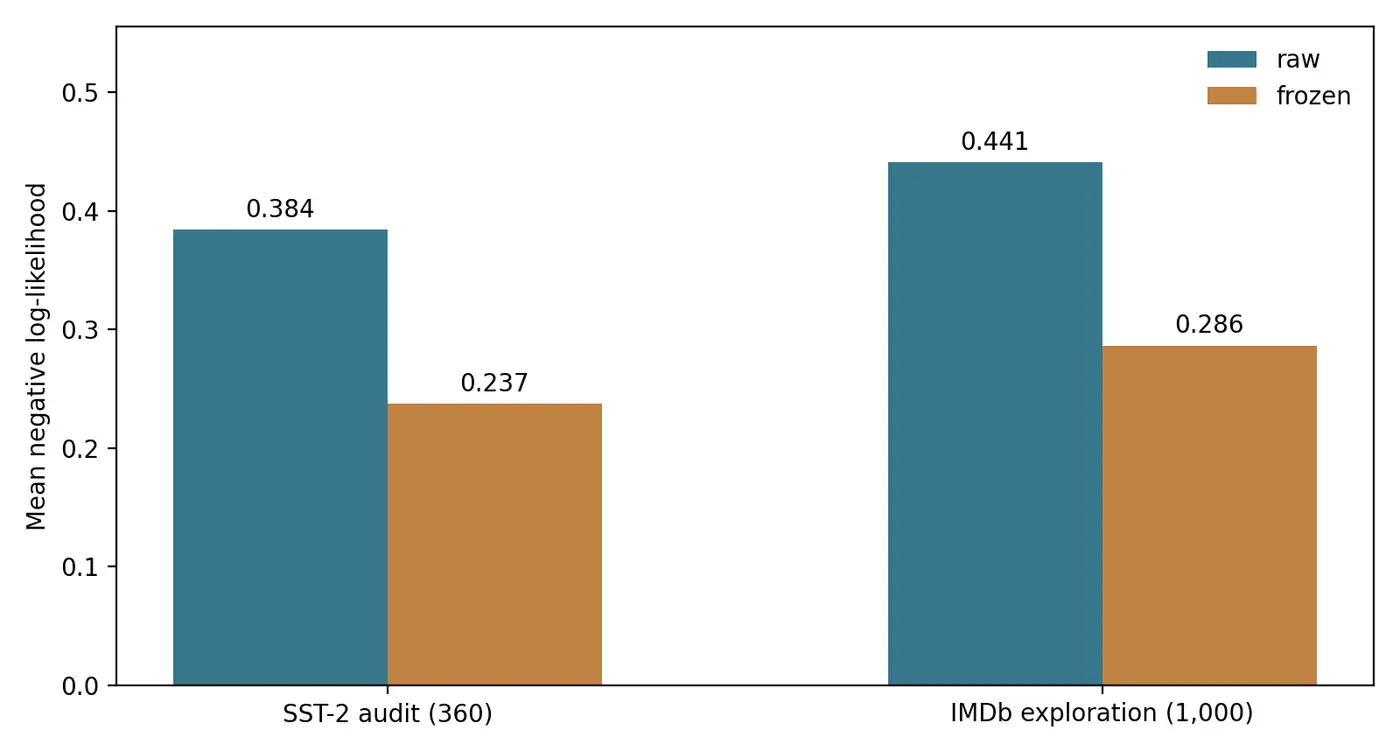
图中每对柱都来自同一组真实预测,输入是保存的两列分数,不是论文曲线。短句的损失差约为负 0.1470,长评约为负 0.1547。三个概率指标的改善方向在两个域里一致,两个域的准确率却分别停在原处。这说明固定温度仍修正了原模型分配概率时的一部分过度自信。它不说明此温度对 IMDb 最优,更没有证明两个域的改善幅度相等;我们没有做等效性检验。
接着看最后一列,它只回答“模型对所选标签至少有九成把握时,还错了多少”。长评中原先接收九百四十五条,缩放后只接收六百三十四条;移出的三百一十一条里有六十六个错误,也有二百四十五个正确答案。这比单报“错误从八十九降到二十三”有用,因为它列出了回避错误的代价。校准后,短句的接收率是百分之七十七点五,长评为百分之六十三点四;接收集合上的错误率却分别约为百分之三点六和百分之三点六。近似相同的条件错误率掩盖了接收规模的差异,也不能变成新语料上的风险承诺。
还可以直接读长评的最高置信度箱。缩放前其中九百四十五条,平均置信度约百分之九十九点二,正确率约百分之九十点六;缩放后六百三十四条的平均置信度约百分之九十四点五,正确率约百分之九十六点四。后一个箱里模型甚至略偏保守。两次进箱的样本并不相同,这不能解释成“同一群影评从偏高变成偏低”。读可靠性图时,箱子的横坐标看似没动,里面的人却可能已经换了。
失败排查与可检验的下一步
第一次试跑没有产生任何 logits:临时环境里仍能找到解释器,但导入框架失败。我们保留了失败退出码,在独立环境按锁定版本重装后,重用了已经写好的身份清单。另一次障碍发生在下载阶段:作者站点未能建立连接,另一个整理版没有所需影片索引。最后使用完整原包的固定镜像,逐字节摘要与官方数据工具记录相同。若缺少影片索引,只检查两个池里有没有相同文件名,并不能证明没有同一部影片;这也是本实验不能直接换成任意两列表格的原因。
对于研究解释,最有诱惑力的说法是把损失差异全归给长文本。记录只能支持更窄的判断:短句与长评实际保留的分词单元中位数分别为二十三和二百二十九,长评有一百一十二条到达长度上限,短句没有。达到上限不等于一定丢掉了结尾;单看保留长度,没法区分“刚好放得下”和“确实被截掉”。同样,官方高低评分形成的标签与短句极性标签虽可映射到两列,其难度不一定相同。这里没有把样本长度随机分配,也没有请真人重新判断哪一句决定了感情方向。
一个能被推翻的后续假设是:固定影评身份后,缩短可读前缀,会改变一部分样本的分数差,且可能在最高分标签翻转之前就改变概率损失。验证时要用同一条影评做配对,先登记长度预算,再记录实际少读的分词数、答案是否翻转及损失变化。若概率变化只出现在少数临界样本,也要照实保留。现在的跨库比较提出了这个问题,但还没有执行这个干预。公开文本也可能在预训练中出现;这里的“封存”指本项目的实验纪律,不是对训练历史的零污染认证。
源码与复现入口
打开本篇固定版本源码,从复现说明进入实验,或在源码地图逐项核对论文公式、官方分类头和本地实现。
安装锁定依赖后,在源码目录执行:
python run.py analyze && python audit.py
这条最小命令从随包的真实分数重建结果表,并独立检查身份、两列概率及全部计数。完整下载、登记、八条试跑与正式推理命令见复现说明。本次确实执行了探索池正式推理,未在 IMDb 拟合温度;源域只复用了已记录的预测。复算脚本采用两列指数归一化,与主脚本的二元分数差写法不同,核对四十个箱和四组指标。它能发现下标错误或分母混用,不能代替读者判断研究假设是否合理。
总结
短句上学来的温度,在这批长评上仍能缓和错误预测受到的概率惩罚。更有用的证据是同时留下三样东西:一千条固定身份、每条的两个原始分数,以及门槛内外各有多少错误和正确答案。它们让下一步可以只改阅读长度,检验今天还解释不了的差异,同时把最终确认池留给真正的确认实验。
参考资料
检索日期:2026-11-17。
- Andrew L. Maas 等,2011,Learning Word Vectors for Sentiment Analysis,IMDb 语料来源;TFDS 数据说明提供官方划分规模。
- Chuan Guo 等,2017,On Calibration of Modern Neural Networks,温度缩放的定义和论文报告。本文数字来自本次复算。
- DistilBERT SST-2 模型固定版本;Transformers 官方分类头。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。