復現目標:校準集上更漂亮,能否帶到下一組樣本?
上一實驗說明,幾十條樣本可能把溫度推到搜索邊界。本篇再增加一個受控問題:如果允許校準函數彎曲、形成平臺,它是否比只有一個參數的溫度縮放更可靠?我們固定模型、原始預測、校準身份和審計身份,只更換後處理方法,同時保留一個預先登記的小樣本條件。
本次實際驗證給出的答案是否定的,但範圍有限:使用完整二百五十六條校準樣本時,保序迴歸在擬合數據上損失更低,在三百六十條審計樣本上卻沒有超過溫度縮放;它還給七個錯誤答案分配了確定性的錯誤概率。這是一次可復算的方法實驗,不是所有數據集上的方法排名,也不是開放生成可靠性的結論。
核心思想:一個旋鈕與一條可以彎曲的曲線
溫度縮放只改變兩個類別分數之間的距離。正溫度不會翻轉大小關係,因此類別預測保持不變。保序迴歸則尋找一個非遞減映射:原正類概率更大的樣本,校準後的正類概率不能更小;但相鄰樣本可以落到同一平臺。這裡的“保序”允許並列,不等於嚴格保存全部排序,也不保證原來的分類閾值保持有效。
論文報告方面,Guo、Pleiss、Sun 與 Weinberger 在二〇一七年的研究中發現,單參數溫度縮放在其多項實驗中有效。這是選擇簡單對照的理由,不是本實驗結果的替代證據。論文與會議記錄
官方文檔將保序迴歸定義為帶單調約束的最小二乘問題,並提醒校準樣本少時應注意過擬合。這裡我們直接調用固定版本的官方實現,而不是把教學近似當作該庫。保序迴歸文檔、概率校準文檔
公式與評測對象
對每個輸入,模型產生兩個原始分數,也就是 logits。記它們為 ,正類標籤為 ,分數差為 。溫度變換為:
這裡 是正面情感類別的概率, 是在校準子集上擬合的一個標量;模型批量輸出形狀是 ,後處理概率向量形狀是 。我們繼承有界逆溫度求解器,用校準集負對數似然確定參數,邊界與迭代規則均不依賴審計結果。
保序迴歸使用原始正類概率 作為橫座標,尋找映射 :
是本次擬合樣本數, 是該樣本的校準概率。函數約束方向顯式設為遞增,不讓程序根據相關性自動選擇。兩種方法優化目標不同,故這是常用方法整體比較,不能解釋成只增加參數數量的純因果實驗。
主要指標為雙類別求和 Brier 分數,即概率與標籤之間的平方距離:
是評測樣本數, 是某方法輸出的正類概率;因子二來自兩個類別的誤差相加。輔助指標為負對數似然,即 NLL。對真正的零真類概率,數學上的損失是無窮大。為了仍能比較有限表格,協議另外預設 ,只在計算展示用 NLL 時將真類概率限制到 。擬合、Brier、分類與邊界計數始終使用未截斷概率。
官方代碼閱讀路線
先讀固定提交中的 IsotonicRegression._build_y:排序、合併重複橫座標、進行帶權保序擬合,再刪去不影響預測的冗餘平臺點。隨後讀 _build_f 與 _transform:官方預測會在保留結點之間線性插值,超出校準橫座標範圍時,本實驗明確選擇端點截取。因此“保序函數是階梯”只是直觀示意,不能據此自行實現為處處階梯常數。固定源碼
本次核驗了版本一·六·一對應的真實提交,並逐字節確認安裝的模塊與官方文件一致。標籤對象與提交對象不同,首次直接用帶註釋標籤對象讀取文件返回不存在,解析實際提交後成功;該失敗保留在核驗記錄中。源碼地圖區分官方庫調用、繼承的自寫溫度求解器與獨立復算腳本,許可證為官方 BSD 三條款及各繼承模塊記錄的許可。
最小實驗:同數據、同模型、不同映射
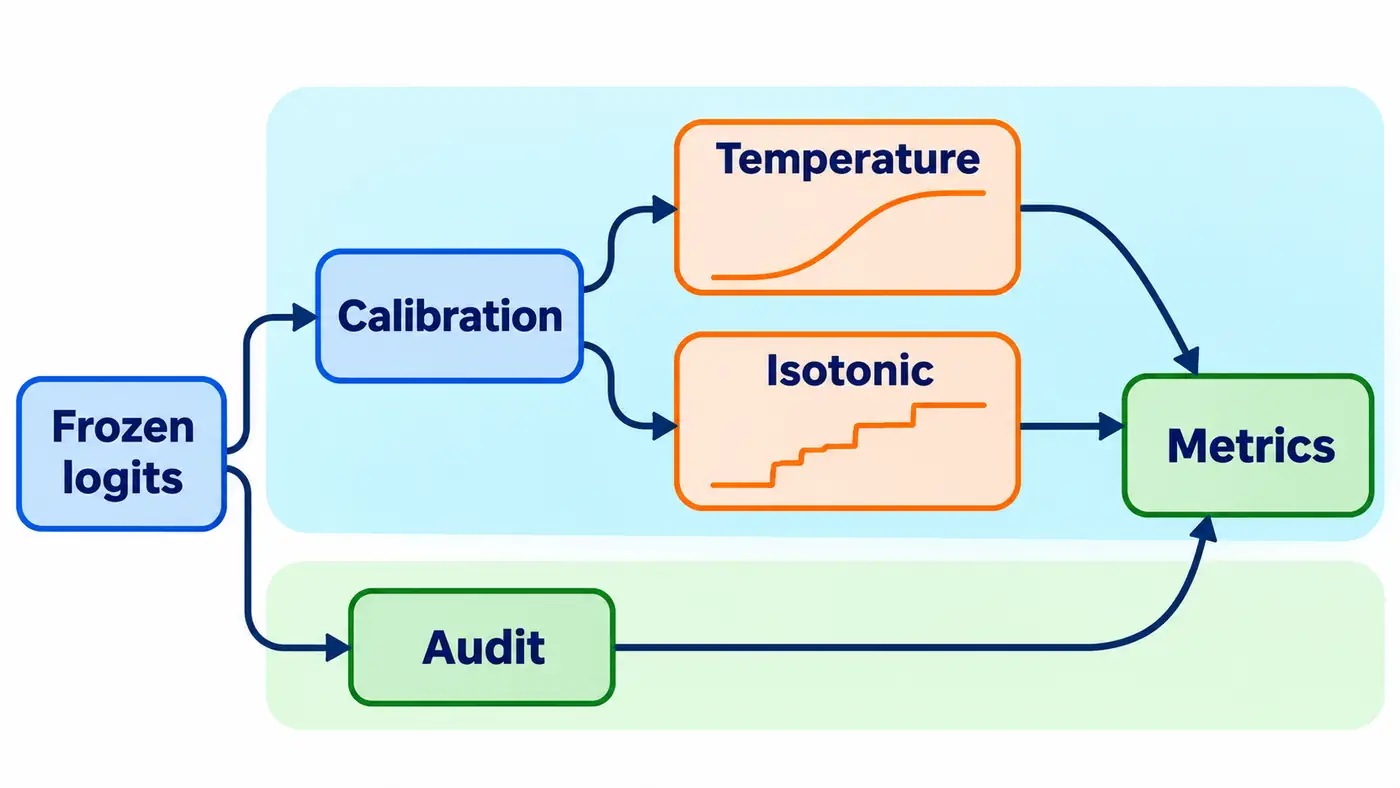
模型沿用固定 DistilBERT SST-2 檢查點;數據沿用官方 validation 的身份清單。原始劃分按身份哈希固定,探索池二百五十六條、校準池二百五十六條、協議審計池三百六十條互不相交。本篇只複用後兩池在前篇保存的真實 logits,不重新篩選句子,不新增語義標註。
SST-2 已在歷史實驗中使用,審計結果也在前兩篇被觀察。因此這裡的“獨立”只指未進入當前校準擬合,不能寫成從未見過的測試集。IMDb 三池本次均未推理,最終確認池保持未使用。
本篇預先凍結身份排序規則,取哈希前三十二條和完整二百五十六條形成嵌套條件。每個條件同時擬合溫度與保序迴歸,完整輸出原始概率對照。不換種子尋找更典型案例,不根據審計集選樣本量、映射或截斷參數。三十二條恰好全部預測正確,是執行後發現並保留的現象,不是挑出的“最佳校準集”。
運行使用已有固定模型緩存,先校驗文件哈希,再執行八條真實 CPU 試跑,重新取得形狀為八行兩列的輸出。正式方法比較複用六百一十六條歷史模型預測;不能稱為今天重新完成六百一十六次模型前向。本次新增分析實測約零點零二五秒,進程峰值內存約九十六 MiB;八條試跑前向約零點零七五秒,導入後的流程約零點五四八秒,完整環境與內存記錄隨源碼保存。下載使用已校驗緩存,本次不報告新的下載耗時。新增執行的是四次擬合、十二組評測以及獨立算術核驗,沒有模型訓練或付費計算。
結果:更低的擬合誤差沒有轉化為更好的審計表現
下表均是三百六十條審計樣本的實際結果。NLL 列使用預設截斷規則,所有方法共享相同分母;未經截斷的保序 NLL 在兩種樣本量下都為無窮大。
| 校準量 | 方法 | Brier | 截斷 NLL | 正確數 |
|---|---|---|---|---|
| 不擬合 | 原始概率 | 0.154001 | 0.384113 | 330 |
| 32 | 溫度縮放 | 0.166945 | 1.145233 | 330 |
| 32 | 保序迴歸 | 0.154905 | 0.614199 | 330 |
| 256 | 溫度縮放 | 0.135151 | 0.237136 | 330 |
| 256 | 保序迴歸 | 0.137395 | 0.420606 | 329 |
完整校準池上,保序迴歸擬合 Brier 為零點一一五八六七,低於溫度縮放的零點一四七三八五;審計集排序卻反過來。其審計輸出有二百四十九條處於零或一,其中七條把真實類別概率置零。溫度為約二點四八一九時,輸出沒有邊界概率。這說明不能只看校準集曲線是否貼合標籤,也不能只報告被截斷後的有限 NLL。
小樣本條件更值得保留。三十二條全部正確,把溫度推到零點零五的下界;保序迴歸則在擬合樣本上取得零 Brier。二者到了審計集都比原始概率差。保序迴歸有十一條真類概率為零,但 Brier 只略微變差:平方損失有界,對數損失對絕對錯誤的確信極其敏感,兩者回答的是不同問題。
溫度的小樣本結果還暴露了數值陷阱。有限 logits 與正溫度在數學上不會產生精確零概率,但浮點 sigmoid 可以舍入到一,隨後用一減它會得到零。因此新增一個明確標記的事後數值診斷:用穩定 softplus 直接從 logits 算未截斷 NLL。該條件穩定未截斷 NLL 為七點二七一三一四,仍然很差,但有限。它不改變預登記主指標、不重新選擇溫度,也不把舍入事件誤報成數學上的無窮損失。
失敗排查與獨立復算
第一步應檢查身份,不是調參數。確認兩種方法使用完全相同的校準編號,校準與審計不重疊,輸入文件哈希與協議一致。第二步檢查概率對象:這裡校準的是正類概率,不是最大類別置信度;混用二者會改變標籤含義。第三步檢查插值與外推規則,尤其是重複橫座標和校準範圍之外的預測。
獨立審計沒有再次調用官方擬合器,而是用保序最小二乘的區間平均最小最大表述重建擬合值,再獨立插值,逐項核對所有輸出與指標。最大概率差約為一乘十的負十六次方。模型試跑另與歷史八條輸出按身份比較,允許有記錄的浮點誤差,但要求類別一致。算術審計不是人工標籤審查;本篇未產生需要真人判斷的新語義標籤。
源碼與復現入口
公開固定版本已核驗:源碼目錄、README、SOURCE_MAP。配套包包含統一入口、官方模型下載與試跑腳本、固定依賴、配置、協議、源碼地圖、逐樣本派生結果和審計腳本。最小運行命令為:
python -m pip install -r requirements.txt
python run.py
python audit.py
預期生成 results.json、analysis_environment.json 與 audit_result.json。模型緩存可用時另執行 python model_run.py smoke --cache .cache;首次使用先運行對應的 prepare 命令。下載約需二百七十兆模型資源,默認 CPU 四線程,預算三十分鐘與六 GiB 內存。原始句子因數據卡許可不明確不隨包分發,下載腳本固定官方 revision,已有緩存必須通過哈希檢查。
還有一個容易混淆的地方是標籤閾值。溫度縮放仍以原始分數差的正負作分類,保序迴歸卻可能移動概率跨越二分之一的位置,也會製造平臺並列。本篇統一約定嚴格大於二分之一才預測正類,相等時預測負類。因此完整池條件下正確數從三百三十降到三百二十九,是實際映射及閾值共同產生的結果,不應將它悄悄改回原始類別後再報告準確率。
同樣,審計樣本量較大並不自動意味著比較可靠。兩種方法共享審計樣本,損失差是配對觀測;本篇沒有為差值構造區間,也沒有對多組候選作顯著性檢驗。零點零零二左右的 Brier 差只能作為本次固定樣本的描述。邊界錯誤更適合幫助提出下一步假設,不能替代跨劃分、跨數據域的驗證。
可檢驗的後續問題與總結
作者推斷是:靈活映射在稀疏分數區域缺少錯誤觀察時,更容易把局部純淨誤當確定性。但當前只有一個固定小樣本子集與一個完整池,不能估計這一現象的發生頻率,更不能宣佈方法普遍勝負。後續若要比較平滑保序、概率截斷或更多校準樣本,應另行登記候選與選擇規則,不能拿本篇審計結果反覆選出最好組合後繼續稱獨立評測。
下一篇將改變校準集類別比例,檢查全局溫度能否同時照顧兩類。本篇留下的可審查結論更剋制:相同數據下,擬合誤差下降不保證審計概率質量提高;邊界概率與數值舍入必須分開;分類正確數、平方損失、對數損失也不能互相替代。這些失敗本身就是連續研究需要保存的證據。
參考資料
檢索與源碼核驗日期:2026-11-04。
- Guo, C., Pleiss, G., Sun, Y., Weinberger, K. Q. 2017. On Calibration of Modern Neural Networks,ICML / PMLR 70。
- scikit-learn 官方:Isotonic regression 與 Probability calibration。動態文檔只作概念來源,實際執行版本固定為 1.6.1。
- scikit-learn 1.6.1:固定提交源碼。
- DistilBERT 固定模型卡。
- SST-2 固定數據版本。
作者作品推廣
以下是作者自有產品推廣。除了科研博客,我也獨立開發日常小工具:日常收支小記用於記錄收支、安排預算與儲蓄目標;一事微光幫助按時間、精力選擇小行動,並記錄完成後的感受。歡迎按自己的需要了解,也可以到個人網站閱讀更多文章與作品介紹。這些產品與本文論文、實驗結果及研究機構沒有背書關係。