可信預測實驗室:從模型置信度到可檢驗的拒答
給情感分類器八條帶答案的影評,讓它學一條規則,爭取在以後的影評上把正確標籤留在答案裡。它給三百六十條審計影評一律同時返回正面和負面。再給它第九條校準影評,二百八十七條馬上只剩一個答案。兩次使用同一組模型輸出,連最後一位小數都沒有變。究竟是哪一步決定了可以排除一個標籤?
先把這個現象拆成兩個問題。第一,目標覆蓋率定為九成時,八條能否給出有限的標準保形閾值?這個問題只要數位置就有答案。第二,拿到有限閾值後,有多少影評真的會少一個標籤?這需要看模型、校準樣本和審計樣本的真實分數。把兩個問題分開,才能判斷哪些實驗結果換一批數據仍可預言,哪些值得重新測量。
一張留給新樣本的位置
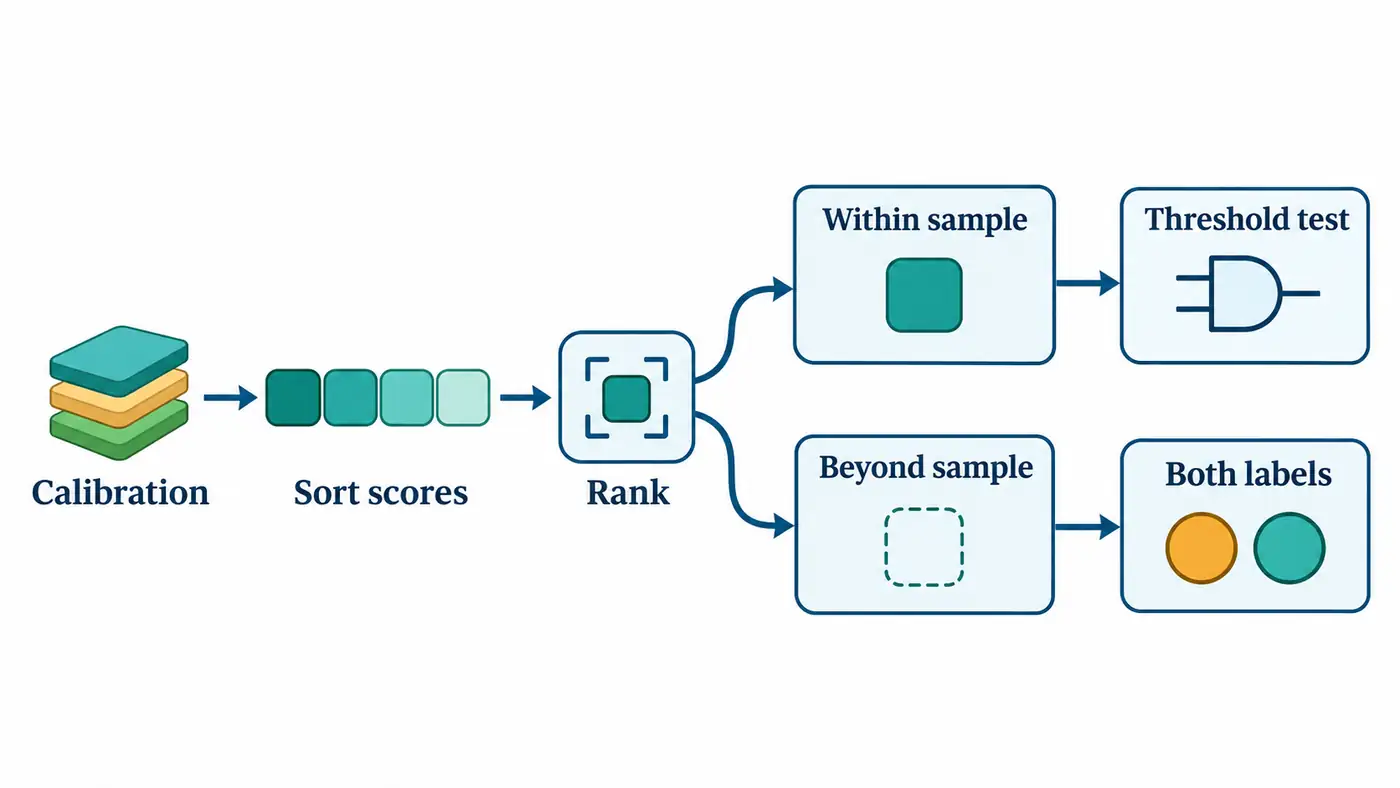
延續前文的分割保形預測。先固定已訓練的分類器,把每個可能答案與輸入之間的“不合適程度”寫成分數。這裡沿用 LAC,做法是從一減去模型給該標籤的概率。用帶標籤的校準數據時,每句話只交出真標籤對應的一個分數。預測新句子時,同時考察負面和正面兩個候選,分數低於或等於閾值的都可以留下來。
這裡 是輸入影評, 是候選標籤, 是兩列模型輸出經過歸一化後分給該類的概率。 是帶真標籤的校準句數, 是允許的邊際漏覆蓋概率, 從一開始數,式中的上取整符號表示向上取整。閾值從小到大取第 個校準分數;如果這個位置超出校準表,就把閾值設成正無窮。這條規則對任何有限的候選分數都給出明確結果。
為什麼要多算一個位置?在校準樣本與下一條樣本可交換、分數規則已經固定的條件下,可以想像先遮住哪一條是新來的,再把所有真標籤分數一起排序。沒有並列時,新樣本在每個位置的機會相同。有並列時保留等號會把邊界上的候選一起收下。覆蓋定理約束的是對校準和未來樣本共同取平均的概率;拿著已經抽出的八句話,無法從定理讀出某條新影評的個體正確率。論文的論證也沒有用到這三百六十條影評的觀測頻數。
八條校準分數加上一個新分數,一共九個可能位置。即使採用八條中最大的分數作閾值,在連續、可交換的理想情形下,也只能覆蓋前八個位置,八除以九仍低於九成。為了夠到目標必須把第九個位置也包括進來。校準表裡沒有第九個值,正無窮在這裡有具體的操作含義,兩個候選都會入集。改成九條校準時,共十個位置,只需覆蓋前九個,取九條中的最大值就能做到。由此能預言閾值何時可以有限,卻還不能預言集合會縮小多少。
最小實驗與評測協議
上一次固定校準規模,改變樣本劃分,考察多次覆蓋的分母。本次固定一個順序,只逐步放寬可以看見多少條校準標籤。沿用項目首次預測前登記的 SST-2 validation 身份清單。校準池有二百五十六條,協議審計池有三百六十條,二者身份無交集。前者保留原先按身份哈希排出的順序。每一檔都從頭截取,所以九條那一檔完整包含八條那一檔;這種配對使兩檔之間新進來的是哪條記錄可以追溯。
預先寫入協議的規模為 4、8、9、10、18、19、20、32、64、128、256。九條檢驗首次能取有限閾值的位置,十九條檢驗從取最大值轉為可以略過一個最大值的位置,大規模端點與系列早先的完整校準池結果接上。每檔並排計算標準規則與一個故意寫錯的對照:當秩越界時,對照把它截到最後一個已有位置。這樣兩種方法擁有相同的輸入、預算和評價樣本,差異只能從邊界處理傳來。所有檔位都保留,審計標籤只用來計數。
輸入來自公開的英文 SST-2 情感分類 DistilBERT 檢查點。複用二百五十六條校準記錄裡保存的原始兩列 logits,即歸一化之前的分類頭輸出。審計側先對八條做 CPU 試跑,再用同一固定模型對三百六十條重新分詞和前向計算。每批至多十六句,輸出形狀為批大小乘二。正式重放與歸檔兩列數值的最大絕對差為零。正式分批分詞與前向循環共約 1.25 秒,進程峰值內存約 914 MiB。曾在舊輪和本輪多次使用 SST-2,此處屬於歷史數據上的方法審計。沒有讀取 IMDb 或增加人工語義標籤。
覆蓋的分母固定為全部審計句子,分子為返回集合包含原始真標籤的句數。另記返回零個、一個、兩個候選各有多少句,用候選總數除以三百六十得到平均集合大小。空集也進入這兩個分母。若只對願意作答的句子計算覆蓋,分母已經變成條件樣本,得出的數無法與保形目標直接比較。
本次實際驗證
| 校準條數 | 目標秩 | 標準規則的空集/單標籤/雙標籤 | 覆蓋句數(共 360) |
|---|---|---|---|
| 4、8 | 分別為 5、9 | 0/0/360 | 360 |
| 9、10 | 分別為 9、10 | 0/287/73 | 350 |
| 18 | 18 | 0/242/118 | 353 |
| 19、20 | 分別為 18、19 | 0/287/73 | 350 |
| 32 | 30 | 0/335/25 | 339 |
| 64、128 | 分別為 59、117 | 0/337/23 | 338 |
| 256 | 232 | 0/351/9 | 333 |
從八條增加到九條,新增校準句的真類分數約為 0.993880,成為當時的最大值。把這個閾值交給審計集,仍有七十三句的兩個候選一起通過,其餘二百八十七句只有一個候選通過。三百五十句覆蓋,意味著十個單標籤集合排除了正確答案。以“雙標籤全部覆蓋”作起點,這次變化的收益是給出更多單一答案,代價也可以精確定位到哪十句話。給第十條的結果與九條相同,因為取的仍是最大值,新條目沒有刷新它。
有一個容易漏報的反向變化。從十條到十八條,平均大小從約 1.203 升到 1.328,雙標籤多了四十五句,卻只多覆蓋三句。在這段前綴上兩端都取最大值,新增條目把最大值推高。再添第十九條時,第十八小成了倒數第二個位置,閾值回落。這解釋了為什麼校準集變大並不要求每一步的集合都變小。它也給比較曲線提出一個要求:標出每檔實際取的是第幾小,以及附近兩條分數相距多遠,光標樣本數會遺漏變化的直接原因。
截斷對照在八條時給出截然不同的結果。校準表中的最大值只有約 0.003028,候選要拿到約 0.996972 以上的概率才能入集。審計池中九十一句返回空集,二百六十九句返回單標籤,覆蓋二百六十一句,實際比例為 72.5%。其平均大小約為 0.747,比每句一個候選還小。若報表只用平均大小衡量“效率”,恰好會獎勵最嚴重的漏覆蓋。到了九條,兩種實現的每一條決定都相同。在一份只用幾十或幾百條校準樣本的迴歸測試裡,這個實現錯誤可以一直不暴露。
官方代碼閱讀路線與失敗排查
從 TorchCP 的 LAC 計分器開始,先找提供標籤與不提供標籤的兩條取分路徑。再讀公共函數 calculate_conformal_value:檢查校準數量與目標秩的關係,越界分支直接返回正無窮,其餘情況才調用次序統計量函數。最後返回分割預測器,跟蹤閾值如何用於測試候選。這三處的固定版本和具體行號都在源碼地圖裡。本文用標準庫獨立實現取秩與選集,模型前向直接調用 Transformers 的官方分類類。
實現時最容易混淆三個細節。排序後的數組從零開始尋址,數學上的第九個元素在下標八處。概率方向也要核對,較高的真類概率對應較小的分數。最後,默認插值分位數可能選出兩個觀測之間的數,既改變了閾值,又可能掩蓋越界。本文把十分之一寫成精確分數來取整數秩。日誌中用 JSON 空值專門編碼無窮閾值,重讀時需恢復為接納全部候選的分支;若把它當成測量缺失並丟棄,最重要的兩檔會從結果表消失。
獨立審計另走一條計算路徑。對二分類,候選的不合適程度隨“另一類輸出減去該類輸出”單調上升。針對一個審計候選,直接數校準真類中有幾條差值嚴格比它小。計數小於目標秩時就接納,恰好相等則候選已經越過那個位置。這樣無需調用主程序的概率計算、排序和閾值函數,也能重建所有集合。腳本用歸檔審計 logits 檢查二十二個條件、七千九百二十個集合及一萬五千八百四十個成員決定,再回算大小分佈與覆蓋數。這裡的證據是可執行的算術核對,原始情感標籤取自數據集。
源碼與復現入口
固定版本已公開,可從本篇源碼目錄進入,按復現說明運行,或對照公式與官方代碼映射檢查實現。
進入本篇源碼目錄執行:
python run.py
python audit.py
第一條命令從隨包的真實預測重建結果表、逐句集合與輸入摘要,第二條輸出獨立核對結果。希望檢查某個端點時,先在結果表中按校準規模和規則定位,再用同樣的鍵打開逐句集合,按原始樣本身份對齊兩次輸出。需要重跑分類器時,復現說明給出了固定依賴、校驗緩存、八條試跑和完整審計的命令。原始影評與模型權重通過各自的公開來源獲取。
研究問題與總結
作者推斷可以拆成兩條可檢驗的預期。保持九成目標與當前非隨機規則,換一個校準順序,八條時依然會給所有句子兩個標籤。這一條在運行模型前就能判斷。九條時單標籤的數量則取決於新前綴的最大分數和審計候選分數,換序後未必還有二百八十七句。本實驗只運行了預先登記的一條嵌套路徑,表中差值沒有重複抽樣誤差線。若要估計換序後單標籤數的波動,應事先登記多組順序並共享同一批審計句;不能拿這裡的一次跳變充當波動範圍。
讀到一個看似完美的覆蓋率,先問所有候選是否都被交回給了讀者。再讀一個很小的平均集合,先看空集有多少,真類被丟掉多少次。本次模型本身始終只產生兩列相同的輸出,決定集合是否有辨別力的,是目標秩能否落入校準表,以及落點附近實際有哪些分數。下一步才有理由把同一規則放到事先定義的子群中,檢查總體覆蓋掩蓋了哪些差別。
參考資料
檢索日期為 2026-11-14。
- Angelopoulos、Bates,《A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification》,2021 年首次公開。分割保形的構造與覆蓋定理見第一節,有限樣本下的秩論證見附錄。作者全文
- SUSTech-ML,TorchCP,固定版本的有限樣本取秩及越界處理。分位數實現
- Hugging Face,英文 SST-2 分類頭與標籤配置。模型固定版本
- Stanford NLP,SST-2,validation 劃分與數據身份。數據固定版本
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。