面向研究生、科研新人和工程型研究者;檢索與實驗日期:2026-09-15。
摘要
世界模型的預測視頻看起來合理,不代表它在相同動作下預測了正確未來。本文把問題縮小到一個受控振盪系統:從軌跡學習下一狀態,再連續預測四十步,比較真實狀態輸入、預測狀態回灌和定期觀測校正。本次實際運行三個數據種子、九個小模型,保存全部權重與預測,並獨立復算。目標是理解序列預測和評測機制;沒有復現賽車、Minecraft 或論文控制成績。
目錄
- 復現價值:把“像真的”換成可檢驗目標
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議與獨立審計
- 失敗排查與證據邊界
- 後續科研問題
- 總結與參考資料
復現價值:把“像真的”換成可檢驗目標
世界模型學習環境如何隨動作變化。這裡的 rollout 指從一個起點連續展開未來狀態:第二步開始,輸入來自模型上一輪預測。與每一步都獲得真實狀態的單步評測相比,它更容易暴露累積偏差。好處是無需完整訓練智能體,就能先檢查動力學部分是否可信。
論文報告:Ha 與 Schmidhuber 的 World Models 將視覺壓縮、時間記憶和控制器分開;記憶模塊預測給定動作與歷史信息後的下一潛變量分佈。潛變量是壓縮觀測的數值表示,不等於真實物理狀態。原方法使用混合密度循環網絡表達多種可能未來,本文的確定性迴歸只保留動作條件預測這一接口。作者交互論文
DreamerV3 則在學到的潛在動力學中展開想像軌跡,用預測的獎勵等信號學習行為。本文閱讀的是二〇二四年修訂的預印本第二版,題名仍為 Mastering Diverse Domains through World Models;不把後來期刊版本的內容混入本次證據。版本頁;全文
本次提出三個可分辨的問題:只看當前位置會丟失什麼?線性近似離開訓練範圍後怎樣失效?每隔幾步讀一次真實狀態能緩解多少誤差?三個問題分別改變狀態信息、函數形式和觀測預算,不能合併成一個“模型更強”的結論。
核心思想與公式
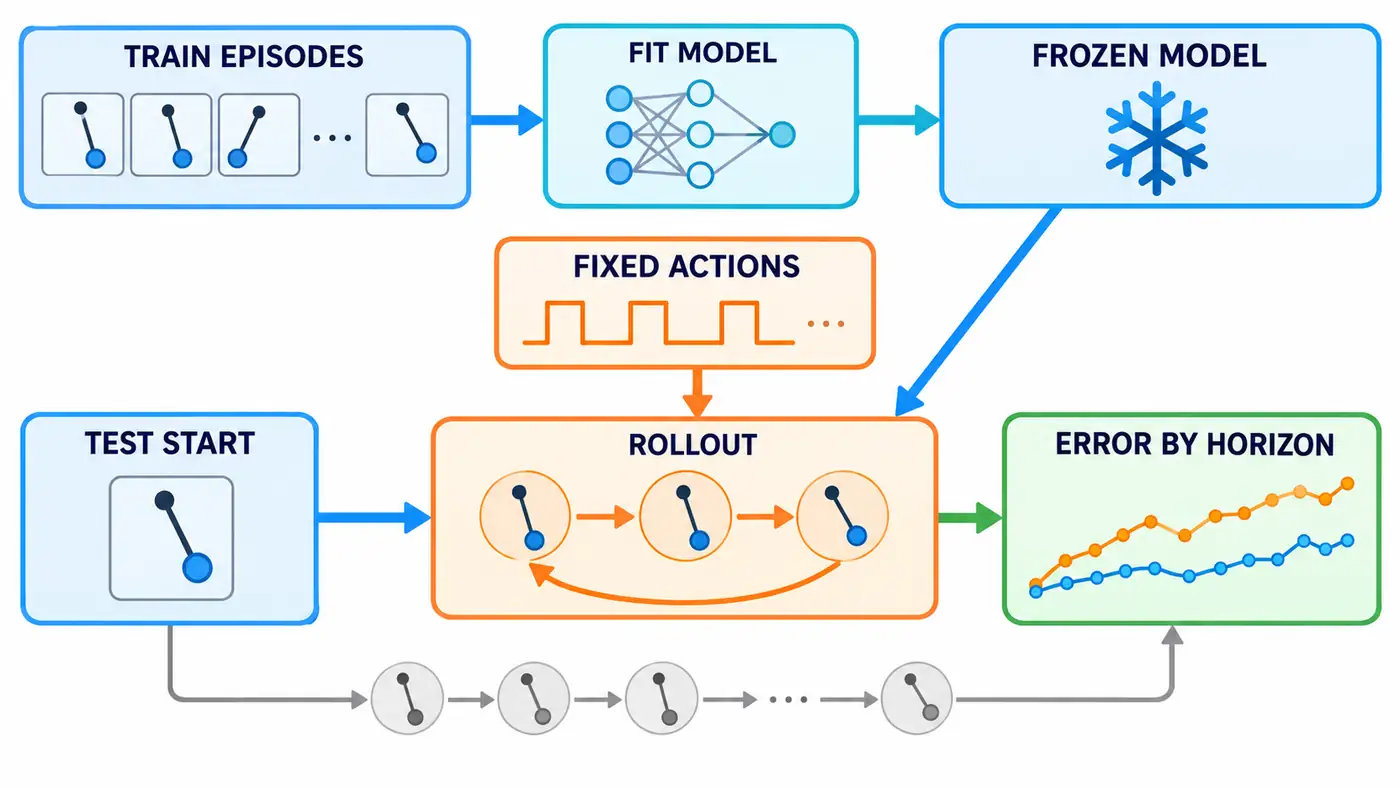
方法圖上方表示訓練後凍結模型,下方表示測試。灰色支路代表在同一動作序列下預先記錄的真值,只進入評分器;圖內曲線與擺動圖標都是概念示意,不是實測曲線。實際學習器是小型迴歸器,並非圖標暗示的神經網絡。
構造無噪聲離散系統:
為無量綱位置座標, 為速度變量, 從負半、零、正半三個值中採樣。狀態 是二維向量,動作是一維標量。它是帶阻尼和外力的教學振盪器,未校準真實裝置;封面也不是測量照片。先更新速度、再更新位置,交換順序會得到不同軌跡。
三個學習器均使用最小二乘:
是行特徵向量, 堆疊訓練轉移, 保存對應下一狀態, 是待學習係數;平方範數求和兩個輸出的殘差。完整線性模型的特徵為位置、速度、動作和常數,訓練矩陣形狀為 ,目標為 ,權重為 。
位置模型移除速度,仍預測兩個輸出,共六個參數,但下一步不使用預測速度。結構特徵模型在完整線性特徵後加入正弦項,共十個參數,恰好覆蓋真實方程的函數形式。這是已知結構的診斷參照,不能當作從數據自動發現物理規律。
訓練時,每個轉移的輸入都是真值,這對應 teacher forcing,即用真實前一步作為預測條件。開放展開則令 ,只在起點設置 。後續真實狀態可用於算誤差,卻不能進入預測器;動作也必須與生成真值時一致。
官方代碼閱讀路線
先讀原倉庫的 rnn_train.py。定位 random_batch,它從編碼均值與方差採樣潛變量;隨後輸入拼接當前潛變量和動作,輸出取潛變量序列向後錯一位的切片。先畫出這一對齊關係,再看優化器,能儘早發現把動作錯配到下一幀的問題。
然後讀 rnn.py:輸入寬度三十五來自三十二維潛變量與三個動作通道;混合頭輸出權重、均值與對數標準差,通過對數求和計算負對數似然。再沿 sample_sequence 看生成值怎樣寫回 prev_x、循環狀態怎樣更新。源碼使用舊 TensorFlow 接口,本次只閱讀,運行兼容性待人工核驗。
在 DreamerV3 的 rssm.py 中,RSSM 是循環狀態空間模型。比較 observe 與 imagine:前者融合觀測編碼,後者由內部狀態和動作產生先驗,並採樣下一隨機狀態。兩者都推進狀態,差別在於是否收到觀測證據。
最後讀 agent.py 的 report。開放預測報告先觀察序列前半段,再用後半段動作展開,解碼後拼接真實、預測與誤差畫面。這裡的預測是給定動作的條件預測。源碼中的 prevact 採用到達當前觀測的動作口徑,移植時要檢查時間索引,不能直接套用本文 的命名。
上述分支是檢索日的 master 或 main,未固定提交哈希,不保證與論文版本逐行對應。本次 NumPy 腳本獨立實現教學系統,沒有運行官方編碼器、隨機潛狀態、獎勵頭或策略訓練。
最小實驗與實際結果
在文章目錄運行,依賴與完整說明見 README:
python3 -m pip install -r code/requirements.txt
python3 code/world_model.py
python3 code/audit_results.py
實際環境為 Python 3.12.14、NumPy 2.3.5、CPU 雙精度。三個種子分別生成訓練一百二十八條、開發三十二條、同分布測試六十四條與分佈外測試六十四條軌跡,每條四十次轉移。種子控制數據採樣,最小二乘沒有隨機初始化;開發集僅記錄指標,沒有據此調參或選擇模型。
訓練、開發與同分布測試的初始位置在正負零點五之間;分佈外測試改為一點五至二點五。初速度都在正負零點三之間,動作規則不變。這裡“同分布”描述初始條件與採集規則,不保證預測狀態一直落在訓練軌跡覆蓋區間。
下表為三個種子的均值,全部使用位置均方誤差,逐種子結果與樣本標準差在 完整彙總。單步列平均全部四十個真實輸入時刻,後三列是從共同起點自由展開的指定步長,兩者採樣口徑不同。
| 模型與測試條件 | 單步誤差 | 第十步誤差 | 第二十步誤差 | 第四十步誤差 |
|---|---|---|---|---|
| 僅位置,同分布 | 4.28e-4 | 0.0255 | 0.1112 | 0.1024 |
| 完整線性,同分布 | 9.31e-10 | 1.68e-6 | 6.32e-6 | 1.63e-5 |
| 完整線性,分佈外 | 3.08e-5 | 0.2440 | 1.0553 | 0.0821 |
| 正弦結構,分佈外 | <1e-20 | <1e-20 | <1e-20 | <1e-20 |
本次實際驗證:完整線性模型在訓練附近較準確,但分佈外第二十步已有顯著偏差;第四十步又降低,提醒我們振盪軌跡可能重新接近,終點誤差不能代表整個過程。僅位置模型在同分布測試也失效,說明預測條件缺失與分佈變化是不同問題。
結構模型的誤差接近浮點舍入水平,因為特徵覆蓋無噪聲生成方程;獨立檢查也確認學到的係數與方程一致。這種結果只證明數據、求解與展開能對齊,不是世界模型已經解決泛化問題。
額外診斷每五步把輸入重置為真實狀態。完整線性模型在分佈外的全程位置誤差從 0.46198 降至 0.002255。重置發生在預測下一步之前,評分仍保留之前的錯誤輸出,沒有把評分點強行改成真值。它增加了真實觀測預算,不是模型重新訓練後的提升。運行記錄
評測協議與獨立審計
按完整軌跡劃分數據,禁止把同一回合的相鄰窗口隨機分到訓練與測試。所有模型共享同一種子下的初態和動作,權重只由訓練轉移求解;參數數目不同,因此位置消融也不是等參數對照。報告位置與速度的逐步誤差,正文只選位置用於清晰比較,不能將兩種單位任意混合後排名。
正式指標定義為
是該測試條件的軌跡數, 是從起點算起的預測步數, 與 使用相同動作序列。全程誤差再對四十個步長求平均;它不是第四十步誤差。三個數據種子的標準差反映這組採樣變化,不是置信區間,也不能把一條軌跡中的時刻視為獨立樣本。
獨立審計 不導入訓練腳本,用標量運算重演三萬四千五百六十次真實轉移、十七萬二千八百個預測狀態,復算四千五百一十二個指標值;最大預測差約為 4.0e-15。還檢查初態唯一、結構係數、訓練矩陣滿秩與最小二乘殘差條件。審計輸出
防止真值洩漏的檢查尤其直接:把測試軌跡除起點外的狀態全部替換成無意義數值,開放預測必須完全不變;第一步開放預測也必須等於相同起點的單步預測。兩項均通過。保存的數組足以讓讀者重算表格,而無需相信正文描述。
失敗排查與證據邊界
先檢查狀態是否足夠。位置為零、動作為零時,速度分別為正負零點三,下一位置相差 0.0588。位置模型看見完全相同輸入,卻需要給出兩個答案;增加同類樣本不能消除這個信息缺口。引入歷史位置或速度估計才是對應修復方向。
再檢查函數形式與範圍。作者推斷:訓練附近正弦函數近似線性,能夠解釋完整線性模型的小單步誤差;較大初始位置暴露這種近似的偏差,反覆回灌又改變後續輸入。結構參照支持這個解釋,但本實驗沒有把局部近似誤差、狀態偏移與每一步放大效應逐項分解。
也不要把“誤差累積”誤讀為必然指數爆炸。本次系統有阻尼,誤差可起伏;沒有推導統一增長率。若畫圖,應展示全程、明確縱軸,不能用兩張最好看的末幀替代逐步統計。
本實驗沒有感知噪聲、不可預測事件、動作策略變化或學習控制器。每五步讀取完整真狀態比真實傳感器校正更理想;確定性均方誤差也不能衡量隨機預測分佈是否校準。真實圖像、官方訓練、多步學習目標和控制回報實驗均未運行,待人工核驗。
後續科研問題
第一,給位置模型增加兩幀歷史,能否恢復速度信息?固定觀測預算,比較歷史差分與學習隱狀態,並加入測量噪聲,檢驗收益是否依賴精確座標。
第二,用多步損失訓練是否改善長程預測?預先確定訓練步長與開發選擇規則,在新測試集上同時報告單步和長程誤差,避免犧牲局部精度後只展示有利指標。
第三,有限觀測預算下應該何時校正?比較固定間隔和不確定性觸發,固定讀取次數,再檢查誤差峰值。若進一步學習策略,必須在真實模擬器驗證回報,防止策略利用模型錯誤獲取虛假獎勵。
總結
最小世界模型實驗的關鍵,是明確預測器每一步能讀取什麼,並把誤差放回時間軸。先分清狀態缺失、近似偏差和觀測校正的代價,再討論更復雜的潛變量與控制學習,論文復現才有可以逐步擴展的基礎。
參考資料
以下一手鍊接於 2026-09-15 實際檢索並打開;在線源碼未固定提交,未來兼容性待人工核驗。
- David Ha、Jürgen Schmidhuber,2018,World Models,arXiv v1。版本頁;作者交互論文。交互頁持續維護,不視為 v1 的逐字快照。
- 作者官方實驗代碼,WorldModelsExperiments,檢索日 master。訓練切片;混合密度網絡與採樣。
- Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap,2023,Mastering Diverse Domains through World Models,2024 修訂 v2。版本頁;全文。
- DreamerV3 官方代碼,檢索日 main。循環狀態空間模型;訓練與開放預測報告。