面向研究生、科研新人和工程型研究者;檢索與實驗日期:2026-09-14。
摘要
一個智能體沒有撞牆,卻始終到不了目標,究竟是感知錯誤、記憶缺失,還是預算太短?本文把具身導航縮小為可逐步審計的迷宮實驗:固定局部觀測與動作接口,只改變是否保留探索記憶,再用全圖規劃作為診斷參照。本次實際運行三百六十個回合,保存每一步狀態變化,並獨立復算成功率、路徑效率和獎勵。目標是復現交互與評測機制,而非宣稱復現真實機器人或論文訓練成績。
目錄
- 復現價值:讓失敗能被定位
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議與日誌
- 失敗排查與證據邊界
- 後續科研問題
- 總結與參考資料
復現價值:讓失敗能被定位
具身智能體通過動作改變環境,並從後續觀測獲得反饋。這裡保留位置、障礙、目標和有限行動預算,省去圖像識別與機械控制,便於把一次失敗追溯到具體決策。局部可見意味著智能體看到的只是環境的一部分:即使當前位置相同,過去是否走過某個岔路也會改變合理動作。
論文報告:Chevalier-Boisvert 等人在二〇二三年的 Minigrid & Miniworld 論文中介紹可定製的二維與三維目標任務環境,採用部分可觀測決策過程描述狀態、觀測和動作。其價值是讓研究者容易修改任務,而不是用一個小環境代表所有具身能力。論文及版本;全文第二節
本次問題是:同一個局部規劃程序,每步遺忘歷史與累積歷史,表現有何差異?這個對照比直接比較兩個複雜模型更容易解釋,但仍只針對選定的迷宮與手寫策略。不存在語言模型調用,也沒有強化學習訓練,獎勵不會反向更新參數。
核心思想與公式
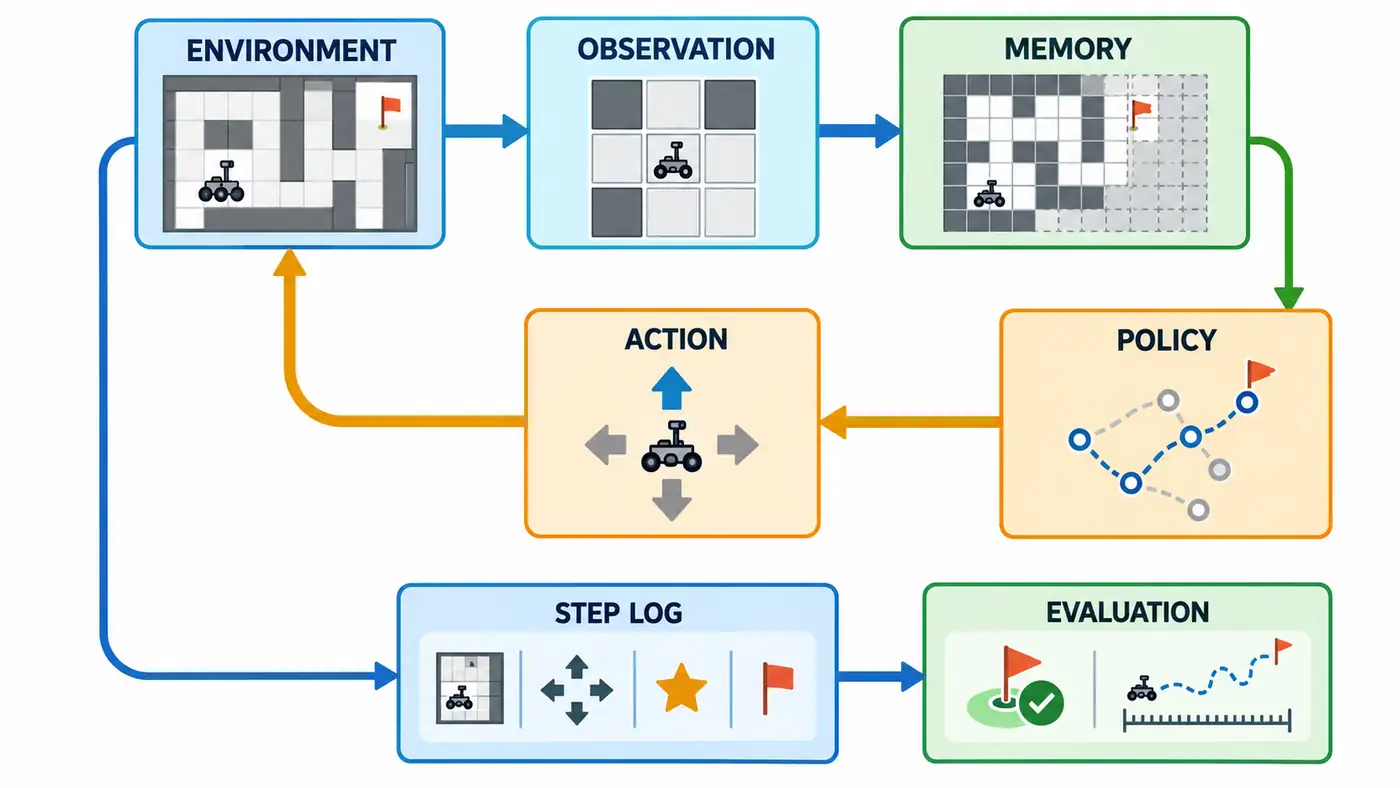
圖中環境經過局部觀測進入記憶,再由策略選擇動作;全狀態日誌獨立送入評測。網格只是概念示意,不是實驗截圖。目標座標是公開任務輸入,未知的是牆體與通路;評測器擁有全圖,普通策略不能讀取它。
可把交互寫為
是完整地圖、位置與目標構成的狀態, 是局部觀測, 是累計地圖和已訪問集合, 是動作。 表示傳感規則, 更新記憶, 執行移動。本次地圖形狀為九乘九,觀測含三乘三類別窗口、兩個座標向量;動作是四選一整數。窗口按行列讀取,座標按橫縱表示,混用會造成看似合理的錯誤移動。
本文另定義每步獎勵
指示函數在事件發生時取一,否則取零。成功動作也扣步數成本;撞牆位置不變但消耗一次預算。這個獎勵只用於日誌診斷,與 MiniGrid 默認的成功獎勵不同,不能比較回報數值。DoorKey 官方任務說明
成功率還應結合路徑長度。Anderson 等人的導航評測報告提出 SPL,即成功加權的歸一化逆路徑長度:
是測試回合數, 為成功標誌, 為全圖最短距離, 為實際移動距離。本實驗以格為單位,撞牆位移為零;另報把全部動作計入分母的效率,明確區別於 SPL。報告全文第四節
官方代碼閱讀路線
先讀固定標籤下的 doorkey.py:定位 _gen_grid,觀察分隔牆、鎖門、鑰匙和目標如何生成,再看任務如何繼承基類。這個順序能幫助判斷失敗是任務不可解,還是策略沒有完成前置操作。本次迷宮不含鑰匙與門,不能用它檢驗長程操作鏈。
再讀 minigrid_env.py 的 gen_obs_grid、gen_obs 與 step:先核對旋轉和可見性,再核對動作執行、獎勵與結束標誌。默認觀測字典中的 image 是局部編碼,不能因為字段名字就當作真實相機圖像;完整渲染也不等於策略實際收到的輸入。
源碼還有一個應專門測試的邊界:到達目標會設置 terminated,隨後達到步數上限又設置 truncated,所以兩者可能同時為真。回合控制在任一為真時結束,統計成功則檢查目標條件。上述閱讀固定在 v3.0.0 標籤,未實際安裝運行該庫;完整框架兼容性待人工核驗。
最小實驗與實際結果
入口 minimal_agent.py 僅依賴 Python 標準庫,本次使用 Python 3.9.6 在 CPU 執行。依賴、字段與復算方式見 README。在文章目錄運行:
python3 code/minimal_agent.py
python3 code/audit_trajectories.py
程序通過深度優先搜索挖出連通迷宮,起點固定;目標從最短距離至少八格的候選位置採樣。開發集保留五張地圖但未用於調參,測試集三十張,按地圖哈希去重。測試種子從一百順序掃描,重複地圖跳過;原始地圖、目標及被拒種子全部保存,沒有按策略成績篩選地圖。
比較四個策略。隨機策略均勻採樣四動作;記憶策略合併局部格子,優先走向已知可達目標,否則用廣度優先搜索走向最近未訪問格。廣度優先搜索按移動步數尋找最短路線。清空記憶策略每步重置累計格子和訪問集合,再執行同一個選擇程序。全圖規劃擁有特權信息,只作為可達性和預算診斷參照。
各策略在十六、三十二、六十四步預算上運行同一測試集,共三百六十回合。隨機策略使用地圖種子派生的固定隨機源,預算變化時保持動作前綴一致。以下為三十二步條件的實際結果,所有均值以三十張地圖為分母。運行輸出;完整彙總
| 策略 | 成功率 | SPL | 平均動作數 | 回合碰撞率均值 |
|---|---|---|---|---|
| 隨機動作 | 0.000 | 0.000 | 32.00 | 0.590 |
| 每步清空記憶 | 0.067 | 0.067 | 30.40 | 0.000 |
| 保留記憶 | 0.933 | 0.906 | 18.40 | 0.000 |
| 特權全圖規劃 | 1.000 | 1.000 | 16.80 | 0.000 |
清空記憶只成功兩次,其餘二十八回合超時,卻沒有任何碰撞;當前局部避障可以正確,探索仍可能陷入往返。保留記憶成功二十八次,SPL 低於成功率,說明成功軌跡也有繞路。平均動作數包含失敗,不能解讀成“成功所需步數”。
預算增至六十四步,記憶策略全部成功,但 SPL 仍為 0.946;清空記憶仍只成功兩次。額外時間緩解了探索不足,沒有修復遺忘造成的循環。十六步時,全圖規劃也僅成功十八次,因此部分超時首先是預算不足。這些是當前合成任務的實測結果,沒有論文基準分數含義。
評測協議與日誌
每步保存當前觀測、動作、下步觀測、獎勵、碰撞和兩個結束標誌;回合記錄地圖哈希、種子、預算、最短路及策略名。全圖保存在獨立規格文件,普通策略函數只接收觀測。對象接口幫助防止意外讀取,但它不是針對惡意代碼的安全沙箱。
獨立審計程序 不導入主程序,用另一種距離鬆弛算法計算最短路,再根據保存動作重演九千五百零八次轉移、檢查一萬九千零十六個觀測、復算八十四個彙總指標。不同預算的二百四十組軌跡前綴也通過一致性檢查。審計記錄
路徑指標也有盲區:在相鄰目標前先撞牆兩次、再成功移動一次,實際位移仍只有一格,SPL 為一,而按動作數計算的效率只有三分之一。這項受控檢查說明,路徑最短不等於執行代價最低。若增加旋轉、等待或工具動作,應分別記錄距離、動作數和耗時,不要讓零位移動作消失在成本統計裡。
狀態終止和外部截斷應分開處理。Gymnasium 文檔指出,因外部時間限制停止時,價值學習通常仍需從下一狀態估值;任務真正終止時才停止自舉。本次只算一個假設反例:獎勵負零點零六、折扣零點九九、下一狀態估值零點五,截斷目標應為 0.435;若把所有結束都當終止,會得到負零點零六。這不是學到的價值函數。時間限制說明
本實驗把預算視為外部限制;若研究問題本身規定限時完成,應重新定義有限時域任務並考慮把剩餘時間加入觀測,不能機械照搬截斷口徑。實現還檢查最後一步成功時雙標誌、非法動作、撞牆計步以及結束後拒絕繼續執行。
失敗排查與證據邊界
先看地圖與動作是否一致,再檢查局部輸入、記憶更新和停止規則。測試地圖一百上,記憶策略最短路十八格,卻在三十二步後失敗,已發生八次回訪;地圖一百一十六最短路二十二格,有六次回訪。這是探索順序的代價,不能歸因於碰撞。增加預算後的成功軌跡提供了可重演的佐證。
開發中也出現了協議問題:不同種子生成相同地圖,最初的唯一性斷言失敗;固定角落目標又讓首輪記憶策略恰好都走最短路。隨後改為按哈希去重、採樣目標,凍結後完整重跑。前一輪分數沒有混入正式表格。這次數據設計參考了初輪觀察,因此所謂測試集仍是教學診斷集,不是未受開發影響的獨立泛化證據。驗證說明
作者推斷:這裡的收益來自歷史地圖與訪問集合共同保留,尚不能區分兩者貢獻。完美定位、靜態牆體、沒有感知噪聲和固定動作成本使任務容易;三乘三窗口也沒有視線遮擋計算。結果不能外推到相機導航、真實機器人、語言規劃或學習算法。隨機策略僅使用一組固定派生種子,零成功也不是其總體成功概率為零。
後續科研問題
第一,分別保留地圖、訪問計數與目標歷史,哪部分減少無效往返?應在新凍結地圖集上做單因素消融,按地圖配對比較回訪次數和成功率,不能只報最高分種子。
第二,記憶容量受限時,保留最近觀測還是保留關鍵岔路更有效?固定存儲預算,增加迷宮規模,觀察被遺忘位置與失敗軌跡是否對應;同一地圖不同預算屬於配對條件,不能當作新增獨立樣本。
第三,加入定位噪聲後,更多記憶是否反而累積錯誤地圖?先注入已知擾動、檢查座標合併,再接真實感知模塊。真實 MiniGrid、DoorKey 前置操作鏈、學習策略、多隨機重複與置信區間均尚未執行,待人工核驗。
總結
小環境的科研價值在於把狀態、觀測、動作、獎勵與日誌接成可檢查的閉環。先證明輸入沒有越界、軌跡可以復算,再討論記憶與預算的作用,才能把“智能體失敗了”改寫成明確、可檢驗的研究問題。
參考資料
以下一手資料均於 2026-09-14 實際檢索並打開;論文為所列版本,源碼固定 v3.0.0,在線文檔內容可能變化。
- Maxime Chevalier-Boisvert、Bolun Dai、Mark Towers、Rodrigo de Lazcano、Lucas Willems、Salem Lahlou、Suman Pal、Pablo Samuel Castro、Jordan Terry,2023,Minigrid & Miniworld: Modular & Customizable Reinforcement Learning Environments for Goal-Oriented Tasks,arXiv v1。版本頁;全文。
- Peter Anderson 等十一位作者,2018,On Evaluation of Embodied Navigation Agents,arXiv v1,導航評測工作組報告。作者與版本;全文。
- Farama Foundation,MiniGrid v3.0.0:環境基類;DoorKey 生成代碼;官方任務文檔。
- Farama Foundation,Gymnasium,Handling Time Limits,main 文檔:終止、截斷與自舉說明。