开源 AI 论文复现实验与代码解读 · 第五轮 / 073
面向研究生、科研新人和工程型研究者;检索与实验日期:2026-09-14。
摘要
一个智能体没有撞墙,却始终到不了目标,究竟是感知错误、记忆缺失,还是预算太短?本文把具身导航缩小为可逐步审计的迷宫实验:固定局部观测与动作接口,只改变是否保留探索记忆,再用全图规划作为诊断参照。本次实际运行三百六十个回合,保存每一步状态变化,并独立复算成功率、路径效率和奖励。目标是复现交互与评测机制,而非宣称复现真实机器人或论文训练成绩。
目录
- 复现价值:让失败能被定位
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与日志
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
复现价值:让失败能被定位
具身智能体通过动作改变环境,并从后续观测获得反馈。这里保留位置、障碍、目标和有限行动预算,省去图像识别与机械控制,便于把一次失败追溯到具体决策。局部可见意味着智能体看到的只是环境的一部分:即使当前位置相同,过去是否走过某个岔路也会改变合理动作。
论文报告:Chevalier-Boisvert 等人在二〇二三年的 Minigrid & Miniworld 论文中介绍可定制的二维与三维目标任务环境,采用部分可观测决策过程描述状态、观测和动作。其价值是让研究者容易修改任务,而不是用一个小环境代表所有具身能力。论文及版本;全文第二节
本次问题是:同一个局部规划程序,每步遗忘历史与累积历史,表现有何差异?这个对照比直接比较两个复杂模型更容易解释,但仍只针对选定的迷宫与手写策略。不存在语言模型调用,也没有强化学习训练,奖励不会反向更新参数。
核心思想与公式
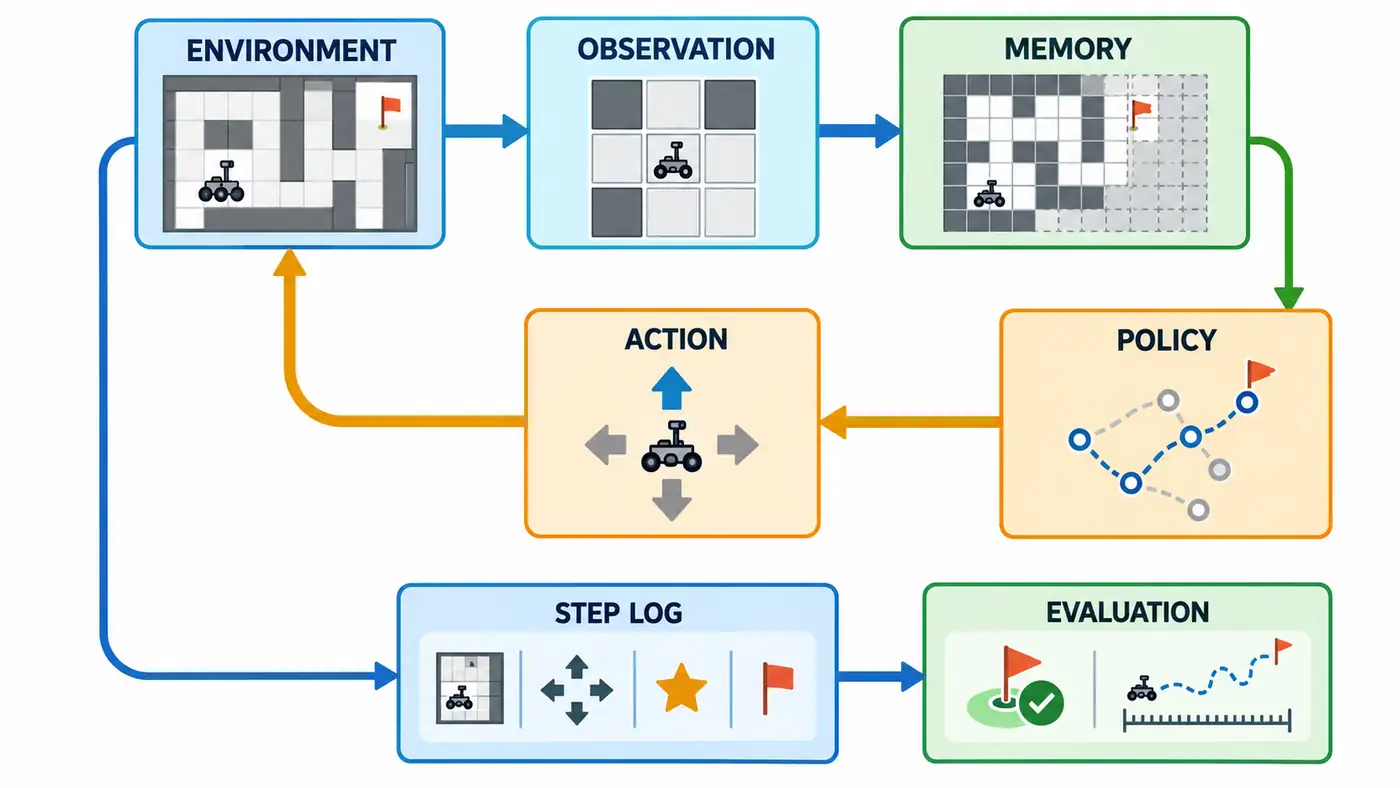
图中环境经过局部观测进入记忆,再由策略选择动作;全状态日志独立送入评测。网格只是概念示意,不是实验截图。目标坐标是公开任务输入,未知的是墙体与通路;评测器拥有全图,普通策略不能读取它。
可把交互写为
$$ o_t=\Omega(s_t),\quad m_t=U(m_{t-1},o_t),\quad a_t=\pi(o_t,m_t),\quad s_{t+1}=T(s_t,a_t). $$
$s_t$ 是完整地图、位置与目标构成的状态,$o_t$ 是局部观测,$m_t$ 是累计地图和已访问集合,$a_t$ 是动作。$\Omega$ 表示传感规则,$U$ 更新记忆,$T$ 执行移动。本次地图形状为九乘九,观测含三乘三类别窗口、两个坐标向量;动作是四选一整数。窗口按行列读取,坐标按横纵表示,混用会造成看似合理的错误移动。
本文另定义每步奖励
$$ r_t=\mathbf 1[\text{到达目标}]-0.01-0.05\mathbf 1[\text{撞墙}]. $$
指示函数在事件发生时取一,否则取零。成功动作也扣步数成本;撞墙位置不变但消耗一次预算。这个奖励只用于日志诊断,与 MiniGrid 默认的成功奖励不同,不能比较回报数值。DoorKey 官方任务说明
成功率还应结合路径长度。Anderson 等人的导航评测报告提出 SPL,即成功加权的归一化逆路径长度:
$$ \mathrm{SPL}=\frac1N\sum_{i=1}^{N}S_i\frac{\ell_i}{\max(\ell_i,p_i)}. $$
$N$ 是测试回合数,$S_i$ 为成功标志,$\ell_i$ 为全图最短距离,$p_i$ 为实际移动距离。本实验以格为单位,撞墙位移为零;另报把全部动作计入分母的效率,明确区别于 SPL。报告全文第四节
官方代码阅读路线
先读固定标签下的 doorkey.py:定位 _gen_grid,观察分隔墙、锁门、钥匙和目标如何生成,再看任务如何继承基类。这个顺序能帮助判断失败是任务不可解,还是策略没有完成前置操作。本次迷宫不含钥匙与门,不能用它检验长程操作链。
再读 minigrid_env.py 的 gen_obs_grid、gen_obs 与 step:先核对旋转和可见性,再核对动作执行、奖励与结束标志。默认观测字典中的 image 是局部编码,不能因为字段名字就当作真实相机图像;完整渲染也不等于策略实际收到的输入。
源码还有一个应专门测试的边界:到达目标会设置 terminated,随后达到步数上限又设置 truncated,所以两者可能同时为真。回合控制在任一为真时结束,统计成功则检查目标条件。上述阅读固定在 v3.0.0 标签,未实际安装运行该库;完整框架兼容性待人工核验。
最小实验与实际结果
入口 minimal_agent.py 仅依赖 Python 标准库,本次使用 Python 3.9.6 在 CPU 执行。依赖、字段与复算方式见 README。在文章目录运行:
python3 code/minimal_agent.py
python3 code/audit_trajectories.py
程序通过深度优先搜索挖出连通迷宫,起点固定;目标从最短距离至少八格的候选位置采样。开发集保留五张地图但未用于调参,测试集三十张,按地图哈希去重。测试种子从一百顺序扫描,重复地图跳过;原始地图、目标及被拒种子全部保存,没有按策略成绩筛选地图。
比较四个策略。随机策略均匀采样四动作;记忆策略合并局部格子,优先走向已知可达目标,否则用广度优先搜索走向最近未访问格。广度优先搜索按移动步数寻找最短路线。清空记忆策略每步重置累计格子和访问集合,再执行同一个选择程序。全图规划拥有特权信息,只作为可达性和预算诊断参照。
各策略在十六、三十二、六十四步预算上运行同一测试集,共三百六十回合。随机策略使用地图种子派生的固定随机源,预算变化时保持动作前缀一致。以下为三十二步条件的实际结果,所有均值以三十张地图为分母。运行输出;完整汇总
| 策略 | 成功率 | SPL | 平均动作数 | 回合碰撞率均值 |
|---|---|---|---|---|
| 随机动作 | 0.000 | 0.000 | 32.00 | 0.590 |
| 每步清空记忆 | 0.067 | 0.067 | 30.40 | 0.000 |
| 保留记忆 | 0.933 | 0.906 | 18.40 | 0.000 |
| 特权全图规划 | 1.000 | 1.000 | 16.80 | 0.000 |
清空记忆只成功两次,其余二十八回合超时,却没有任何碰撞;当前局部避障可以正确,探索仍可能陷入往返。保留记忆成功二十八次,SPL 低于成功率,说明成功轨迹也有绕路。平均动作数包含失败,不能解读成“成功所需步数”。
预算增至六十四步,记忆策略全部成功,但 SPL 仍为 0.946;清空记忆仍只成功两次。额外时间缓解了探索不足,没有修复遗忘造成的循环。十六步时,全图规划也仅成功十八次,因此部分超时首先是预算不足。这些是当前合成任务的实测结果,没有论文基准分数含义。
评测协议与日志
每步保存当前观测、动作、下步观测、奖励、碰撞和两个结束标志;回合记录地图哈希、种子、预算、最短路及策略名。全图保存在独立规格文件,普通策略函数只接收观测。对象接口帮助防止意外读取,但它不是针对恶意代码的安全沙箱。
独立审计程序 不导入主程序,用另一种距离松弛算法计算最短路,再根据保存动作重演九千五百零八次转移、检查一万九千零十六个观测、复算八十四个汇总指标。不同预算的二百四十组轨迹前缀也通过一致性检查。审计记录
路径指标也有盲区:在相邻目标前先撞墙两次、再成功移动一次,实际位移仍只有一格,SPL 为一,而按动作数计算的效率只有三分之一。这项受控检查说明,路径最短不等于执行代价最低。若增加旋转、等待或工具动作,应分别记录距离、动作数和耗时,不要让零位移动作消失在成本统计里。
状态终止和外部截断应分开处理。Gymnasium 文档指出,因外部时间限制停止时,价值学习通常仍需从下一状态估值;任务真正终止时才停止自举。本次只算一个假设反例:奖励负零点零六、折扣零点九九、下一状态估值零点五,截断目标应为 0.435;若把所有结束都当终止,会得到负零点零六。这不是学到的价值函数。时间限制说明
本实验把预算视为外部限制;若研究问题本身规定限时完成,应重新定义有限时域任务并考虑把剩余时间加入观测,不能机械照搬截断口径。实现还检查最后一步成功时双标志、非法动作、撞墙计步以及结束后拒绝继续执行。
失败排查与证据边界
先看地图与动作是否一致,再检查局部输入、记忆更新和停止规则。测试地图一百上,记忆策略最短路十八格,却在三十二步后失败,已发生八次回访;地图一百一十六最短路二十二格,有六次回访。这是探索顺序的代价,不能归因于碰撞。增加预算后的成功轨迹提供了可重演的佐证。
开发中也出现了协议问题:不同种子生成相同地图,最初的唯一性断言失败;固定角落目标又让首轮记忆策略恰好都走最短路。随后改为按哈希去重、采样目标,冻结后完整重跑。前一轮分数没有混入正式表格。这次数据设计参考了初轮观察,因此所谓测试集仍是教学诊断集,不是未受开发影响的独立泛化证据。验证说明
作者推断:这里的收益来自历史地图与访问集合共同保留,尚不能区分两者贡献。完美定位、静态墙体、没有感知噪声和固定动作成本使任务容易;三乘三窗口也没有视线遮挡计算。结果不能外推到相机导航、真实机器人、语言规划或学习算法。随机策略仅使用一组固定派生种子,零成功也不是其总体成功概率为零。
后续科研问题
第一,分别保留地图、访问计数与目标历史,哪部分减少无效往返?应在新冻结地图集上做单因素消融,按地图配对比较回访次数和成功率,不能只报最高分种子。
第二,记忆容量受限时,保留最近观测还是保留关键岔路更有效?固定存储预算,增加迷宫规模,观察被遗忘位置与失败轨迹是否对应;同一地图不同预算属于配对条件,不能当作新增独立样本。
第三,加入定位噪声后,更多记忆是否反而累积错误地图?先注入已知扰动、检查坐标合并,再接真实感知模块。真实 MiniGrid、DoorKey 前置操作链、学习策略、多随机重复与置信区间均尚未执行,待人工核验。
总结
小环境的科研价值在于把状态、观测、动作、奖励与日志接成可检查的闭环。先证明输入没有越界、轨迹可以复算,再讨论记忆与预算的作用,才能把“智能体失败了”改写成明确、可检验的研究问题。
参考资料
以下一手资料均于 2026-09-14 实际检索并打开;论文为所列版本,源码固定 v3.0.0,在线文档内容可能变化。
- Maxime Chevalier-Boisvert、Bolun Dai、Mark Towers、Rodrigo de Lazcano、Lucas Willems、Salem Lahlou、Suman Pal、Pablo Samuel Castro、Jordan Terry,2023,Minigrid & Miniworld: Modular & Customizable Reinforcement Learning Environments for Goal-Oriented Tasks,arXiv v1。版本页;全文。
- Peter Anderson 等十一位作者,2018,On Evaluation of Embodied Navigation Agents,arXiv v1,导航评测工作组报告。作者与版本;全文。
- Farama Foundation,MiniGrid v3.0.0:环境基类;DoorKey 生成代码;官方任务文档。
- Farama Foundation,Gymnasium,Handling Time Limits,main 文档:终止、截断与自举说明。