- 系列:开源 AI 论文复现实验与代码解读 · 第五轮 · 079
- 日期:2026-09-21
- 适合读者:研究生、科研新人和工程型研究者
- 复现范围:二分类线性模型、连续扰动与评测审计;文本模板提供设计样例,模型推理待人工核验。
摘要
给输入加一点噪声,模型仍然答对,不足以说明它能抵抗有目的的扰动。更隐蔽的错误是:攻击程序步数太少、梯度断开或预算单位错了,却把攻击失败当作模型成功。本文训练一个可解析的分类器,把随机搜索、单步梯度和多步攻击逐条对照最坏情况解。目标是建立可信的评测链,而非复刻大型视觉模型的榜单成绩。
目录
- 复现价值与论文问题
- 核心公式与威胁模型
- 官方代码阅读路线
- 最小实验与运行方式
- 评测协议
- 实际结果与失败分析
- 文本攻击模板的语义边界
- 失败排查与验证记录
- 后续科研问题与总结
一、复现价值与论文问题
对抗样本是按照某种限制主动寻找的错误输入,和随机噪声具有不同目的。论文报告。 Goodfellow 等人的工作提出快速梯度符号法,即 FGSM,并用线性累积解释小扰动的影响;Madry 等人将问题写成鲁棒优化,分开“寻找坏输入”和“学习好参数”两个环节。[1][2]
AutoAttack 进一步指出,步长、目标函数和梯度问题会影响评测,组合互补攻击可以揭示单一攻击漏掉的失败。[3] 这仍不是所有扰动均被排除的数学证明。本文选择简单模型,是因为它有精确答案:我们能直接检查评测器是否漏报,而不必先相信另一种更强的攻击。
二、核心公式与威胁模型
威胁模型规定攻击者知道什么、能改什么、改多大,以及怎样算成功。本次允许读取权重与真实标签,属于白盒、非定向攻击;攻击输入特征,不修改训练数据、标签或模型参数。非定向意味着只要求预测错误,不指定错误类别。
鲁棒训练的常见目标为:
[ \min_\theta\mathbb E_{(x,y)}\left[\max_{|\delta|_\infty\leq\epsilon}L(\theta,x+\delta,y)\right]. ]
这里参数为 θ,样本及标签为 x、y,扰动为 δ;无穷范数约束每一维的绝对改变量不超过 ε。内层增大损失,外层调整参数。本文只训练普通分类器,然后检验内层求解,没有执行对抗训练。
设二十维输入的分数为 f(x)=wᵀx+b,标签为正负一,逻辑损失为 log(1+exp(−yf(x)))。批量输入形状为 [N,20],权重为 [20],分数和标签均为 [N]。有符号间隔 m=yf(x) 为正表示分类正确,数值越小越接近失败。
在不额外裁剪输入域时,最小间隔可精确写为:
[ m_* = y(w^\top x+b)-\epsilon|w|1, \qquad \delta*=-\epsilon y,\mathrm{sign}(w). ]
权重绝对值之和决定预算能削减多少间隔。每一维都沿不利方向移动,正好达到这个下界。这里的精确性依赖二分类线性分数、单调逻辑损失与所声明的扰动集合,不能直接推广到深层网络。本次数据没有零间隔并列;一般实现需明确并列如何判类。
FGSM 使用一次输入梯度的符号;投影梯度攻击 PGD 则重复“沿梯度上升,再投影回原始输入附近”。虽然名字沿用梯度下降缩写,攻击步骤是在增大损失。每步投影围绕原始 x,不能围绕上一步重新划预算,否则总扰动会越界。
三、官方代码阅读路线
先读 MadryLab 的 pgd_attack.py。[4] LinfPGDAttack 保存预算、步数、步长和随机起点配置;tf.gradients 求的是损失对输入的梯度。perturb 中先更新输入,再裁剪到 x_nat±epsilon,最后裁剪到像素区间。前者限制攻击强度,后者保证输入合法,两者职责不同。
该实现返回最后一步,不能据此假定它已经保留所有历史失败。本文补上逐样本最差候选记录,再检查 AutoAttack 的 run_standard_evaluation:[5] 它先用干净预测初始化 robust_flags,随后把被任一攻击击败的样本标为失败。这是失败集合的并集,不是几种攻击准确率的平均。
阅读时还要追踪 set_version:当前标准配置会覆盖部分构造器默认值,不能只抄初始化中的重启数。两个仓库均为检索时的 master,未锁定提交;这里完成了静态阅读,官方框架、权重和动态依赖兼容性均待人工核验。
四、最小实验与运行方式
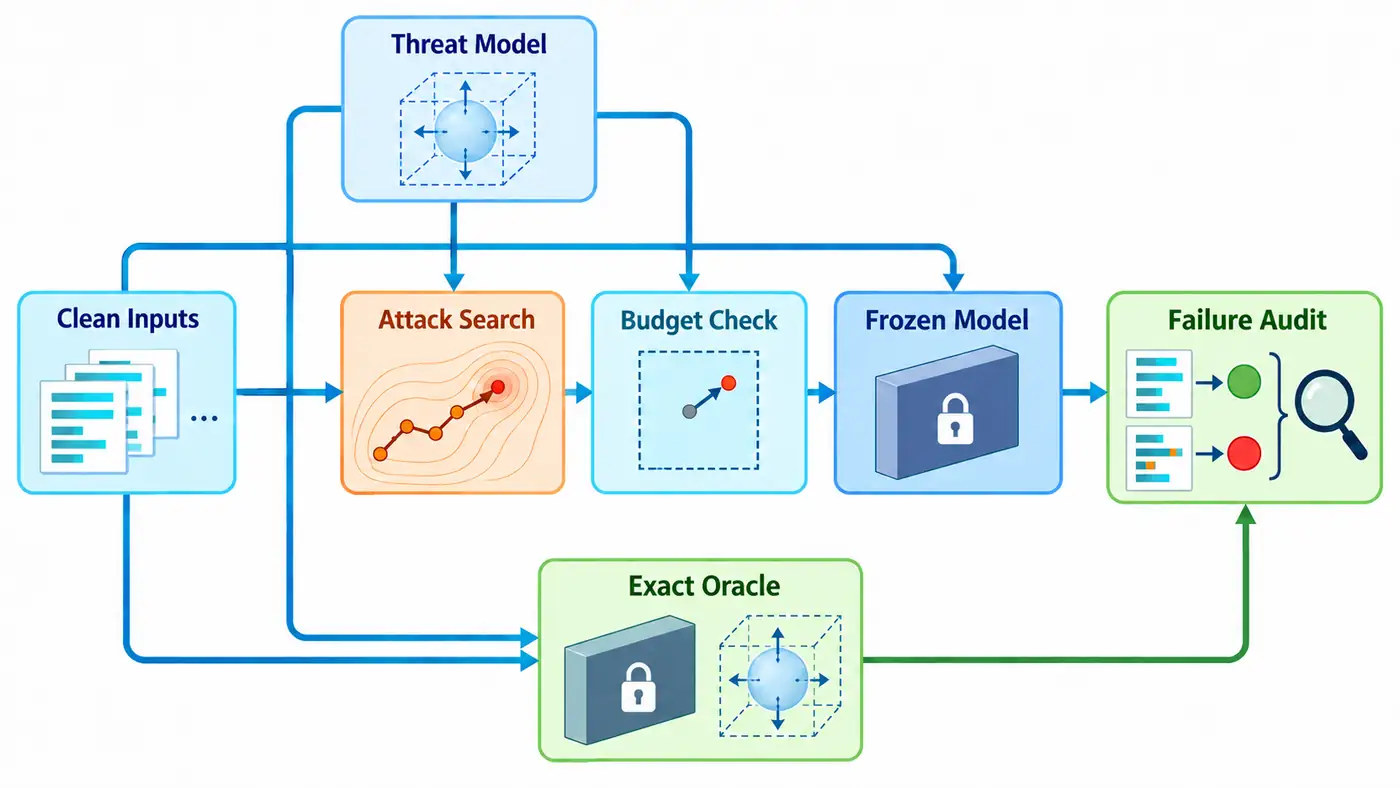
图中干净输入同时进入基线、攻击和解析核对分支。攻击候选通过预算检查后才交给冻结模型;解析分支与实际预测共同进入失败审计。交叉线不是汇合点,锁表示同一组固定参数。图标仅示意特征变化,不代表真实图像实验。
固定种子 79、80、81,每次独立生成训练、开发、测试集,数量为一千零二十四、二百五十六、二千零四十八。标签等概率取正负一;第一维是标签加标准差零点六的高斯噪声,其余十九维是零点一五倍标签加标准差零点三的独立噪声。完整输入行检查无重复。
这些是抽象测量特征,取值域为整个实数空间,未标准化,也不裁剪到像素范围。标签代表生成时的潜在类别,扰动后仍沿用它。这是明确规定的测量干扰任务,不是已经证明人类语义保持的自然数据。预算数值因此不能和图像像素预算直接比较。
模型只有二十一个参数,使用普通逻辑损失加 L2 正则;全批梯度下降一千步,学习率零点二,正则系数零点零一。开发集只记录分数,没有选参数;统一取最后一步。三次运行共同改变数据与初始化,标准差描述该合成设置的重复变化。
在文章目录执行:
python3 -m pip install -r code/requirements.txt
python3 code/robustness.py
python3 code/audit.py
实际环境为 Python 3.12.14、NumPy 2.3.5、CPU 双精度,已有依赖,无须安装。脚本打印关键形状,保存所有划分、权重、训练轨迹与最差攻击候选。文件解释见 运行说明。
五、评测协议
预先固定五个预算:零、零点零五、零点一、零点二、零点三。随机基线每条输入采十六个均匀扰动;弱 PGD 从干净输入走两步,步长为预算的二十分之一;FGSM 走一次完整预算;充分 PGD 使用三个随机起点,每次二十步,步长为预算的五分之一。
对每种搜索,始终把干净输入也列入候选;PGD 保留全部迭代和重启中的最低间隔。这样,后续步骤偶然把预测改回正确,也不会擦除已发现的失败。本次每条样本的分数都能和解析下界比较,除正确率外还报告漏掉的可攻击样本数。
经验鲁棒准确率以整个测试集为分母,要求干净输入和被搜索到的候选均正确;原本就错的样本也算失败。条件攻击成功率只以干净分类正确的样本为分母。一般情况下,有限搜索得到的鲁棒准确率是该测试集真正最坏情况鲁棒准确率的上界,攻击越弱,上界可能越松。
这些配置在读测试结果之前写入脚本,没有挑最好种子或回调参数。不同攻击计算预算并不相同,因此表格用于审计充分性,不能作为速度排名。若要比较效率,应另外保存梯度次数、前向次数与运行时间。
六、实际结果与失败分析
本次实际验证。 三次运行的干净准确率为 0.9946±0.0018。下面固定扰动预算零点二,报告均值及种子间样本标准差,非置信区间;详情见 实验结果。
| 候选搜索方式 | 经验鲁棒准确率 | 条件攻击成功率 |
|---|---|---|
| 随机十六次 | 0.9800 ± 0.0017 | 0.0147 |
| 两步、小步长 PGD | 0.9910 ± 0.0015 | 0.0036 |
| FGSM | 0.7697 ± 0.0124 | 0.2262 |
| 二十步、三起点 PGD | 0.7697 ± 0.0124 | 0.2262 |
FGSM 与充分 PGD 的每条间隔都达到解析下界;随机搜索平均漏掉约四百三十一条可攻击样本,弱 PGD 约四百五十三条。两步总位移只有预算的一成,即使方向正确也可能走不到边界。“用了梯度”不是攻击充分性的证据。
这里 FGSM 和充分 PGD 相等有模型结构上的原因,不能解释成多步攻击普遍无用。随预算增大,三个模型的解析鲁棒准确率均不升;这个规律针对嵌套的完整扰动集合,分别随机采样的有限搜索曲线却不一定单调。
我们还加入故障样例:直接返回原输入,模拟攻击没有移动。它显示零成功率,却漏掉平均约四百六十一条可攻击样本。它只验证审计器能否识别明显失效,不是对某种真实防御存在梯度遮蔽的实证。
七、文本攻击模板的语义边界
连续特征中的小距离不能直接解释文本中的小语义变化。CheckList 区分保持行为的测试与预期行为改变的测试,为设计文本实验提供了参考。[6] 例如“电影”换成“影片”预期仍为正面评价;把“很精彩”换成“不精彩”则改变了标签,不能继续把负面预测记为攻击成功。
附带 六条模板记录,包含标点、空白、近义词、指令格式,以及否定、反义词两个标签变化控制。每条保留原文、候选、修改预算和预期标签;这些标签是作者设计判断,待人工核验。这里只检查记录格式,没有调用语言模型,因此没有文本攻击成功率。
真正运行时应按模板族划分开发和测试,先固定总查询预算、输出解析规则与解码种子。只在原本答对且标签保持的样本上算条件成功率,同时报告无效改写比例。改变语义、输出格式变化与答案错误应分开,否则一个高攻击率可能只是金标没有更新。
八、失败排查与验证记录
先检查威胁模型:归一化之前和之后的预算不是同一个量;像素域裁剪会改变可行集合。本次审计另设边界样例,证明实数域解析式不能不加修改地用于被裁剪的像素。再检查梯度和统计:不要在攻击阶段禁用输入求导,也不要用平均损失改善代替逐样本失败检查。
两个脚本通过语法与 CPU 检查。独立审计不导入训练代码,用标量运算重算十五万三千六百条候选预测和三百零七万二千次坐标预算检查;最大数值差约 4.44e−15。训练与输入梯度的有限差分检查最大误差约 7.25e−12,详见 验证记录。
保存的是各搜索最终选中的最差候选,未持久化所有中间路径;独立审计也没有重新训练模型。这些限制应和结果一起交付。本次未运行官方神经网络、真实图像、GPU、AutoAttack 集成或语言模型,也不声称复现任何原论文的基准数值。
九、后续科研问题与总结
作者推断。 下一步可换成小型非线性网络,保持数据、预算和候选记录规则,观察 FGSM 与多重启 PGD 的差距;此时解析答案失效,需要新的验证方法。再比较不同训练目标,才能讨论鲁棒训练是否改善了失败集合,不能把更弱的攻击当作训练收益。
文本方向应先解决改写有效性:同一预算下,人工认可的标签保持比例是否随模板族变化?失败是否集中于否定、实体替换或输出解析?让每次攻击留下可回查的证据,才能把“模型没被打破”改写成更准确的科研结论:在已声明的约束与搜索预算下,我们发现了什么,又仍然排除不了什么。
参考资料
以下一手来源均于 2026-09-21 检索并实际打开;正文中的数字全部来自本地实验。
- Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy. Explaining and Harnessing Adversarial Examples. ICLR 2015;预印本始于 2014,本次读取 v3(2015-03-20)。版本页;全文。支撑 FGSM 与线性分析。
- Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt, Dimitris Tsipras, Adrian Vladu. Towards Deep Learning Models Resistant to Adversarial Attacks. ICLR 2018;预印本始于 2017,本次读取 v4(2019-09-04)。版本页;全文。支撑鲁棒优化与 PGD。
- Francesco Croce, Matthias Hein. Reliable evaluation of adversarial robustness with an ensemble of diverse parameter-free attacks. ICML 2020,PMLR 119:2206–2216。会议页。支撑评测陷阱与组合攻击。
- MadryLab 官方 pgd_attack.py,master,未锁定提交。支撑梯度、投影与像素域裁剪阅读。
- AutoAttack 官方 仓库;autoattack.py,master,未锁定提交。支撑失败集合累计与标准配置阅读。
- Marco Tulio Ribeiro, Tongshuang Wu, Carlos Guestrin, Sameer Singh. Beyond Accuracy: Behavioral Testing of NLP Models with CheckList. ACL 2020:4902–4912。会议页;全文。支撑行为测试的分类,不支撑本文未运行的文本成绩。