系列:开源 AI 论文复现实验与代码解读 · 第五轮第 077 篇
读者:研究生、科研新人和工程型研究者;检索与实验日期:2026-09-18。
摘要
从隐藏层预测某个属性,准确率接近满分,能否说明模型靠它完成任务?本文阅读控制任务论文与官方代码,在冻结的小网络上训练线性探针,并把探针分数与模型行为分开验证。实验目标是复现测量协议和一个可检查的反例:表示中的信息可被读出,并不自动说明当前决策依赖它。本次执行的是本地合成实验,没有复现原论文的语言模型或自然语言榜单成绩。
目录
- 复现价值:把问题拆成两层
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与独立审计
- 失败排查与因果边界
- 后续科研问题
- 总结与参考资料
复现价值:把问题拆成两层
探针是附加在冻结表示上的预测器。冻结表示指主模型参数不随探针训练更新;否则高分可能来自重新训练主模型,而不是测量已有表示。线性探针只允许仿射映射,通常用于询问某个属性是否容易被一个简单读出器利用。
这里有两个问题:外部分类器能否恢复属性,以及原模型是否依赖属性作答。前者是可解码性,后者需要行为或干预证据。探针本身也会学习;数据量、参数量、正则化和划分方式都属于测量条件,不能从标题里“线性”二字推导出结果必然可信。
论文报告:Hewitt 与 Liang 在二〇一九年提出按词类型随机分配标签的控制任务,用来检查探针对词身份的记忆能力。Ravichander、Belinkov 与 Hovy 在二〇二一年的自然语言推断和合成实验中,进一步展示了可解码属性与任务相关性之间的差距。本文借用这些问题意识,另做一个规模很小、数据和参数全部可审计的实验。控制任务论文;任务相关性论文
核心思想与公式
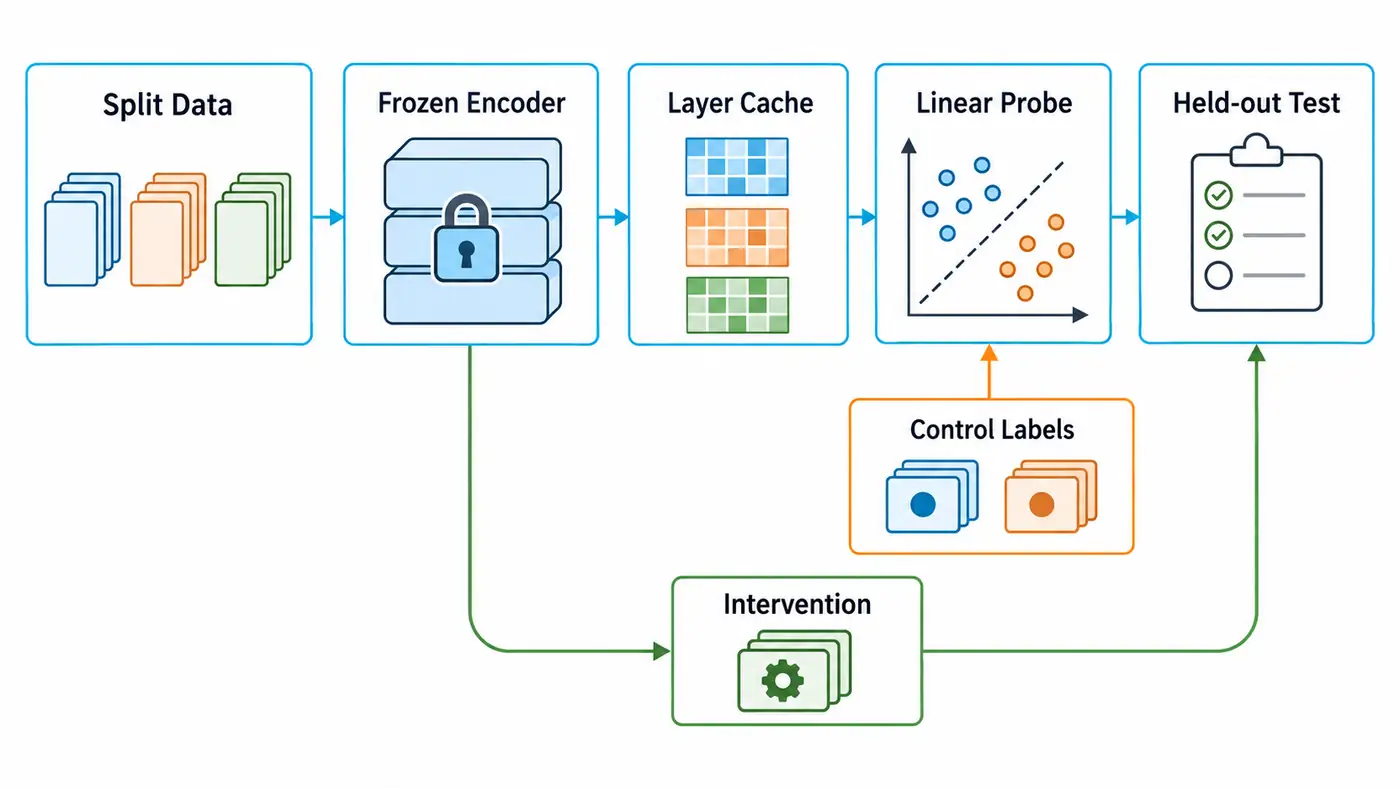
图中主路径提取表示并训练探针,绿色分支单独检查原模型行为。控制标签只改变探针目标,不回传修改编码器。方法图展示协议关系,不是本次实验结果图。
$$ H^{(l)}=f_l(X),\qquad p_i=\sigma(h_i^\top w+b),\qquad \mathcal L=-\frac1N\sum_i[y_i\log p_i+(1-y_i)\log(1-p_i)]+\frac\lambda2|w|_2^2. $$
$X$ 是输入,$H^{(l)}\in\mathbb R^{N\times d_l}$ 是第 $l$ 层缓存,$N$ 为样本数,$d_l$ 为表示宽度。$w$ 是长度为 $d_l$ 的权重,$b$ 是标量偏置,$\sigma$ 为把分数映射到概率的 sigmoid 函数。$y_i$ 是待探测的二元属性,可以不同于主任务答案;$\lambda$ 控制权重惩罚,偏置不惩罚。多类别情形可改用 softmax。
论文中的选择性定义为真实任务准确率减去控制任务准确率。控制标签对同一词类型保持固定,使探针有机会记住词与随机输出的映射。逐条样本独立打乱标签回答的是另一类问题,不能混用该定义。本文的 shuffle 是后者,只检查明显泄漏或偶然关联,不报告论文选择性分数。控制任务定义与选择性
线性失败也不意味着信息消失。例如两个二元变量可以完整保留在输入中,但“是否不同”需要非线性组合。高分支持给定协议下的可读性,低分只说明当前探针、数据和优化预算没有读好。
官方代码阅读路线
先读作者仓库的 README:它把标注语料、磁盘表示、层编号、探针族和训练设置放进配置。迁移真实文本时,应先核对句子索引与词级表示是否一一对应,再比较层;分词后长度对不上时,即使训练能运行也可能学错标签。
然后进入 task.py 的 CorruptedPartOfSpeechLabelTask。prepare 汇总三个分区的词类型频率,_register_type 为词类型生成固定随机标签,labels 执行替换。这里还写死了四十五类的词性分布。它是特定实验的构造,不是可以原封不动套到任意标签空间的通用接口;使用测试词类型统计也必须在复现记录中披露。
再看 probe.py 的 OneWordLinearLabelProbe:两个线性层之间没有非线性激活,因此推理时仍是仿射函数,瓶颈宽度约束有效矩阵的秩。实际输入为批次×词数×表示宽度,输出保留类别轴;注释中简写的输出形状不应替代对返回张量的检查。相邻的神经网络探针加入 ReLU,表达能力随之改变。
以上代码已实际打开并静态阅读,均为主分支,未锁定提交;动态兼容性待人工核验。部分原始文件地址取回失败后改读可访问的官方页面,没有把未读取的训练器写成已核验实现。本篇 NumPy 脚本是独立教学实现,并未运行官方环境。
最小实验与实际结果
主任务是选择器:输入 $a,b,q\in{-1,1}$,当 $q=-1$ 时输出 $a$ 的正负,否则输出 $b$ 的正负。另有两个标准差为 $0.3$ 的高斯噪声坐标,组成五维输入。未选变量是另一项,例如选择 $a$ 时就是 $b$;它不是固定的某一输入列。
沿用第 076 篇已训练的三个小网络,结构为五维输入、两层十六维 tanh、二类输出,共四百零二参数。tanh 是双曲正切非线性函数。检查点已原样复制到本篇,记录文件哈希,运行不依赖其他目录。模型种子为 76、77、78,本次只训练探针。
新数据种子为 770,训练、验证、测试分别五百一十二、二百五十六、五百一十二条。各分区覆盖相同八种核心规则,噪声样本不同;这不是未见组合泛化。输入、第一层、第二层分别产生宽度五、十六、十六的表示,测试缓存形状为 [512,5] 或 [512,16]。
每层分别预测主任务、未选变量和随机标签。均值与标准差只从训练表示估计,再应用于其他分区。四个惩罚系数为零、千分之一、百分之一、十分之一;探针从零初始化,全批次梯度下降固定两千步,以验证集负对数似然选择系数。负对数似然衡量模型给正确标签分配的概率,越低越好;测试集不参与选择。执行命令为:
python3 code/probe_numpy.py
python3 code/audit_results.py
依赖、检查点来源和文件说明见 code/README.md。本次实际使用 Python 3.12.14、NumPy 2.3.5、CPU 双精度。下表为三个主模型种子的测试准确率均值;随机标签为一次固定打乱,没有重复抽取随机标签分布。
| 表示 | 主任务 | 未选变量 | 随机标签 |
|---|---|---|---|
| 原始输入 | 0.7363 | 0.7363 | 0.4902 |
| 第一隐藏层 | 1.0000 | 1.0000 | 0.4668 |
| 第二隐藏层 | 1.0000 | 0.9987 | 0.4609 |
本次实际验证:第二层未选变量准确率的种子标准差为 $0.0023$;原始输入三行实验实际上使用同一表示,其零标准差不代表独立重复的稳定性。第一层两个属性都可完全读出,不能据此宣布主模型同等依赖两者。
翻转每条测试输入的未选变量后,三个模型的答案变化率均为零,主任务准确率仍为一。但最大 logit 变化分别约为 $3.03$、$2.22$、$2.28$。logit 是概率归一化前的分数;答案不变不是整个输出函数不变,更不能直接推出所有内部通路都忽略该变量。
评测协议与独立审计
为了进一步分离读出与行为,在第二隐藏层做一个精确定义的投影。设主模型最后的读出矩阵为 $U\in\mathbb R^{16\times2}$,其列空间的正交基为 $B\in\mathbb R^{16\times r}$,令 $P=BB^\top$,则:
$$ H'=HP,\qquad H'U+c=HU+c. $$
这里 $r=2$,$P$ 为十六阶投影矩阵,$c$ 是原模型偏置。被移除的方向属于输出零空间,即变化不会传到这个线性读出。基由模型权重计算,不使用探针标签;等式只依赖最后一步线性,不能移植到任意中间层后就假定成立。
本次实际验证:投影前后两个 logits 的最大误差低于 $8\times10^{-15}$;原来训练好的未选变量探针,投影后准确率分别为 $0.5000$、$0.5000$、$0.4609$。原模型输出不变,原探针却读不好了。作者推断:原探针依赖了被投影改变的表示方向;这不是已经完全擦除属性信息的证明,因为本次没有在投影后重新训练探针。
所有候选权重、所选权重、归一化统计、逐例分数及干预输出都保存于 code/results/。独立审计不导入训练脚本,以标量循环重算三万四千五百六十个探针预测,复核验证集选参、均值和样本标准差,最大数值差约为 $1.02\times10^{-14}$。六个逻辑回归参数的有限差分梯度检查误差约为 $4.02\times10^{-11}$;冻结权重及投影恒等式检查通过。
复核表格时要同时打开逐例记录。例如第二隐藏层的未选变量并非每个种子都满分,均值中的微小下降来自具体错例,不能四舍五入后抹去。随机标签低于二分之一也不是有意义的反向规律:本次只固定了一次打乱,不能看到测试成绩后再翻转预测或重新挑种子。若要判断控制分数是否异常,应预先增加独立打乱次数并报告分布。
此外,五百一十二条测试数据只有八种核心模式。同一模式下的噪声变体共享决策结构,逐条自助抽样可能让不确定性看起来过小。确认性实验应以规则或模板为单位留出,明确说明哪些变化来自主模型初始化,哪些来自数据采样。
失败排查与因果边界
高分异常时先查标签有没有混进输入、近重复是否跨分区、标准化是否偷看测试集。低分则先查标签与表示顺序、类别平衡、训练损失和优化预算。本次保存最终梯度范数,固定步数不等于所有目标都已达到严格最优,尤其无惩罚且线性可分时不能宣称得到有限最优权重。
比较层时还要控制表示宽度和参数量。本例输入探针有六个参数,隐藏层探针有十七个;因此原始输入与隐藏层的差距不能全部归因于层的位置。没有加入随机初始化编码器对照,也不能据此量化主任务训练贡献了多少信息。
真实文本应按文档、实体或模板做分组划分,记录子词聚合方式,并同时报告多数类、词身份等基线。本例只检验八种规则内的新噪声,不能替代自然语言泛化评估。三个模型种子的标准差也不是覆盖数据变化的置信区间。语言模型、官方语料和分组迁移均未运行,待人工核验。
后续科研问题
第一,固定表示,增加训练样本并改变惩罚强度,层间排名是否稳定?应预先固定搜索预算,同时画真实标签和控制标签的学习曲线,避免只报告最好看的单点。
第二,投影后重新训练探针,还能恢复多少属性?若新探针仍成功,应区分原读出器失效与信息不可恢复,再引入不同探针族验证。
第三,在未见规则或新文本模板上,探针发现能否预测干预效果?先用发现集提出属性与层的假设,再冻结方案到独立确认集检验,保留答案不变但分数移动的失败边界。
总结
探针测量的是给定数据、表示和训练预算下的可解码性。本文跑通线性读出、随机标签检查、反事实输入和输出保持投影,展示了把高分写成因果结论时缺少的证据。读者下一步应先补充分组泛化与投影后重训,再讨论模型是否真正使用某项信息。
参考资料
以下一手来源均于 2026-09-18 实际打开;论文使用会议定稿,仓库使用检索当日主分支。
- John Hewitt、Percy Liang. Designing and Interpreting Probes with Control Tasks. EMNLP-IJCNLP 2019;全文。
- Abhilasha Ravichander、Yonatan Belinkov、Eduard Hovy. Probing the Probing Paradigm: Does Probing Accuracy Entail Task Relevance?. EACL 2021;全文。
- Hewitt 与 Liang 官方实现:仓库与配置说明、任务构造、探针实现。