- 日期:2026-09-23
- 适合读者:研究生、科研新人和工程型研究者
- 复现范围:整理 052–080 的证据索引,封装并重放 080 的报告实验;不重新训练模型。
摘要
一个月后,最容易丢失的往往不是代码,而是“这个数字究竟由哪次实验得到”。本轮从注意力、检索和训练方法走到解释性、校准与结果报告,最后需要留下能够再次运行、检查和质疑的研究资产。本文的目标很具体:把一份已有实验整理成自包含的小包,在两个空工作目录中重算报告,并主动修改代码、输入和环境记录,检查流程能否发现变化。成功标准是证据链清楚,而不是文件夹整齐。
目录
- 复现价值与本轮收获
- 核心思想与校验公式
- 官方代码阅读路线
- 最小实验与代码库结构
- 评测协议与实际结果
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
一、复现价值与本轮收获
论文报告。 Pineau 等人在 JMLR 2021 总结了 NeurIPS 2019 的可复现性计划,包括代码提交、社区复现挑战和论文检查表。论文讨论的障碍不仅是代码缺失,还包括数据差异、训练说明不足、指标不明确、选择性报告和结论超出证据。[1] 因此,“仓库能启动”只是研究可检查性的一个条件。
本次实际验证。 扫描目录中的三位编号,052–080 共二十九篇,均保留通过记录。本次重新检查其元数据、中文字数、本地链接、图片文件与四十七个 Python 源文件的语法;历史运行和视觉验收记录予以保留,没有把全部模型重新跑一遍。完整导航见 研究代码库索引。
从这些文章可以提炼三类可复用资产。第一类是概念到实现的对应关系,例如注意力公式对应哪些张量变换;第二类是实验协议,例如检索候选、数据划分与拒答阈值如何确定;第三类是反证工具,例如消融、输入扰动和独立计数审计。代码库应保存三者之间的关系,而不只是收集训练脚本。
本轮的教学实验也有共同边界:小规模合成数据能帮助暴露接口和指标错误,却不能替代真实数据、官方模型及原论文预算下的复现。月度整理时,应优先把这些未验证项变成下一轮实验,而不是把文章状态“通过”解释成科学结论已经普遍成立。
二、核心思想与校验公式
本文把“实验包”定义为代码、配置、输入、环境记录和预期输出的集合。清单,即 manifest,是这些对象的目录与内容指纹;SHA-256 是把文件字节映射成固定长度摘要的算法,用来发现内容是否变化。
M={(pi,hi)}i=1K,hi=SHA256(bytes(pi)).
这里 (p_i) 是包内相对路径,(h_i) 是保存的摘要,(K=5) 是本例载荷文件数。校验既比较摘要,也比较文件集合,因而缺失和意外新增文件都会被发现。哈希只说明字节是否与基线一致,不能证明标签正确,更不能证明作者诚实。
OA=F(C,D,θ,E,s),OB=F(C,D,θ,E,s).
(C) 是报告代码,(D) 是保存的实验摘要,(\theta) 是统计协议,(E) 是运行环境,(s) 是随机种子;(O_A,O_B) 是两个工作目录生成的结果。此处比较五个确定性输出的字节摘要,同时要求它们匹配事先从 080 保存的基线,而不是只检查两个新运行彼此相同。
输入分数的逻辑形状是 [3,5,4]:三个旧模型运行、五个扰动预算、四种攻击。它不是新训练的张量,也不是六十个独立种子。两个报告重放不增加模型实验的样本量,不能让原有误差线自动变窄。
三、官方代码阅读路线
先读 PyTorch 的 Reproducibility 文档:相同种子并不保证不同版本、平台或 CPU/GPU 之间结果完全一致。[2] 阅读时分别标记随机数来源、算子确定性和运行环境,避免把所有变化都归因于种子。
接着打开官方 torch/random.py。[3] 本次看到 manual_seed 委托给内部实现,后者为可用设备设置种子,并调用默认生成器;get_rng_state 返回的是 CPU 默认生成器状态。由此可以提出代码阅读问题:断点恢复保存了哪些生成器状态,数据加载顺序是否也恢复?记录一个整数种子并不能自动回答这些问题。
最后读 DVC 的阶段和锁文件说明。[4] cmd 描述执行命令,deps 描述输入依赖,outs 描述输出;dvc.lock 记录阶段状态与内容摘要。把脚本读取的外部文件漏在依赖列表之外,会让“输入没有变化”的判断失去依据。本文借用这种显式依赖思路,使用标准库实现一个更小的固定流程。
本次实际打开的是 PyTorch 文档显示的 2.14 页面和检索日 main 源码,二者不应被假定为同一提交;源码尚未固定 commit。DVC 也只进行了文档阅读。相关框架运行、版本兼容性与断点恢复实验均待人工核验。
四、最小实验与代码库结构
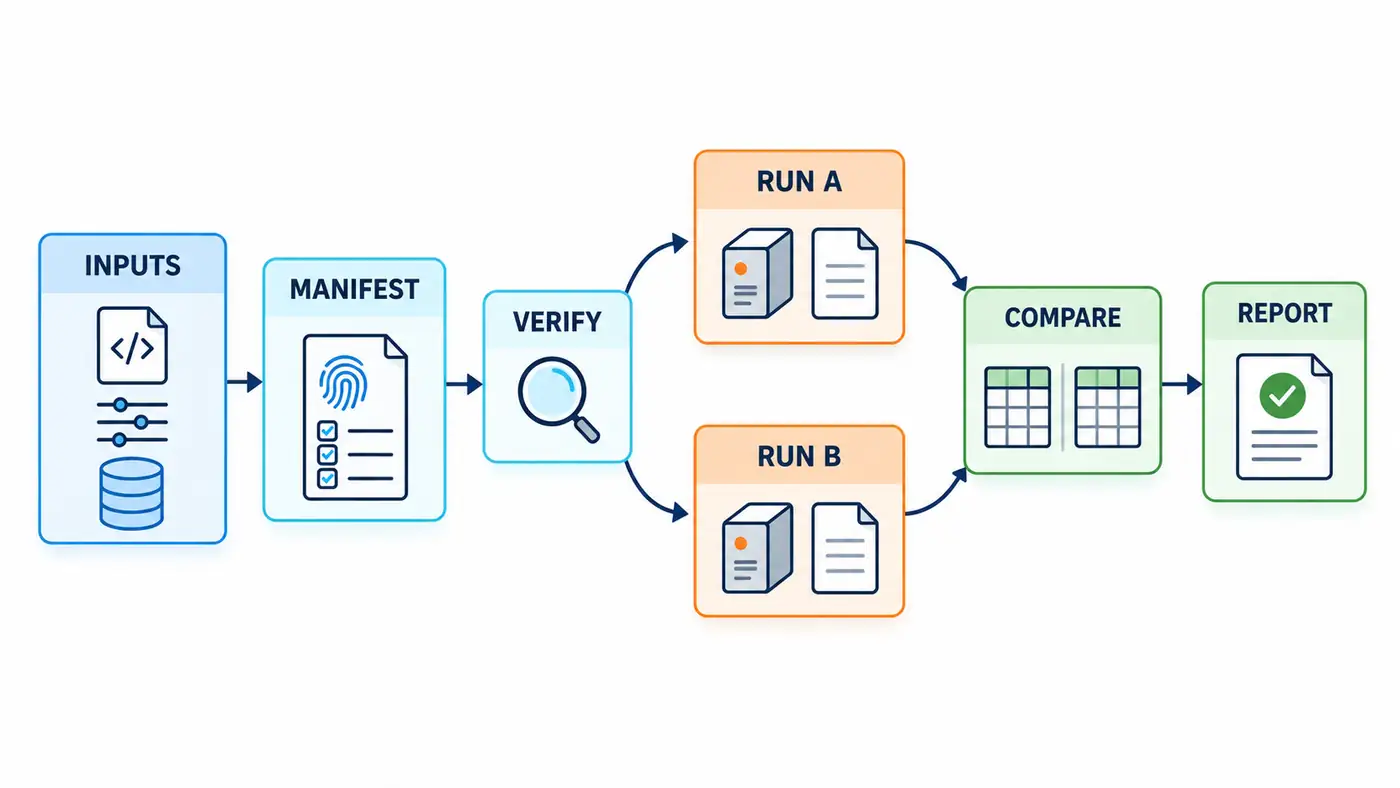
图中先校验输入,再分到两个工作目录,最后比较结果;分叉表示两份独立目录,代码按顺序执行。它不表示两台机器、容器隔离或并行加速。
从本篇目录执行,输出目录应为尚不存在的新路径:
python3 code/replay.py --out code/my_replay
PYTHONPYCACHEPREFIX=/tmp/081-pycache python3 -m py_compile code/replay.py code/capsule/report.py code/capsule/audit.py
仅需 Python 标准库,实际基线为 CPython 3.9.6。入口会核对解释器版本与实现;更换版本时应建立另一个经过审查的基线,而不是删除检查后仍声称相同环境。依赖和完整命令见 代码说明。
capsule/ 原样保存 080 的报告器、独立审计器,以及三个输入文件。capsule_manifest.json 保存这些文件的摘要、来源、随机种子和预期输出摘要。运行器使用当前解释器创建子进程,保留每条命令的标准输出、错误输出和结果;旧输出目录已存在时拒绝覆盖。
报告器内部的蒙特卡洛抽样固定种子为 80,运行器另将 Python 哈希种子设为 81。这里没有新增训练、数据抽样或模型下载。独立审计器不导入报告器函数,而是从整数失败计数和分数运算重新核对统计结果;它可以发现部分实现错误,但仍共享同一批上游资料。
个人库的公共层只负责运行身份、证据路径和验证结果,具体指标留在各实验中。比如检索召回率、拒答覆盖率和攻击成功率即使都是小数,也不能用一个含义模糊的 score 字段混合比较。附带的 研究卡模板 要求写清分母、方向、划分和结论范围。
五、评测协议与实际结果
本次检验的是保存摘要的可重放性。开始执行前,五个载荷摘要与五个确定性输出摘要均取自已有 080 文件。每份工作目录从载荷复制开始,没有预放结果;随后执行报告器和审计器,再与基线比较。
本次实际验证。 两个工作目录均成功处理六十条条件日志和二十个统计组;五个确定性输出分别是报告 JSON、穷举重采样列表、CSV 表、Markdown 表与审计 JSON。它们在两次重放之间、以及与 080 基线之间均字节一致。详细记录见 重放验收日志。
| 检查对象 |
判定规则 |
实际结果 |
| 输入与代码 |
文件集合及摘要一致 |
五个载荷通过 |
| 报告重算 |
两个新目录分别匹配旧基线 |
每次五个输出通过 |
| 计数与统计 |
独立审计重新计算 |
两次均通过 |
| 漂移样例 |
明确拒绝变化 |
七类均被发现 |
七类样例分别改变代码、配置、数据、文件缺失、额外文件、解释器版本记录和输出表。故障只注入临时副本,不修改原始实验。前三类通过追加字节模拟文件漂移,证明的是完整性检查会生效,不是所有语义错误都会被检测。
耗时日志整份保留,但不要求字节一致,因为真实运行时间会变化;其记录数、分数形状与 Python 版本仍被检查。这一排除规则在清单中事先写明,不能在看到差异后任意删除不喜欢的字段。
六、失败排查与证据边界
第一类失败是输入身份不明。文件名相同不代表内容相同,配置漏记默认值也会使两个“同名实验”实质不同。应先查载荷摘要和配置,再查结果,而不是直接调整容差让比较通过。若清单与文件同时被修改,本例不会认证其真实性;正式归档需要独立版本记录。
第二类失败是隐藏依赖。脚本从个人目录读取缓存、依赖当前工作路径,或复用旧结果,都可能产生虚假的重放成功。本例使用相对包路径并在新目录执行,但没有实施文件访问追踪或网络沙箱,因此不能声称证明了所有外部依赖都不存在。
第三类失败是同错一致。两次运行共享同一错误公式,仍会生成相同表格。因此需要原始计数、独立实现和人工语义检查。上游若存在标签错误或测试污染,本次摘要审计不能修复;它也没有重新核验逐样本预测和模型权重。
第四类失败是统计对象被替换。重放同一结果不是新的随机重复;跨设备差异也不等于方法效果差异。当前结论严格限于这台机器、这个解释器和这份载荷。跨操作系统、依赖升级、真实 GPU 训练、官方 benchmark 与区间覆盖率均未运行,待人工核验。
语法检查和 CPU smoke test 已通过。现有结果目录拒绝覆盖,便于保留失败证据;前置校验失败会直接打印错误,执行阶段失败则在新目录写入未完成状态。不要把失败记录清空后只留下最终成功运行。
七、后续科研问题
作者推断。 下一轮最有价值的问题,是这种记录方式能否帮助第三方定位复现差异。可以固定数据和代码,逐项改变解释器、数值库和硬件,预先定义预测误差容差,再比较变化发生在哪个阶段。当前的字节相等标准适合小型报告流程,不能未经论证就用于所有浮点训练结果。
还可以研究最小证据保存量:只有汇总指标、保存逐样本预测、再增加中间激活,分别能发现哪些故障?应先列出待检测的错误,再比较存储成本与检出能力。保存更多文件本身不保证更可靠,关键是能否反驳具体的错误解释。
对研究生而言,可以从索引中选一篇仍缺真实数据验证的实验,固定官方提交,补一组强基线与失败分析,形成新的研究卡。对初学者,先尝试改坏一个输入再观察错误信息,往往比同时安装许多实验管理工具更容易理解证据链。
八、总结
个人研究代码库应让每条结论都能回到来源、协议、输入和运行记录。本次留下二十九篇既有实验的导航,以及一个经过双目录重放和故障检查的小包。它证明了有限范围内的流程可检查性;后续科研的任务,是继续检验这些教学实验尚未覆盖的假设。
参考资料
检索日期:2026-09-23。以下一手页面与源码均已实际打开。在线文档与分支内容可能变化,未运行的版本兼容性待人工核验。
- Joelle Pineau, Philippe Vincent-Lamarre, Koustuv Sinha, Vincent Lariviere, Alina Beygelzimer, Florence d'Alche-Buc, Emily Fox, Hugo Larochelle. Improving Reproducibility in Machine Learning Research (A Report from the NeurIPS 2019 Reproducibility Program). JMLR 22(164):1–20, 2021:论文页面、正式 PDF。
- PyTorch Contributors. Reproducibility,页面显示 2.14;本次未安装或执行该框架版本。
- PyTorch Contributors. 官方 torch/random.py,检索日 main,未固定提交;用于阅读种子和生成器状态路径。
- DVC Contributors. dvc.yaml Files:Stages 与 dvc.lock,在线文档检索日版本;本次未执行 DVC。
Companion Code
配套示例代码
与正文对应的教学示例。请先阅读运行说明,下载所需文件并保留目录结构;也可以展开源码对照阅读。
下载教学源码包(ZIP) ↓
包含脚本、配置、必要输入和许可说明;不包含模型权重、运行环境及完整历史运行记录。解压后先阅读 code/README.md,按说明准备公开数据并生成自己的实验结果。
展开查看完整源码replay.py · 152 行
"""Portable saved-summary capsule: integrity, two clean replays, fault injection.

Standard library only. This is a trusted-local reproducibility check, not a
sandbox for arbitrary code or a signed provenance/authenticity system.
"""
import argparse
import copy
import hashlib
import json
import os
import platform
import shutil
import subprocess
import sys
import tempfile
from pathlib import Path

ROOT = Path(__file__).resolve().parent


def digest(path):
    return hashlib.sha256(path.read_bytes()).hexdigest()


def verify_payload(root, manifest):
    actual = {p.relative_to(root).as_posix() for p in root.rglob('*') if p.is_file()}
    if actual != set(manifest['payload']):
        raise ValueError('payload file set changed')
    for name, expected in manifest['payload'].items():
        p = root / name
        if p.is_symlink() or not p.resolve().is_relative_to(root.resolve()):
            raise ValueError('nonlocal payload path')
        if digest(p) != expected:
            raise ValueError('payload hash changed: ' + name)


def verify_environment(manifest):
    if (platform.python_version() != manifest['python'] or
            platform.python_implementation() != manifest['implementation']):
        raise ValueError('Python runtime differs from recorded baseline')


def verify_outputs(root, manifest):
    for name, expected in manifest['expected_outputs'].items():
        if not (root / name).is_file() or digest(root / name) != expected:
            raise ValueError('output differs from frozen baseline: ' + name)
    log = json.loads((root / 'verification.json').read_text())
    if log['rows'] != 60 or log['score_shape'] != [3, 5, 4]:
        raise ValueError('unexpected replay scope')
    if log['python'] != manifest['python']:
        raise ValueError('subprocess Python differs')
    return {name: digest(root / name) for name in manifest['expected_outputs']}


def fault_checks(payload, manifest, good_outputs):
    rejected = {}
    mutations = {
        'code_change': 'report.py',
        'config_change': 'input/manifest.json',
        'data_change': 'input/runs.jsonl',
        'missing_input': 'input/source_summary.json',
        'extra_file': 'unexpected.json',
    }
    for label, name in mutations.items():
        with tempfile.TemporaryDirectory(prefix='research-fault-') as td:
            target = Path(td) / 'capsule'
            shutil.copytree(payload, target)
            path = target / name
            if label == 'missing_input':
                path.unlink()
            else:
                with path.open('ab') as f:
                    f.write(b'\n# deliberate drift\n')
            try:
                verify_payload(target, manifest)
            except ValueError as exc:
                rejected[label] = str(exc)
            else:
                raise RuntimeError('undetected fault: ' + label)
    altered = copy.deepcopy(manifest)
    altered['python'] = '0.0.0'
    try:
        verify_environment(altered)
    except ValueError as exc:
        rejected['runtime_change'] = str(exc)
    else:
        raise RuntimeError('undetected runtime drift')
    with tempfile.TemporaryDirectory(prefix='research-output-fault-') as td:
        target = Path(td) / 'results'
        shutil.copytree(good_outputs, target)
        with (target / 'table.csv').open('ab') as f:
            f.write(b'corrupted result\n')
        try:
            verify_outputs(target, manifest)
        except ValueError as exc:
            rejected['output_change'] = str(exc)
        else:
            raise RuntimeError('undetected output drift')
    return rejected


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--out', type=Path, required=True,
                        help='New output directory; existing paths are refused')
    args = parser.parse_args()
    manifest = json.loads((ROOT / 'capsule_manifest.json').read_text())
    payload = ROOT / 'capsule'
    verify_environment(manifest)
    verify_payload(payload, manifest)
    out = args.out.resolve()
    out.mkdir(parents=True, exist_ok=False)
    report = {'status': 'incomplete', 'python': platform.python_version(),
              'platform': platform.platform(), 'machine': platform.machine(),
              'scope': manifest['scope'], 'runs': [],
              'manifest_sha256': digest(ROOT / 'capsule_manifest.json')}
    env = os.environ.copy()
    env['PYTHONDONTWRITEBYTECODE'] = '1'
    env['PYTHONHASHSEED'] = '81'
    env.pop('PYTHONOPTIMIZE', None)  # Copied audit deliberately uses assertions.
    try:
        for label in ('run_a', 'run_b'):
            work = out / label
            shutil.copytree(payload, work)
            verify_payload(work, manifest)
            for script in ('report.py', 'audit.py'):
                completed = subprocess.run([sys.executable, '-B', script], cwd=work,
                                           env=env, capture_output=True, text=True,
                                           timeout=60)
                (work / (script + '.stdout.txt')).write_text(completed.stdout)
                (work / (script + '.stderr.txt')).write_text(completed.stderr)
                if completed.returncode:
                    raise RuntimeError(script + ' failed with ' + str(completed.returncode))
            hashes = verify_outputs(work / 'results', manifest)
            report['runs'].append({'name': label, 'output_sha256': hashes})
        if report['runs'][0]['output_sha256'] != report['runs'][1]['output_sha256']:
            raise RuntimeError('two replays disagree')
        report['rejected_faults'] = fault_checks(payload, manifest, out / 'run_a/results')
        report['status'] = 'passed'
        report['checkpoints'] = {'payload_files': 5, 'score_shape': [3, 5, 4],
                                 'rows_per_run': 60, 'groups_per_run': 20,
                                 'stable_outputs_per_run': 5, 'clean_runs': 2}
    except Exception as exc:
        report['error'] = repr(exc)
        raise
    finally:
        (out / 'replay_audit.json').write_text(json.dumps(report, indent=2) + '\n')
        print(json.dumps(report, indent=2))


if __name__ == '__main__':
    main()