开源 AI 论文复现实验与代码解读 · 第五轮 / 074
面向研究生、科研新人和工程型研究者;检索与实验日期:2026-09-15。
摘要
世界模型的预测视频看起来合理,不代表它在相同动作下预测了正确未来。本文把问题缩小到一个受控振荡系统:从轨迹学习下一状态,再连续预测四十步,比较真实状态输入、预测状态回灌和定期观测校正。本次实际运行三个数据种子、九个小模型,保存全部权重与预测,并独立复算。目标是理解序列预测和评测机制;没有复现赛车、Minecraft 或论文控制成绩。
目录
- 复现价值:把“像真的”换成可检验目标
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与独立审计
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
复现价值:把“像真的”换成可检验目标
世界模型学习环境如何随动作变化。这里的 rollout 指从一个起点连续展开未来状态:第二步开始,输入来自模型上一轮预测。与每一步都获得真实状态的单步评测相比,它更容易暴露累积偏差。好处是无需完整训练智能体,就能先检查动力学部分是否可信。
论文报告:Ha 与 Schmidhuber 的 World Models 将视觉压缩、时间记忆和控制器分开;记忆模块预测给定动作与历史信息后的下一潜变量分布。潜变量是压缩观测的数值表示,不等于真实物理状态。原方法使用混合密度循环网络表达多种可能未来,本文的确定性回归只保留动作条件预测这一接口。作者交互论文
DreamerV3 则在学到的潜在动力学中展开想象轨迹,用预测的奖励等信号学习行为。本文阅读的是二〇二四年修订的预印本第二版,题名仍为 Mastering Diverse Domains through World Models;不把后来期刊版本的内容混入本次证据。版本页;全文
本次提出三个可分辨的问题:只看当前位置会丢失什么?线性近似离开训练范围后怎样失效?每隔几步读一次真实状态能缓解多少误差?三个问题分别改变状态信息、函数形式和观测预算,不能合并成一个“模型更强”的结论。
核心思想与公式
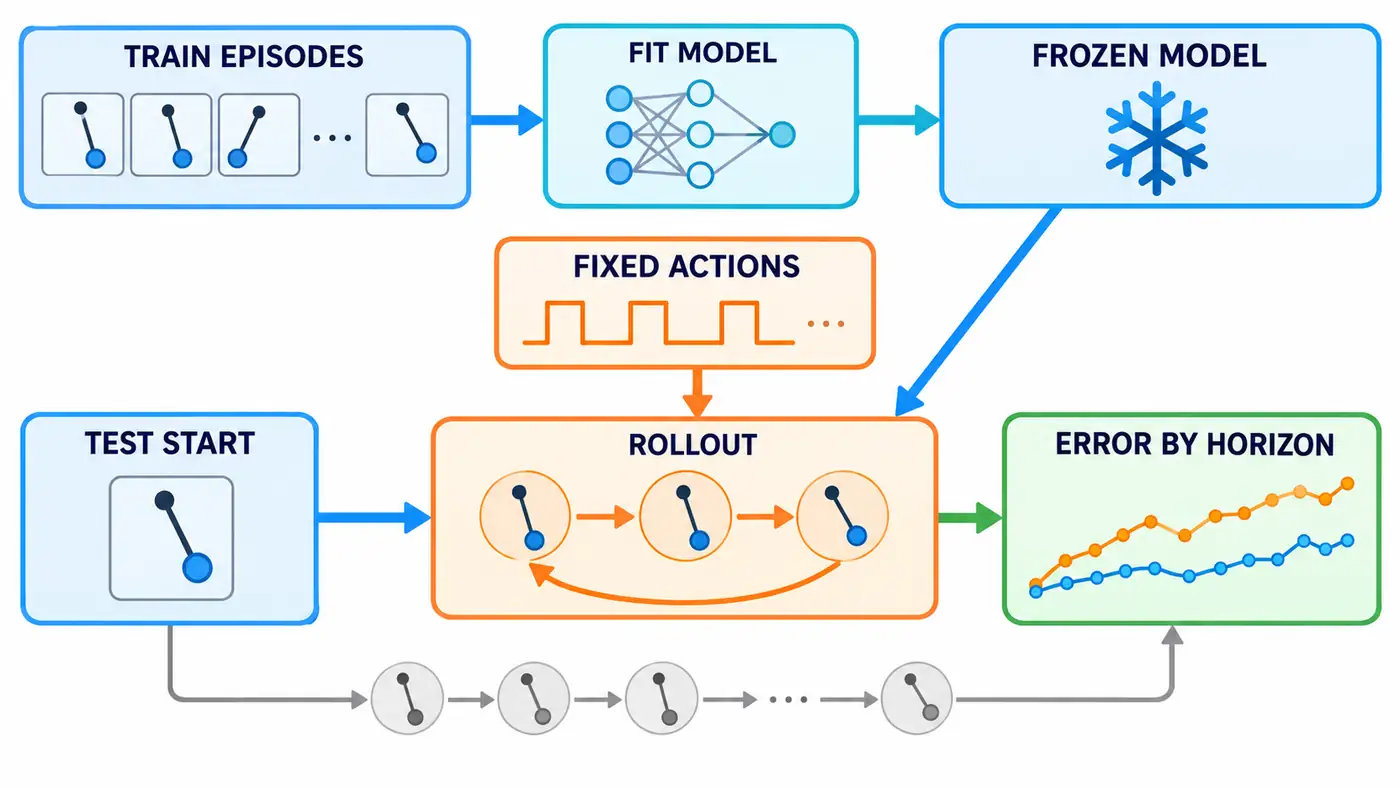
方法图上方表示训练后冻结模型,下方表示测试。灰色支路代表在同一动作序列下预先记录的真值,只进入评分器;图内曲线与摆动图标都是概念示意,不是实测曲线。实际学习器是小型回归器,并非图标暗示的神经网络。
构造无噪声离散系统:
$$ v_{t+1}=0.98v_t-0.1\sin(x_t)+0.08a_t,\qquad x_{t+1}=x_t+0.1v_{t+1}. $$
$x_t$ 为无量纲位置坐标,$v_t$ 为速度变量,$a_t$ 从负半、零、正半三个值中采样。状态 $s_t=(x_t,v_t)$ 是二维向量,动作是一维标量。它是带阻尼和外力的教学振荡器,未校准真实装置;封面也不是测量照片。先更新速度、再更新位置,交换顺序会得到不同轨迹。
三个学习器均使用最小二乘:
$$ \hat s_{t+1}=\phi(s_t,a_t)W,\qquad W^*=\arg\min_W|\Phi W-Y|_F^2. $$
$\phi$ 是行特征向量,$\Phi$ 堆叠训练转移,$Y$ 保存对应下一状态,$W$ 是待学习系数;平方范数求和两个输出的残差。完整线性模型的特征为位置、速度、动作和常数,训练矩阵形状为 $[5120,4]$,目标为 $[5120,2]$,权重为 $[4,2]$。
位置模型移除速度,仍预测两个输出,共六个参数,但下一步不使用预测速度。结构特征模型在完整线性特征后加入正弦项,共十个参数,恰好覆盖真实方程的函数形式。这是已知结构的诊断参照,不能当作从数据自动发现物理规律。
训练时,每个转移的输入都是真值,这对应 teacher forcing,即用真实前一步作为预测条件。开放展开则令 $\hat s_{t+1}=f(\hat s_t,a_t)$,只在起点设置 $\hat s_0=s_0$。后续真实状态可用于算误差,却不能进入预测器;动作也必须与生成真值时一致。
官方代码阅读路线
先读原仓库的 rnn_train.py。定位 random_batch,它从编码均值与方差采样潜变量;随后输入拼接当前潜变量和动作,输出取潜变量序列向后错一位的切片。先画出这一对齐关系,再看优化器,能尽早发现把动作错配到下一帧的问题。
然后读 rnn.py:输入宽度三十五来自三十二维潜变量与三个动作通道;混合头输出权重、均值与对数标准差,通过对数求和计算负对数似然。再沿 sample_sequence 看生成值怎样写回 prev_x、循环状态怎样更新。源码使用旧 TensorFlow 接口,本次只阅读,运行兼容性待人工核验。
在 DreamerV3 的 rssm.py 中,RSSM 是循环状态空间模型。比较 observe 与 imagine:前者融合观测编码,后者由内部状态和动作产生先验,并采样下一随机状态。两者都推进状态,差别在于是否收到观测证据。
最后读 agent.py 的 report。开放预测报告先观察序列前半段,再用后半段动作展开,解码后拼接真实、预测与误差画面。这里的预测是给定动作的条件预测。源码中的 prevact 采用到达当前观测的动作口径,移植时要检查时间索引,不能直接套用本文 $a_t$ 的命名。
上述分支是检索日的 master 或 main,未固定提交哈希,不保证与论文版本逐行对应。本次 NumPy 脚本独立实现教学系统,没有运行官方编码器、随机潜状态、奖励头或策略训练。
最小实验与实际结果
在文章目录运行,依赖与完整说明见 README:
python3 -m pip install -r code/requirements.txt
python3 code/world_model.py
python3 code/audit_results.py
实际环境为 Python 3.12.14、NumPy 2.3.5、CPU 双精度。三个种子分别生成训练一百二十八条、开发三十二条、同分布测试六十四条与分布外测试六十四条轨迹,每条四十次转移。种子控制数据采样,最小二乘没有随机初始化;开发集仅记录指标,没有据此调参或选择模型。
训练、开发与同分布测试的初始位置在正负零点五之间;分布外测试改为一点五至二点五。初速度都在正负零点三之间,动作规则不变。这里“同分布”描述初始条件与采集规则,不保证预测状态一直落在训练轨迹覆盖区间。
下表为三个种子的均值,全部使用位置均方误差,逐种子结果与样本标准差在 完整汇总。单步列平均全部四十个真实输入时刻,后三列是从共同起点自由展开的指定步长,两者采样口径不同。
| 模型与测试条件 | 单步误差 | 第十步误差 | 第二十步误差 | 第四十步误差 |
|---|---|---|---|---|
| 仅位置,同分布 | 4.28e-4 | 0.0255 | 0.1112 | 0.1024 |
| 完整线性,同分布 | 9.31e-10 | 1.68e-6 | 6.32e-6 | 1.63e-5 |
| 完整线性,分布外 | 3.08e-5 | 0.2440 | 1.0553 | 0.0821 |
| 正弦结构,分布外 | <1e-20 | <1e-20 | <1e-20 | <1e-20 |
本次实际验证:完整线性模型在训练附近较准确,但分布外第二十步已有显著偏差;第四十步又降低,提醒我们振荡轨迹可能重新接近,终点误差不能代表整个过程。仅位置模型在同分布测试也失效,说明预测条件缺失与分布变化是不同问题。
结构模型的误差接近浮点舍入水平,因为特征覆盖无噪声生成方程;独立检查也确认学到的系数与方程一致。这种结果只证明数据、求解与展开能对齐,不是世界模型已经解决泛化问题。
额外诊断每五步把输入重置为真实状态。完整线性模型在分布外的全程位置误差从 0.46198 降至 0.002255。重置发生在预测下一步之前,评分仍保留之前的错误输出,没有把评分点强行改成真值。它增加了真实观测预算,不是模型重新训练后的提升。运行记录
评测协议与独立审计
按完整轨迹划分数据,禁止把同一回合的相邻窗口随机分到训练与测试。所有模型共享同一种子下的初态和动作,权重只由训练转移求解;参数数目不同,因此位置消融也不是等参数对照。报告位置与速度的逐步误差,正文只选位置用于清晰比较,不能将两种单位任意混合后排名。
正式指标定义为
$$ E_x(h)=\frac1N\sum_{i=1}^{N}(\hat x_{i,h}-x_{i,h})^2. $$
$N$ 是该测试条件的轨迹数,$h$ 是从起点算起的预测步数,$\hat x$ 与 $x$ 使用相同动作序列。全程误差再对四十个步长求平均;它不是第四十步误差。三个数据种子的标准差反映这组采样变化,不是置信区间,也不能把一条轨迹中的时刻视为独立样本。
独立审计 不导入训练脚本,用标量运算重演三万四千五百六十次真实转移、十七万二千八百个预测状态,复算四千五百一十二个指标值;最大预测差约为 4.0e-15。还检查初态唯一、结构系数、训练矩阵满秩与最小二乘残差条件。审计输出
防止真值泄漏的检查尤其直接:把测试轨迹除起点外的状态全部替换成无意义数值,开放预测必须完全不变;第一步开放预测也必须等于相同起点的单步预测。两项均通过。保存的数组足以让读者重算表格,而无需相信正文描述。
失败排查与证据边界
先检查状态是否足够。位置为零、动作为零时,速度分别为正负零点三,下一位置相差 0.0588。位置模型看见完全相同输入,却需要给出两个答案;增加同类样本不能消除这个信息缺口。引入历史位置或速度估计才是对应修复方向。
再检查函数形式与范围。作者推断:训练附近正弦函数近似线性,能够解释完整线性模型的小单步误差;较大初始位置暴露这种近似的偏差,反复回灌又改变后续输入。结构参照支持这个解释,但本实验没有把局部近似误差、状态偏移与每一步放大效应逐项分解。
也不要把“误差累积”误读为必然指数爆炸。本次系统有阻尼,误差可起伏;没有推导统一增长率。若画图,应展示全程、明确纵轴,不能用两张最好看的末帧替代逐步统计。
本实验没有感知噪声、不可预测事件、动作策略变化或学习控制器。每五步读取完整真状态比真实传感器校正更理想;确定性均方误差也不能衡量随机预测分布是否校准。真实图像、官方训练、多步学习目标和控制回报实验均未运行,待人工核验。
后续科研问题
第一,给位置模型增加两帧历史,能否恢复速度信息?固定观测预算,比较历史差分与学习隐状态,并加入测量噪声,检验收益是否依赖精确坐标。
第二,用多步损失训练是否改善长程预测?预先确定训练步长与开发选择规则,在新测试集上同时报告单步和长程误差,避免牺牲局部精度后只展示有利指标。
第三,有限观测预算下应该何时校正?比较固定间隔和不确定性触发,固定读取次数,再检查误差峰值。若进一步学习策略,必须在真实模拟器验证回报,防止策略利用模型错误获取虚假奖励。
总结
最小世界模型实验的关键,是明确预测器每一步能读取什么,并把误差放回时间轴。先分清状态缺失、近似偏差和观测校正的代价,再讨论更复杂的潜变量与控制学习,论文复现才有可以逐步扩展的基础。
参考资料
以下一手链接于 2026-09-15 实际检索并打开;在线源码未固定提交,未来兼容性待人工核验。
- David Ha、Jürgen Schmidhuber,2018,World Models,arXiv v1。版本页;作者交互论文。交互页持续维护,不视为 v1 的逐字快照。
- 作者官方实验代码,WorldModelsExperiments,检索日 master。训练切片;混合密度网络与采样。
- Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap,2023,Mastering Diverse Domains through World Models,2024 修订 v2。版本页;全文。
- DreamerV3 官方代码,检索日 main。循环状态空间模型;训练与开放预测报告。