开源 AI 论文复现实验与代码解读 · 第五轮 / 072
面向研究生、科研新人和工程型研究者;检索与实验日期:2026-09-13。
摘要
视觉语言模型答错一道图表题,原因可能是小字没读清、颜色对应错、减法变加法,也可能是答案格式不合评分规则。反过来,分数很高也未必代表数值准确。本文围绕一个复现目标展开:先用已知错误校准评测协议,再设计能够区分感知与推理的实验。本次在 CPU 上运行合成答案测试和官方评分函数,验证了相对误差分母、字符串长度及阈值边界的实际影响;没有运行图像识别或大模型推理。
目录
- 复现价值:先确定测量对象
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议与数据构造
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
复现价值:先确定测量对象
VLM 指同时处理视觉和语言输入的模型;OCR 是把图中的字符识别为文本。OCR 正确不保证回答正确,因为问题还可能要求匹配图例、读取单位或跨柱比较。把所有错误称为“幻觉”,会丢掉决定下一步实验的信息。
论文报告:Masry 等人的 ChartQA 发表于 Findings of ACL 2022,任务包含视觉指代和逻辑运算,模型结合图像特征与图表数据。Mathew、Karatzas、Jawahar 的 DocVQA 首次发表于二〇二〇年预印本,第三版对应 WACV 2021,强调文档图像上的问答与结构理解。两者说明,复制文本与理解图表关系应分开观察。ChartQA 出版页;DocVQA 第三版记录
本次复现的是测量环节:同一个输出经过不同实现是否仍获相同判定。先把评分器当成待检验程序,才能解释后续模型提升;这里既不复现原论文训练,也不转述未经重跑的性能数字。
核心思想与公式
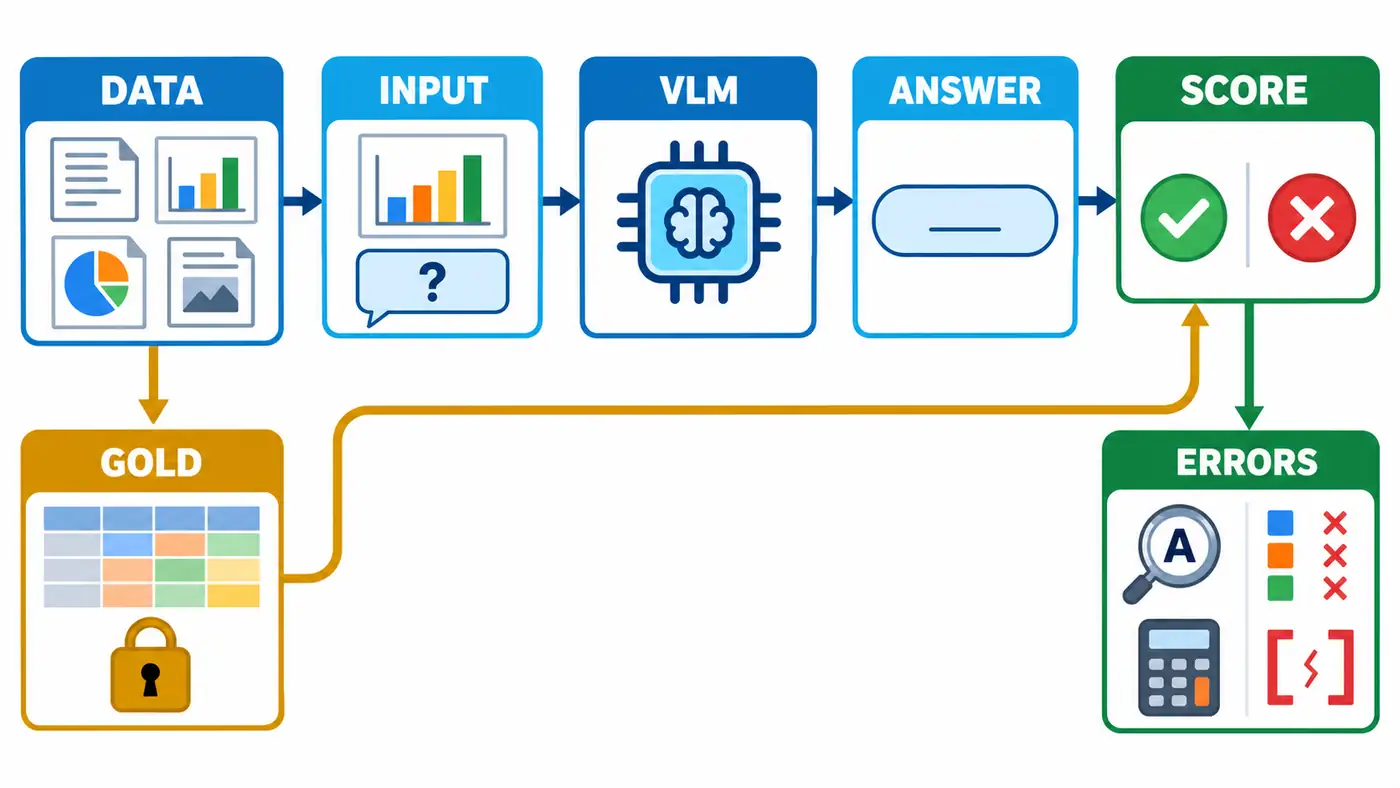
图示是后续完整实验的设计。模型只能收到图片与问题;标准答案另走评分支路。本次代码只执行答案、标准答案和评分之间的计算,图中的模型节点尚未运行。
数值宽松准确率允许一定误差。对非零标准值可写为
$$
R(g,p)=\mathbf{1}\left[\frac{|p-g|}{|g|}\leq0.05\right].
$$
其中 $g$ 是标准数值,$p$ 是预测数值,输出是零或一。ChartQA 论文第五节允许数值答案相差百分之五,非数值答案要求精确匹配。该指标容忍读数偏差,不能证明每个数字都对;零值怎样处理还需要实现约定。原论文第五节
文本侧使用归一化编辑相似度。编辑距离 $d$ 是把一个字符串改成另一个所需的最少插入、删除和替换次数。本文诊断实现定义
$$
s(g,p)=1-\frac{d(g,p)}{\max(|g|,|p|)},\qquad
S_i=\max_{g\in G_i}s(g,p_i)\mathbf{1}[s(g,p_i)>0.5].
$$
$G_i$ 是第 $i$ 题允许的答案集合,长度按统一清理后的字符串计算;先对多参考答案取最佳匹配,再对题目求平均,得到 ANLS。空输出记零。严格边界与 Pix2Struct 的距离阈值形式一致,但本文额外统一空白并处理空串,因此属于显式诊断口径,不能直接冒充官方提交分数。Pix2Struct 指标实现
官方代码阅读路线
先读 ChartQA 仓库的数据结构:人工与机器生成问题分别存放,图片、底层表格、位置标注是不同资源。真实读图实验若把底层表格放进提示词,就改变了输入条件;人工表格适合用作单独的诊断对照。
再按 Qwen-VL 评测说明找到数据集配置与运行入口。不要先替换模型,再猜分数怎样计算。阅读顺序应是问题编号、输入拼接、生成参数、答案截取、指标调用。
本次静态核对 evaluate_vqa.py:relaxed_correctness 的首参数是标准答案,但聚合函数把模型答案放到首位,使非零数值比较按预测值作分母。另一处将零值转入字符串比较,导致数值相等不必然通过。这里说的是当日源码快照,不能据此断言所有版本都如此。
随后追踪 infographicsvqa_eval.py:编辑距离使用清理后的文本,长度却来自原始字符串,并保留相似度恰为一半的结果。这与本文口径不同,必须用边界样本对照。上述源文件已原样保存并记录哈希,实验仅提取评分函数执行,没有加载模型依赖;分支未锁定提交号,后续变化待人工核验。
最小实验与实际结果
入口是 minimal_eval.py,依赖与字段说明见 README。使用 Python 3.12.14 标准库,固定种子 72,生成二十份文档规格,每份包含八字符标识、青色与琥珀色两个数值。规格是结构化真值,没有渲染成图片,也没有交给识别模型。
每份规格构造四题:复制标识、读取青色数值、求两者差、求青色占总量的百分比。前五份组成开发集,其余十五份组成测试集;同文档的题目始终在同一集合。测试共六十题,其中文本十五题、数值四十五题。百分比答案先按题意保留两位小数,之后的扰动作用于这个已固定的标准答案。
在文章目录执行:
python3 -m py_compile code/minimal_eval.py code/audit_protocol.py
python3 code/minimal_eval.py
python3 code/audit_protocol.py
程序打印检查点,保存全部题目、预测、逐题分数和汇总。实际输出来自本次运行,不是示例日志。以下使用本文诊断口径;各列分母不同,不能合并成一个所谓综合准确率。
| 受控输出 |
全题精确匹配,六十题 |
文本 ANLS,十五题 |
数值宽松通过,四十五题 |
| 原样复制标准答案 |
1.000 |
1.000 |
1.000 |
| 数值统一增加百分之四 |
0.250 |
1.000 |
1.000 |
| 数值统一增加百分之六 |
0.250 |
1.000 |
0.000 |
| 四类定向错误 |
0.000 |
0.875 |
0.000 |
| 全部添加解释性前缀 |
0.000 |
0.000 |
0.000 |
四类错误分别是标识末位替换、读取另一系列、减法改成加法、百分数丢掉百分号。所有输出都是人为注入:满分行只证明正对照接通。百分之四组的数值精确通过率为零,却被宽松指标全部接受;八字符标识错一位仍得 0.875,说明相似度不等于标识有效。
独立审计重建了八十个标准答案、复核二百二十五条数值评分,并用九百六十一对短字符串比较两种编辑距离算法。缺失、重复、额外编号均被拒绝,重排输出不改变结果。
源码边界测试也实际通过:标准值一百、预测 105.2 时,按标准值分母拒绝,快照聚合函数接受;预测九十五则相反。标准字符串 0 与预测 0.0 在快照中不匹配。ANLS 独立入口对 abcd 和尾随十六个空格的 abxx 给出 0.9。注意上游生成脚本会先去掉尾部空白,该反例不能直接证明完整推理链也有同样表现。完整反例与结果
评测协议与数据构造
真实实验先冻结数据版本、文档划分和答案规范,再运行模型。最小记录应包含文档编号、图片校验值、问题、答案集合、单位、证据位置、操作类型及原始输出。题目编号必须稳定;同一图的裁剪版、压缩版和不同问题不能跨训练与测试泄漏。
本次规格验证了取值、差值和比例的真值生成逻辑。扩展为图像测试时,应把同一规格变成不同字号、分辨率和图例布局,每次只改变一个因素;同时人工复核图像确实表达了规格里的数值。清晰原图与低分辨率图组成配对样本,不应被当作独立文档扩充分母。这部分尚未执行,待人工核验。
设置三个输入条件:仅图片与问题、外部 OCR 加图片、人工校正表格加问题。第三项是给定正确中间信息的对照,不能作为端到端成绩。如果加入表格后仍错,才进一步检查运算和表达;若只在小字条件下降,也需要排除裁剪丢失和图像预处理差异。
所有条件固定提示词、权重、解码参数和输出预算。本文数值解析只接受单个有限十进制数及可选百分号,允许 50% 与 0.5 数值等价,不会删单位或从解释段落捞出一个数字。真实任务必须先规定回答单位,单位感知评分应另列,不能看到输出后临时改变解析规则。
报告同时保留官方口径与诊断口径、人工问题与自动问题、复制与运算子集。请求失败应保留为显式失败,不可悄悄缩小分母;置信区间宜按文档重采样。本文是确定性构造反例,没有做模型抽样或置信区间估计。
失败排查与证据边界
先查输入证据,再查中间绑定与运算,最后查输出解析。小字误识应观察对应区域;图例错配要核对颜色与系列;算术错要保存操作数;格式失败则比较原始答案与解析结果。仅凭最终一句话,通常不能唯一确定错误发生在哪一层。
作者推断:人工表格对照有助于定位感知瓶颈,但改变输入后也改变了任务难度,分数差不能机械地解释为纯 OCR 损失。模型生成的推理文字同样不是内部执行过程的证明,最好要求可重算的中间数值与独立证据。
本次故障标签来自注入程序,不是从真实预测自动识别出来的。真实字体、中文、曲线插值、多页文档、预训练污染及显存开销均未验证;原始数据集和权重未下载。官方完整推理、当前依赖兼容性及真实基准分数待人工核验。
后续科研问题
第一个问题是评分口径的敏感性:在固定真实输出上重算不同分母和边界,究竟影响多少题,模型排序是否变化?必须保留原始输出并按文档配对分析,本文反例只证明存在差异,不能估计普遍程度。
第二个问题是分辨率收益来自哪里:保持问题与解码预算不变,比较复制题、颜色绑定题和计算题的变化。如果提升只集中在字符识别,就不应概括为逻辑推理增强。
第三个问题是如何要求可验证证据:让模型同时给出读到的系列、操作数与答案,分别检查证据正确率和计算一致性。输出格式本身可能增加失败,因此需要与仅答结果的基线配对,测量收益和额外代价。
总结
读图评测首先是一项测量工作。明确输入条件、保存原始答案、审计评分边界,再用受控干预定位失败,才能把一张分数表转化为可靠的科研问题。这个最小实验提供的是可执行的协议检查起点;它不证明任何 VLM 已经具备读图能力。
参考资料
以下一手链接均于 2026-09-13 实际打开。源码为当日浮动分支,两个 Qwen-VL 文件另有本地哈希快照;DocVQA 全文访问失败,仅使用可访问的版本页支持题名与研究范围。
- Ahmed Masry、Do Xuan Long、Jia Qing Tan、Shafiq Joty、Enamul Hoque,2022,ChartQA: A Benchmark for Question Answering about Charts with Visual and Logical Reasoning。出版页;论文全文。
- Minesh Mathew、Dimosthenis Karatzas、C. V. Jawahar,2020/2021,DocVQA: A Dataset for VQA on Document Images。arXiv 第三版记录。
- ChartQA 作者团队,官方数据与代码仓库,main。
- Qwen-VL 团队,评测说明、VQA 入口、仓库收录的文档评分器,master。
- Pix2Struct 作者团队,指标源码,main,用于核对严格距离阈值。
Companion Code
配套示例代码
与正文对应的最小实现,可下载到本地运行,也可以展开后直接对照阅读。
展开查看完整源码minimal_eval.py · 195 行
"""CPU evaluation-protocol experiment; NO image/OCR/VLM inference.

Python >=3.10, standard library only. Synthetic predictions are fault injections.
The local metrics are explicit diagnostic policies, not official submissions.
"""
import argparse
from collections import defaultdict
from decimal import Decimal, InvalidOperation
import json
from pathlib import Path
import random
import re
import sys

ROOT = Path(__file__).resolve().parent


def normalize(s):
    return " ".join(s.lower().split())


def distance(a, b):
    row = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        new = [i]
        for j, y in enumerate(b, 1):
            new.append(min(new[-1] + 1, row[j] + 1, row[j - 1] + (x != y)))
        row = new
    return row[-1]


def anls(golds, pred):
    """Normalized strings, strict distance < .5; empty prediction is failure."""
    p = normalize(pred)
    if not p:
        return 0.0
    scores = []
    for gold in golds:
        g = normalize(gold)
        n = max(len(g), len(p))
        d = distance(g, p)
        scores.append(1 - d / n if 2 * d < n else 0.0)
    return max(scores)


def number(text):
    """Only one finite decimal, optionally %. No unit deletion/regex extraction."""
    s = text.strip()
    if not re.fullmatch(r"[+-]?(?:\d+(?:\.\d*)?|\.\d+)%?", s):
        return None
    try:
        return Decimal(s.rstrip("%")) / (100 if s.endswith("%") else 1)
    except InvalidOperation:
        return None


def numeric(golds, pred, tolerance="0.05"):
    p = number(pred)
    if p is None:
        return 0.0
    for gold in golds:
        g = number(gold)
        if g is None:
            raise ValueError("Non-numeric gold in numeric task")
        if abs(p - g) <= Decimal(tolerance) * abs(g):
            return 1.0
    return 0.0


def generate(seed=72):
    """Twenty synthetic document SPECS, not raster images; split by document."""
    rng = random.Random(seed)
    records = []
    for doc in range(20):
        a, b = rng.randrange(120, 201), rng.randrange(20, 81)
        doc_id = f"doc_{doc:02d}"
        split = "dev" if doc < 5 else "test"
        identifier = f"AB{rng.randrange(100000, 1000000)}"
        spec = {"identifier": identifier, "series": {"cyan": a, "amber": b},
                "unit": "count", "percent_question_unit": "percent"}
        questions = [
            ("ocr", "Copy the document identifier.", identifier, identifier[:-1] + ("0" if identifier[-1] != "0" else "1"), "character_substitution"),
            ("lookup", "What is the cyan value?", str(a), str(b), "series_binding"),
            ("difference", "What is cyan minus amber?", str(a-b), str(a+b), "operator_swap"),
            ("percentage", "Cyan as a percent of total? Round to two decimals.",
             f"{100*a/(a+b):.2f}%", f"{100*a/(a+b):.2f}", "percent_unit_drop"),
        ]
        for task, question, answer, faulty, cause in questions:
            records.append({"question_id": f"{doc_id}_{task}", "doc_id": doc_id,
                            "split": split, "task": task, "question": question,
                            "answers": [answer], "spec": spec,
                            "synthetic_fault_answer": faulty, "injected_cause": cause})
    return records


def predictions(records, mode):
    rows = []
    for r in records:
        g = r["answers"][0]
        if mode == "gold_fixture":
            p = g
        elif mode == "mixed_faults":
            p = r["synthetic_fault_answer"]
        elif mode == "format_prefix":
            p = "The answer is " + g
        else:
            factor = Decimal("1.04" if mode == "numeric_4pct" else "1.06")
            p = g if r["task"] == "ocr" else format(number(g) * factor, "f")
        rows.append({"question_id": r["question_id"], "answer": p,
                     "provenance": "synthetic_fault_injection", "mode": mode})
    return rows


def evaluate(records, predictions_):
    if not records:
        raise ValueError("Empty evaluation set")
    ids = [r["question_id"] for r in records]
    pids = [p["question_id"] for p in predictions_]
    if len(set(ids)) != len(ids) or len(set(pids)) != len(pids):
        raise ValueError("Duplicate question_id")
    if set(ids) != set(pids):
        raise ValueError("Missing or extra predictions; never silently drop failures")
    if any(not isinstance(p["answer"], str) for p in predictions_):
        raise ValueError("Answers must be strings")
    lookup = {p["question_id"]: p["answer"] for p in predictions_}
    totals = defaultdict(list)
    output = []
    for r in records:
        p = lookup[r["question_id"]]
        em = float(any(normalize(p) == normalize(g) for g in r["answers"]))
        totals["exact_match_all"].append(em)
        row = {"question_id": r["question_id"], "task": r["task"],
               "answers": r["answers"], "prediction": p, "exact_match": em}
        if r["task"] == "ocr":
            score = anls(r["answers"], p)
            row["anls"] = score
            totals["anls_ocr"].append(score)
        else:
            row["relaxed"] = numeric(r["answers"], p)
            row["numeric_exact"] = numeric(r["answers"], p, "0")
            totals["relaxed_numeric"].append(row["relaxed"])
            totals["numeric_exact"].append(row["numeric_exact"])
        output.append(row)
    summary = {k: {"mean": sum(v)/len(v), "n": len(v)} for k, v in totals.items()}
    return summary, output


def dump(path, obj):
    path.write_text(json.dumps(obj, ensure_ascii=False, indent=2, allow_nan=False) + "\n")


def read_jsonl(path):
    return [json.loads(line) for line in Path(path).read_text().splitlines() if line.strip()]


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--out", type=Path, default=ROOT / "results")
    parser.add_argument("--gold", type=Path, help="External gold JSONL using the same schema")
    parser.add_argument("--predictions", type=Path, help="External predictions JSONL")
    args = parser.parse_args()
    args.out.mkdir(parents=True, exist_ok=True)
    if bool(args.gold) != bool(args.predictions):
        parser.error("--gold and --predictions must be supplied together")
    if args.gold:
        summary, rows = evaluate(read_jsonl(args.gold), read_jsonl(args.predictions))
        dump(args.out / "external_summary.json", summary)
        dump(args.out / "external_rows.json", rows)
        print(json.dumps(summary, indent=2))
        return
    records = generate()
    dev_docs = {r["doc_id"] for r in records if r["split"] == "dev"}
    test_docs = {r["doc_id"] for r in records if r["split"] == "test"}
    assert not dev_docs & test_docs
    for split in ["dev", "test"]:
        subset = [r for r in records if r["split"] == split]
        (args.out / f"{split}.jsonl").write_text("".join(json.dumps(r) + "\n" for r in subset))
    test = [r for r in records if r["split"] == "test"]
    report = {"python": sys.version, "seed": 72, "model_executed": False,
              "data": {"specs": 20, "dev_questions": 20, "test_questions": 60,
                       "numeric_test_questions": 45, "ocr_test_questions": 15}, "modes": {}}
    for mode in ["gold_fixture", "numeric_4pct", "numeric_6pct", "mixed_faults", "format_prefix"]:
        preds = predictions(test, mode)
        summary, rows = evaluate(test, preds)
        report["modes"][mode] = summary
        dump(args.out / f"{mode}_rows.json", rows)
        (args.out / f"{mode}_predictions.jsonl").write_text("".join(json.dumps(r)+"\n" for r in preds))
    dump(args.out / "summary.json", report)
    print("CHECKPOINT seed=72 spec_shape=(20,2) test_records=60 OCR=15 numeric=45")
    print("No images, OCR system, neural model, or benchmark evaluation executed.")
    print(json.dumps(report, indent=2))


if __name__ == "__main__":
    main()