面向研究生、科研新人和工程型研究者;檢索與實驗日期:2026-09-16。
摘要
把知識圖譜接到大語言模型之前,先問一個小問題:檢索到了答案實體,是否也保留了支持答案的路徑?本文閱讀 G-Retriever 官方實現,再訓練一個十參數的圖神經網絡,比較完整結構、反向邊和不同證據裁剪方法。三個種子的實際結果顯示,答案節點召回很高,證據閱讀仍可能失敗。實驗只驗證圖消息傳遞與證據接口,沒有運行真實語言模型,也沒有復現論文榜單。
目錄
- 復現價值:區分節點、路徑和回答
- 核心思想與公式
- 官方代碼閱讀路線
- 最小實驗與實際結果
- 評測協議與獨立審計
- 失敗排查與證據邊界
- 後續科研問題
- 總結與參考資料
復現價值:區分節點、路徑和回答
圖神經網絡,即 GNN,通過邊傳遞並聚合節點信息;大語言模型,即 LLM,處理文本及其向量表示。兩者結合時,圖可以提供關係結構,語言模型可以解釋問題和生成回答,但接口接通不代表推理可靠。節點名字相似、答案實體入選、完整證據路徑存在,是三個不同條件。
設問題要求從甲出發,先沿“合作”再沿“任職”關係尋找終點。只給模型甲和終點的名字,中間人物及兩條有向邊可能已經丟失。此時回答正確,可能來自參數記憶;回答錯誤,也不能立刻歸咎於語言推理能力。復現的價值,是把這些可能性拆成可檢查的輸入輸出。
論文報告:Yasunaga 等人的 QA-GNN 在問答語境與知識圖譜之間建立聯合圖,並通過消息傳遞更新表示,發表於二〇二一年 NAACL。它是語言模型與圖聯合推理的前驅,不等於今天的生成式聊天模型。論文頁面
He 等人的 G-Retriever 面向帶文本屬性的圖,結合子圖檢索、圖編碼和語言生成。本文使用二〇二四年五月修訂的預印本第三版;官方倉庫給出的會議歸屬是同年 NeurIPS。這裡不引用跨版本成績,也不宣稱檢索能消除全部幻覺。版本頁;官方說明
核心思想與公式
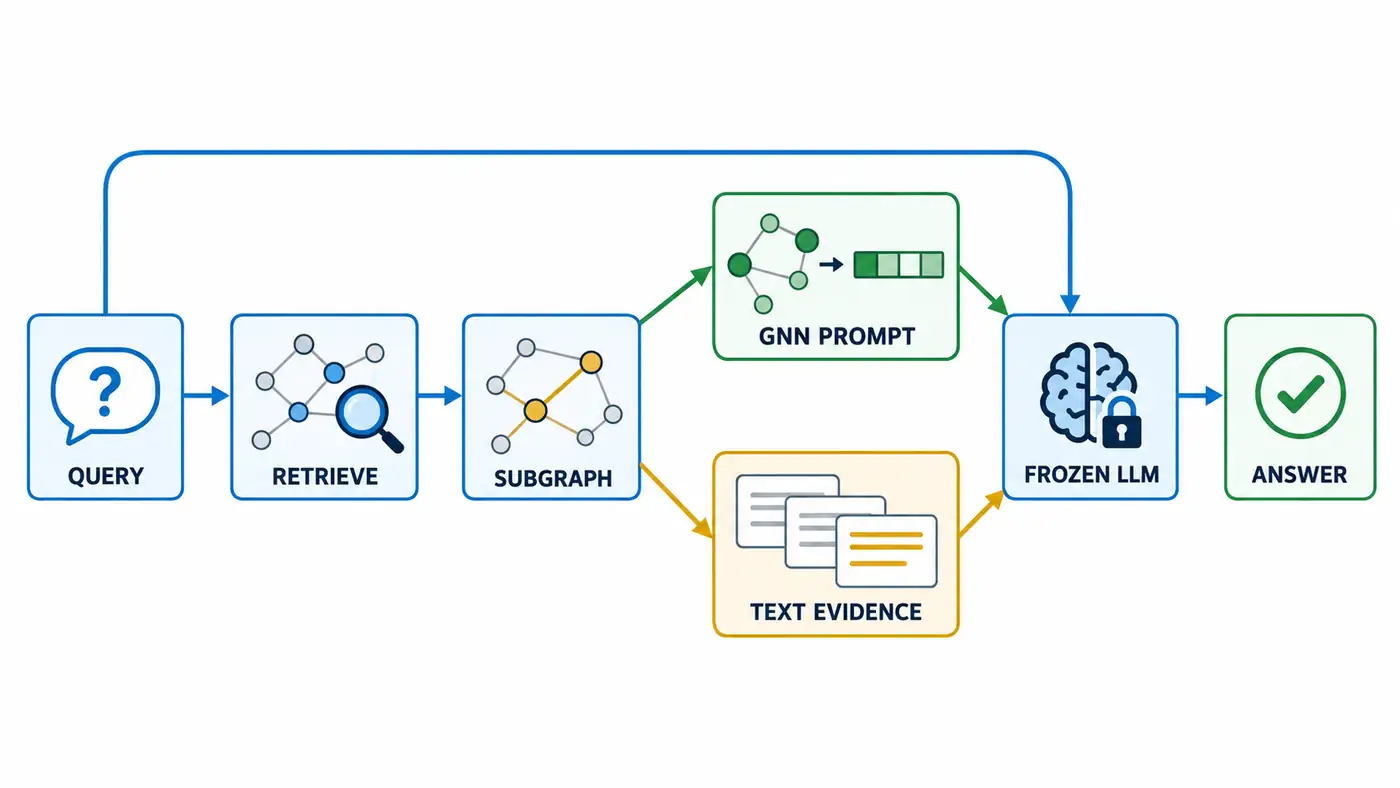
方法圖表示原方法的凍結語言模型配置:同一子圖分別形成圖軟提示和文本證據,問題也送入語言模型。軟提示是連續向量,不是人工編寫的句子。圖中鎖只表示語言模型參數凍結,圖編碼器和投影器仍可學習;這張圖不是下方玩具實驗的運行截圖。
原方法將相關性與連通成本結合,用帶獎賞的斯坦納樹問題選擇子圖。通俗地說,高相關節點值得保留,但連接它們也有代價,因此不能把檢索理解成獨立選出幾個實體。隨後圖表示經投影進入語言模型的詞向量空間,文本化的節點與邊提供另一條證據通路。論文全文
為了隔離結構問題,本次採用兩層關係門控消息傳遞:
每張圖有十二個節點, 是形狀為 的有向鄰接矩陣,行表示起點、列表示終點; 是源節點獨熱行向量。問題給出有序關係 ,兩個 都是 的可訓練參數。每層按問題關係混合兩類邊;兩層後的 是十二維加權路徑計數,沒有度數歸一化。
是節點屬於答案集合的未歸一化分數, 表示是否存在符合順序的兩跳路徑, 為圖數、。標量 加上八個門控參數,共十個參數。實現使用穩定的對數加法計算二元交叉熵;一個問題可以有多個答案,也可以沒有答案,不能用單標籤分類替代。
官方代碼閱讀路線
先讀數據,再讀模型,最後讀訓練循環,避免只看架構名稱。
第一站是 webqsp.py。核對樣本里的問題、答案、緩存圖和文本描述如何按索引對應。訓練、驗證、測試拼接後依靠保存的索引劃分,復現者必須檢查緩存生成順序是否一致;拼接本身不是洩漏證據。
第二站是 retrieval.py。節點相似度被轉換為排名獎賞,邊還涉及虛擬節點轉換;返回時會把原節點編號重新映射到局部編號。應同時檢查圖結構和文本描述,防止兩份證據講的是不同實體。修改檢索參數後也要重新生成緩存。
第三站對照 gnn.py 與 graph_llm.py。前者包含不同圖編碼器,不能假設每種實現都使用邊屬性;後者對節點表示均值池化、投影,再將一個圖向量與文本嵌入拼接。投影輸出維度寫為四千零九十六,換語言模型前應核對嵌入寬度。描述會截斷,圖裡有證據也不代表文本分支保留了它。
最後檢查 train.py 的梯度清零、優化器步進和驗證選模。當前代碼每個批次都清零並步進,不能僅憑參數名 grad_steps 就認為實現了梯度累積。以上是靜態源碼核對,未運行官方環境;這些鏈接指向檢索當日的主分支,沒有鎖定提交,後續兼容性待人工核驗。
最小實驗與實際結果
在文章目錄執行:
python3 -m pip install -r code/requirements.txt
python3 code/experiment.py
python3 code/audit_results.py
本次實際使用 Python 3.12.14、NumPy 2.3.5 和 CPU。每個種子生成二百五十六張訓練圖、六十四張驗證圖、一百二十八張測試圖;兩類邊各以概率零點一二獨立採樣,去除自環,源節點和問題關係隨機抽取。三個種子共一千三百四十四張不同的圖,節點編號只在本圖內有效。
訓練使用全批次 Adam,學習率零點零三,固定五百步;驗證損失只記錄,不選檢查點、不調閾值。訓練鄰接張量為 [256,2,12,12],輸出為 [256,12]。種子七十五的訓練損失從零點三五零三降到零點零零零五四一,兩層正確關係門控概率約為零點九八。完整數據、權重、曲線和逐題證據均保存在 code/results/。
本次實際驗證:完整圖上的答案集合完全匹配率,三個種子均為一;凍結權重後反轉全部邊、保持原答案不變,平均完全匹配率降到零點一三零二。移除全部邊時模型輸出空集,仍有零點三三五九的完全匹配率,因為測試集中確實存在空答案。後兩項是輸入損壞診斷,未重新訓練,不能當作公平比較的獨立模型。
接著按節點分數選取前三個候選,比較兩種證據包。“誘導子圖”只保留源節點和候選之間的邊;“橋接保留”保存源節點的全部出邊,以及進入候選的全部邊,允許中間節點留在證據裡。後者不讀取答案標籤,但會攜帶更多三元組。三元組就是“起點、關係、終點”三個字段。
閱讀器是手寫的確定性兩跳遍歷,只能從所給三元組返回候選中的終點。它不是 LLM,也沒有模擬自然語言理解;這使失敗可以定位到證據接口。
| 三候選證據包 | 非空題候選召回 | 答案微平均 F1 | 集合完全匹配率 | 平均三元組數 |
|---|---|---|---|---|
| 誘導子圖 | 0.9312 | 0.1466 | 0.3724 | 2.43 |
| 橋接保留 | 0.9312 | 0.9256 | 0.8646 | 12.10 |
表中都是三個種子的均值。相同候選並不等於相同證據;橋接方案的增益伴隨更大輸入預算,不能寫成同成本優勢。候選增至十二個時,兩種方案都恢復完整圖,閱讀器完全匹配率為一,屬於協議上限檢查。
評測協議與獨立審計
微平均 F1 將全部問題的真正例、假正例和假負例合併計算,適合多答案集合。完全匹配率要求預測集合與答案集合相同,包括空集;候選召回僅對非空題計算,再逐題平均,避免把空題默認記成完美召回。主結果必須同時報告這些分母。
三個種子的波動來自重新採樣圖與初始化,不是置信區間。完整圖高分並不意外:任務只需要兩跳,模型結構恰好覆蓋真實生成規則;它沒有學習實體語義,也沒有證明長路徑泛化。訓練、測試的圖完全不同,仍然共享同一種圖生成分佈。
獨立審計腳本沒有導入訓練腳本,使用標量循環重建全部真值和一萬三千八百二十四個分數,最大差異約為一乘十的負十四次方;又重放三千零七十二條證據記錄,檢查候選排序、邊來源、答案和指標。十個參數的有限差分梯度檢查通過,同時重標節點、源節點和標籤後,預測分數保持一致。排序遇到同分按編號打破,因此不宣稱候選集合在同分時也置換不變。
失敗排查與證據邊界
種子七十五的第零題,從節點三沿兩次關係零到節點十一,完整路徑是“三到五到十一”。前三候選是十一、六、二,答案已經排第一,卻沒有中間節點五;誘導子圖閱讀器因此返回空集。這個案例保存在審計結果中,比一句“檢索效果不佳”更能定位問題。
排查順序應是:關係方向和類型是否正確,節點編號是否對齊,橋接節點是否被裁掉,文本化後是否截斷,最後才檢查生成器。若改成真實 LLM,要單獨保存純證據輸入、生成文本和可驗證引用;保存的本次記錄把 prompt 與評分用 gold 分開,不能將整條評測記錄送進模型。
作者推斷:高節點召回不足以保證證據可用。本次零假正例來自閱讀器只沿真實邊遍歷的設計,不能外推為生成模型沒有幻覺。當前也未運行語義嵌入、斯坦納樹求解、圖軟提示訓練、官方數據集或 GPU;這些完整復現環節均待人工核驗。
後續科研問題
下一步先固定文本證據預算,比較純文本、圖提示、兩者結合,判斷新增收益來自哪裡。再對證據做受控刪邊與同義改寫:前者檢驗結構依賴,後者檢驗語言魯棒性,不能混成一次擾動。最後增加三跳問題、關係組合外推和真實抽圖噪聲,分開報告節點召回、路徑完整率、答案分數與引用正確率。
這些實驗需要重新劃分開發集,並提前凍結模型、預算和評測規則。尤其不要先觀察測試錯誤,再挑最有利的刪邊方式宣佈因果解釋;本次橋接案例是機制診斷,不是證明某個真實語言模型採用了同樣的內部推理。
總結
圖增強推理的最小復現,應同時追蹤候選實體、連接路徑和閱讀器輸入。本文驗證了一個具體失敗機制:節點選對,路徑仍可能被裁斷。先建立這樣的可審計接口,再接入真實 LLM,後續論文復現才有清楚的失敗定位依據。
參考資料
以下一手資料均於 2026-09-16 實際打開;源碼為當日主分支,非固定提交。
- Yasunaga、Ren、Bosselut、Liang、Leskovec,2021:QA-GNN: Reasoning with Language Models and Knowledge Graphs for Question Answering,NAACL。
- He、Tian、Sun、Chawla、Laurent、LeCun、Bresson、Hooi,2024:G-Retriever: Retrieval-Augmented Generation for Textual Graph Understanding and Question Answering,arXiv 第三版;全文。
- G-Retriever 作者倉庫:環境與實驗入口、數據接口、子圖檢索。
- 同一官方實現:圖編碼器、圖與語言接口、訓練與選模。